Il lattiero-caseario incontra il machine learning: una panoramica introduttiva alla previsione dei volumi di scambio con graph neural network e transformer
Gusto in ritardo
Ogni minuto nel mondo si producono circa 22 tonnellate metriche di burro. Il risultato è un panorama commerciale complesso, con oltre 2.300 transazioni registrate ogni mese. Dati i moltissimi usi del burro e i suoi numerosi prodotti derivati, è essenziale che acquirenti, venditori e trader monitorino gli scambi, così da essere informati quando prendono decisioni di business.
Eppure accedere ad analisi in tempo reale è difficile. Per la piena dipendenza dagli enti governativi nella raccolta dei dati, esiste un ritardo notevole. In media servono tre mesi perché tutti i paesi comunichino i propri volumi di scambio.
Il nostro obiettivo? Eliminare del tutto il ritardo di comunicazione. Vogliamo applicare tecnologie all’avanguardia per prevedere gli ultimi tre mesi di volumi di scambio internazionali, colmando di fatto il divario.
Risolvere problemi come questo è al centro di Vesper. Lavoriamo per costruire la piattaforma di commodity intelligence più completa e uniamo dati di qualità e competenza professionale alla Data Science per creare strumenti unici per i nostri utenti.
In questo articolo offriamo una panoramica della nostra implementazione. Cominceremo illustrandovi le dinamiche del mercato del burro, poi introdurremo la nostra nuova rappresentazione del problema con i grafi temporali. Imparerete quindi le basi del nostro modello di machine learning, con un breve riepilogo di ciascuno dei suoi tre componenti fondamentali. E infine daremo uno sguardo ai risultati.
Il burro si spalma su tutto il mondo
Il burro è una delle materie prime più attivamente scambiate del settore lattiero-caseario. Ogni mese decine di migliaia di tonnellate metriche di burro attraversano i confini internazionali. Solo UE, Nuova Zelanda e Stati Uniti hanno spedito in media circa 46.000 mt al mese nel 2022. Queste importazioni ed esportazioni possono andare da semplici frazioni a decine di migliaia di tonnellate metriche.
Il mercato internazionale del burro funziona in gran parte come un oligopolio. I tre produttori dominanti in surplus sono gli Stati Uniti, la Nuova Zelanda e i paesi dell’UE, tutti in concorrenza per la domanda degli altri paesi. Nel 2022 Unione Europea, Nuova Zelanda e Stati Uniti hanno esportato insieme circa 555.000 tonnellate metriche di burro. Mentre altri paesi producono burro sul mercato interno, spesso si rivolgono a uno dei tre grandi attori per la fornitura aggiuntiva.
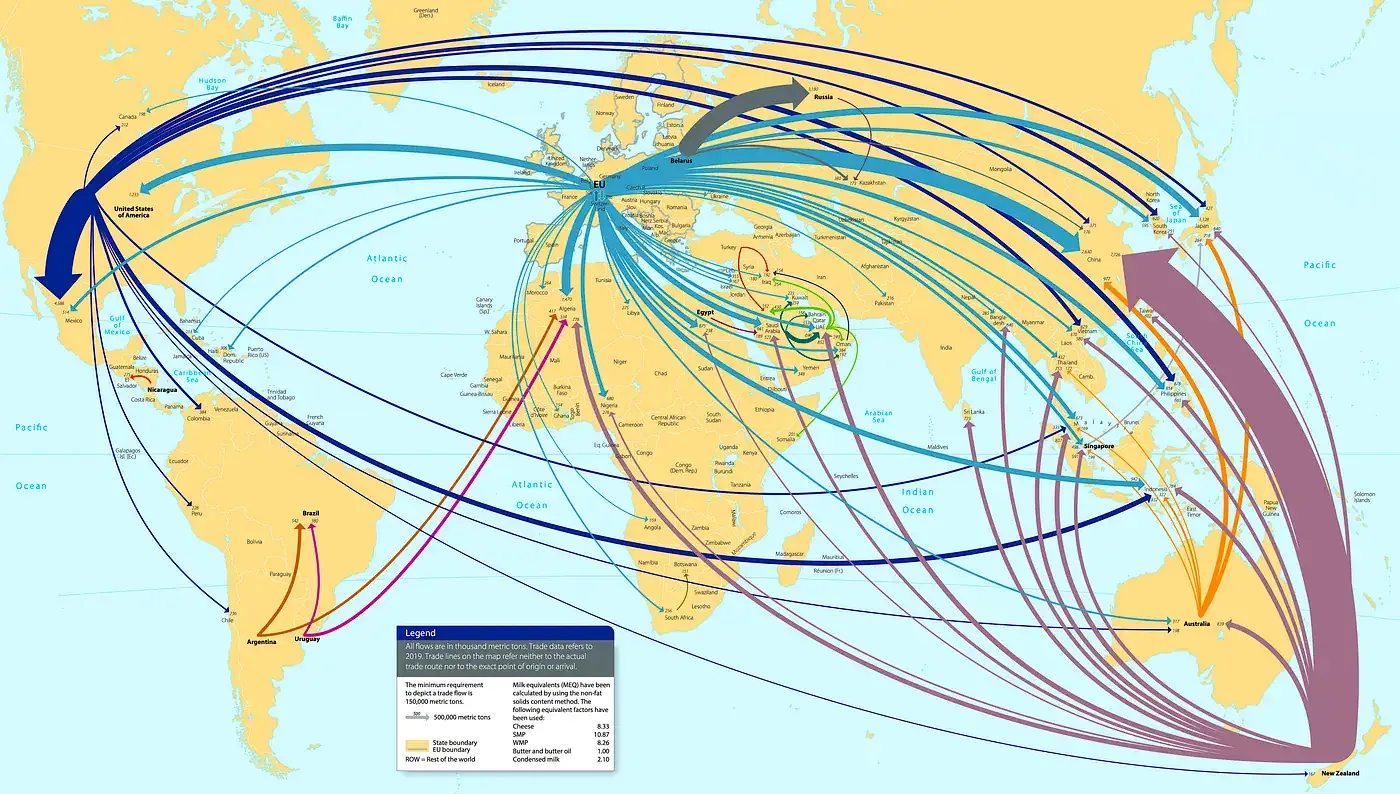
Negli anni molti paesi hanno costruito rotte commerciali solide con questi grandi produttori, grazie ad accordi commerciali e a condizioni geopolitiche favorevoli. Di conseguenza, le interazioni commerciali con questi grandi attori sono in genere costanti per volume e tempistiche. Questo vale in confronto agli scambi di burro fra altre coppie di paesi: questi scambi tendono a essere più sporadici. Sono spesso influenzati da eventi di breve periodo, perciò la loro natura è decisamente più «casuale» e quindi più difficile da prevedere.
Dal punto di vista dell’acquirente, la scelta di quale grande produttore usare come fonte per il burro dipende da molti fattori. Dato che il burro è una materia prima, le differenze sono piccole, se non trascurabili. Perciò il principale fattore decisionale è lo scarto fra i prezzi offerti dai grandi attori, seguito dai dazi e dai costi di trasporto.
Rappresentazione del problema: una vasta rete sociale.
Usiamo i grafi per rappresentare efficacemente le dinamiche del mercato del burro. A differenza delle tabelle standard, che elencano i punti dati separatamente, i grafi mettono in risalto i collegamenti fra di essi e preservano le sfumature preziose di una rete interconnessa. Questo comprende i tipi e la forza delle relazioni fra i punti dati.
Per visualizzare meglio i grafi, pensate alla vostra rete sociale di amici e colleghi. Ogni nodo è una persona e ogni arco rappresenta la vostra relazione con quella persona. Con i grafi possiamo rappresentare tutta la vostra rete sociale, preservando le qualità uniche delle persone come caratteristiche dei nodi e le caratteristiche delle relazioni salvate come attributi degli archi.
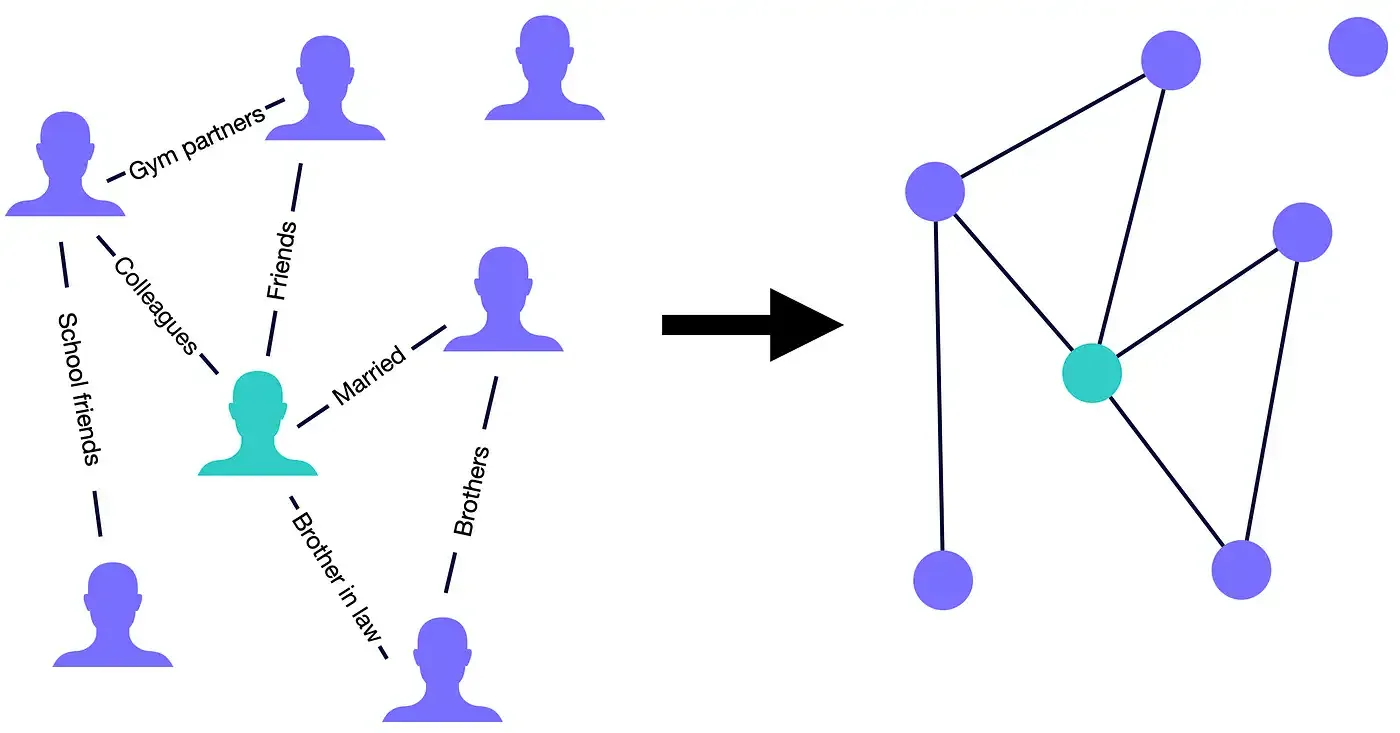
Allo stesso modo, nel nostro scenario usiamo i nodi per simboleggiare i singoli paesi e gli archi per indicare gli eventi commerciali fra di essi. Ogni paese possiede un insieme di qualità distintive chiamate caratteristiche specifiche del paese (memorizzate nei nodi), come la produzione interna di burro o il PIL. Poi ci sono caratteristiche esclusive della coppia di paesi, chiamate attributi specifici della coppia (salvati negli archi), come il volume di scambio o il tasso di cambio vigente fra le rispettive valute.
Per creare il grafo usiamo tutti i nostri dati di import-export disponibili da gennaio 2015 in avanti. Per prima cosa inseriamo i 242 nodi disponibili, uno per ogni «paese». Poi selezioniamo tutti gli scambi registrati in quella finestra temporale. Il risultato è un impressionante totale di 267.376 archi.
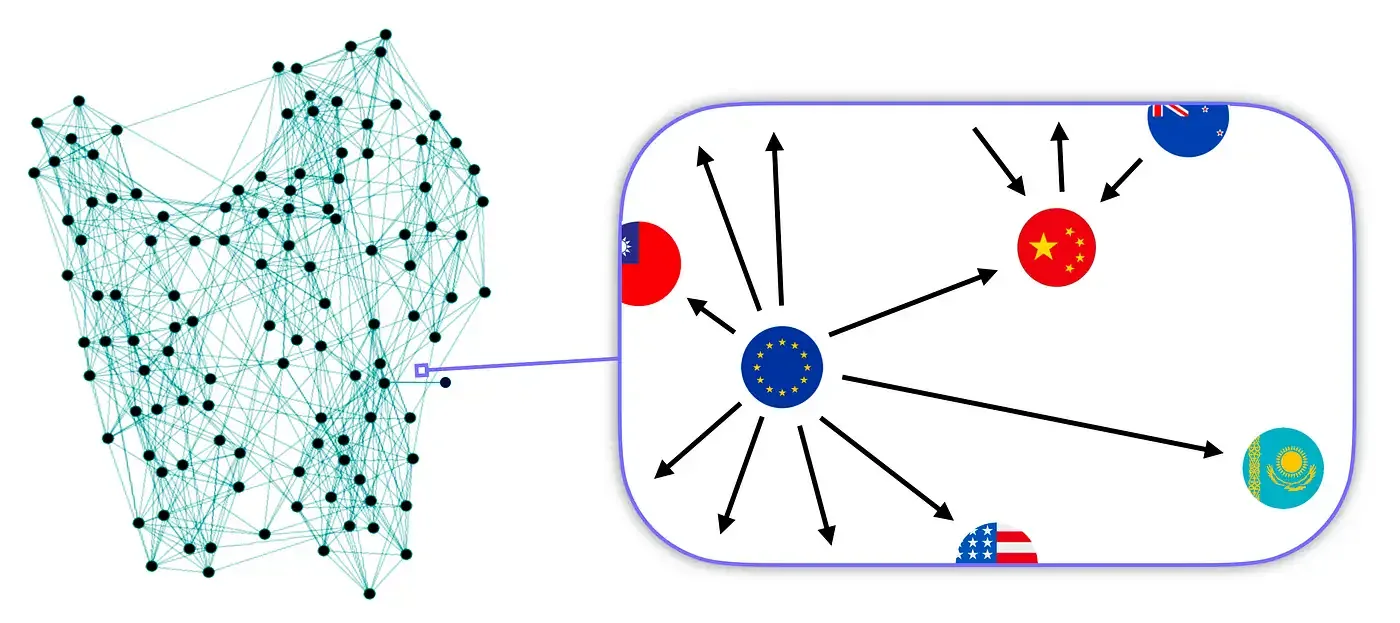
Per studiare meglio il problema, segmentiamo i dati su base mensile. Ne risulta una sequenza di grafi più leggeri con circa 2.000 archi: questi grafi fanno da istantanea dello stato mensile del mercato. Possiamo interpretare questa sequenza storica di grafi come una serie di dati generale che raggruppa le serie storiche di molti singoli punti. Una serie storica è un insieme di misurazioni di una singola variabile nel tempo, per esempio il volume di scambio fra una sola coppia di paesi.
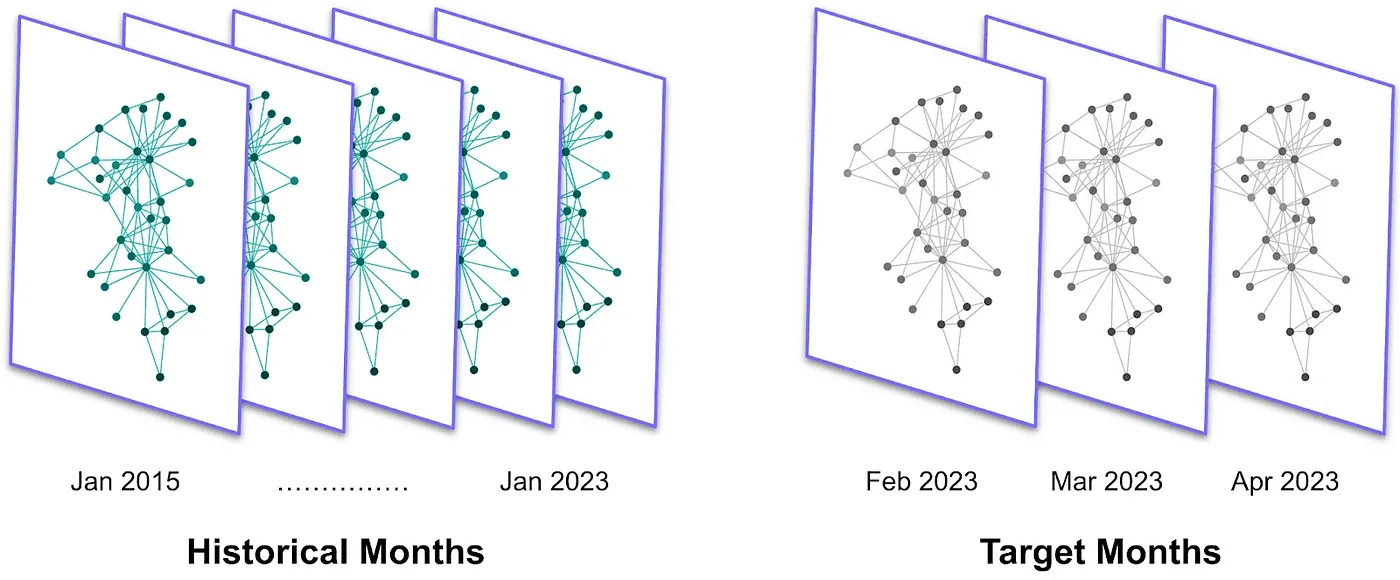
Il vantaggio chiave della nostra rappresentazione basata sui grafi è la capacità di cogliere tendenze su scala mondiale. Raggruppando tutte le coppie di paesi in un’unica struttura, possiamo studiare più rotte contemporaneamente. Le tecniche di previsione standard, al contrario, possono gestire una sola serie di dati per volta.
Inoltre, poiché tutte le altre variabili che ci interessano (caratteristiche specifiche del paese e attributi specifici della coppia) non soffrono di un ritardo così lungo, possiamo già creare i grafi per i tre mesi più recenti che vogliamo prevedere, chiamati mesi target. Con questa sequenza storica di grafi siamo pronti a sviluppare il nostro modello di machine learning.
Prevedere i volumi di scambio con il machine learning
Per il nostro problema implementeremo un approccio che rientra nell’apprendimento supervisionato. Per prima cosa addestriamo il modello fornendogli sia i dati delle caratteristiche sia la variabile target.
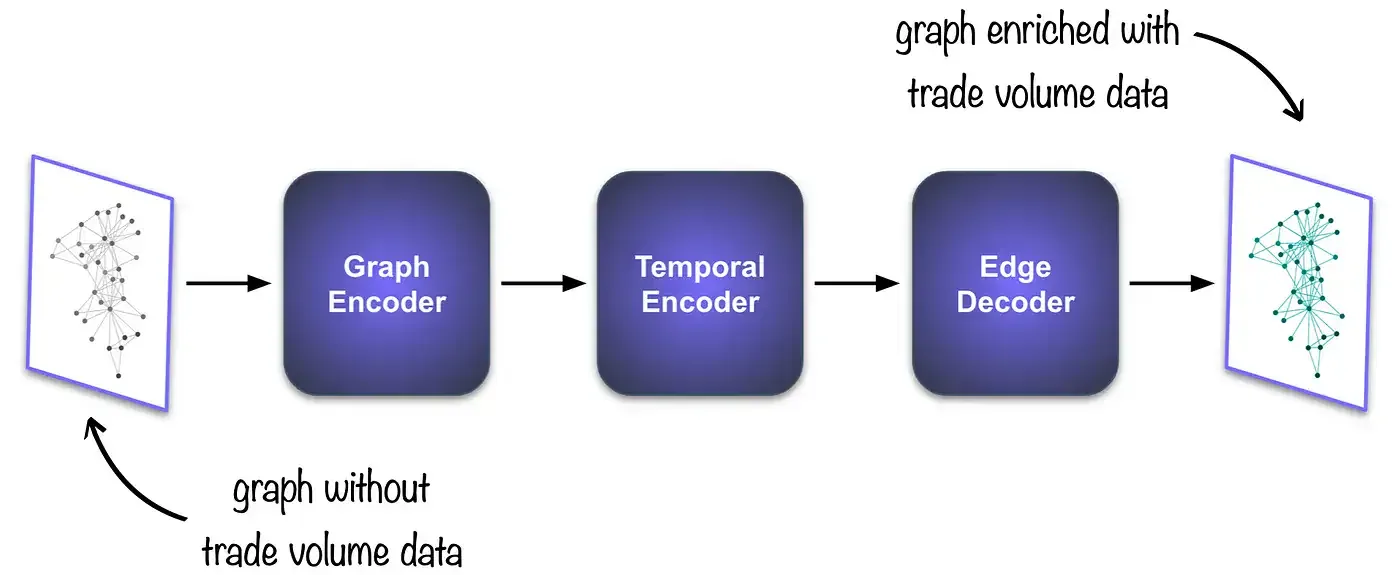
Dopo aver addestrato il modello su mesi storici, gli daremo in ingresso un’istantanea mensile dei mesi target, che contiene tutte le caratteristiche specifiche del paese e gli attributi specifici della coppia ma è priva dei dati sui volumi di scambio. Il modello la elaborerà e poi, in base agli schemi appresi durante l’addestramento, produrrà i volumi di scambio previsti per ogni coppia di paesi.
Conosciuto l’approccio generale, scomponiamo il nostro modello nei suoi componenti. Poi discuteremo i risultati. I componenti chiave del nostro modello sono:
- Graph Encoder: per condensare il singolo grafo in un formato leggibile dalla macchina chiamato embedding.
- Temporal Encoder: per estrarre le relazioni temporali dagli embedding mensili precedenti.
- Edge Decoder: per tradurre gli embedding in previsioni dei volumi di scambio.
Graph Encoder: di nuovo alle reti sociali.
Per questo componente ci interessa trasformare in modo efficiente tutti i dati conservati nel grafo in una lista di numeri. Per via delle differenze di forma, una certa perdita di informazione è inevitabile. Il nostro obiettivo è ridurla al minimo.
Impieghiamo una Graph Neural Network (GNN). Le GNN sono capaci di combinare informazioni dal singolo nodo, dal suo vicinato e dagli attributi degli archi. È come il detto secondo cui una persona si definisce al meglio attraverso i suoi amici più stretti. L’output della GNN si chiama node embedding.
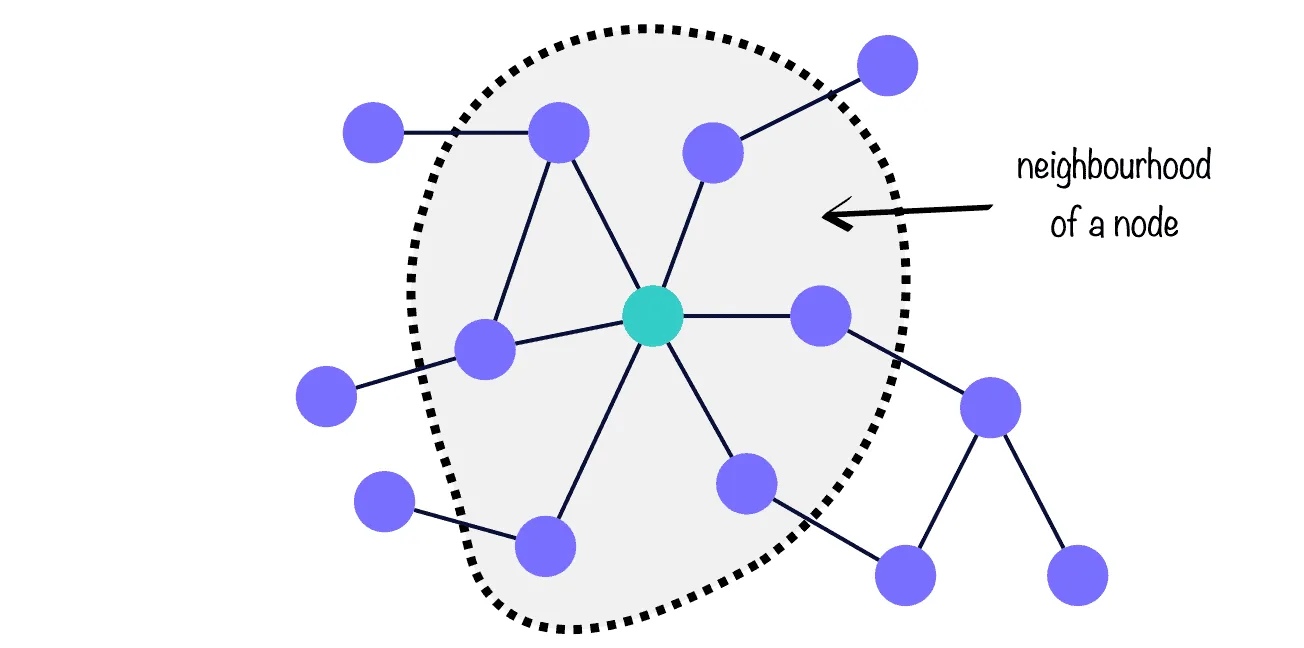
E proprio come nelle nostre reti sociali, dove alcuni amici hanno su di noi più influenza di altri, lo stesso vale per i nodi di un grafo. Nel gergo delle GNN questo si chiama attention, e lo usiamo nel nostro modello per classificare quali rotte commerciali siano più informative per prevedere le altre.
Temporal Encoder: ispirato a ChatGPT
Questa unità impara come un determinato mese si relaziona ai suoi predecessori. L’idea è che le condizioni di mercato di un mese siano influenzate dallo stato del mercato dei mesi precedenti. Impieghiamo il Transformer, un’architettura all’avanguardia che sta alla base dei modelli linguistici come ChatGPT, per la sua capacità di fare previsioni «sequence-to-sequence».
Immaginate uno scenario di previsione della digitazione. Data una frase (una sequenza di parole), il Transformer capisce l’ordine delle parole e la loro importanza nel trasmettere il messaggio, il tutto in relazione al contesto generale della frase. Poi produce in uscita la parola con la probabilità più alta di essere la successiva nella sequenza.
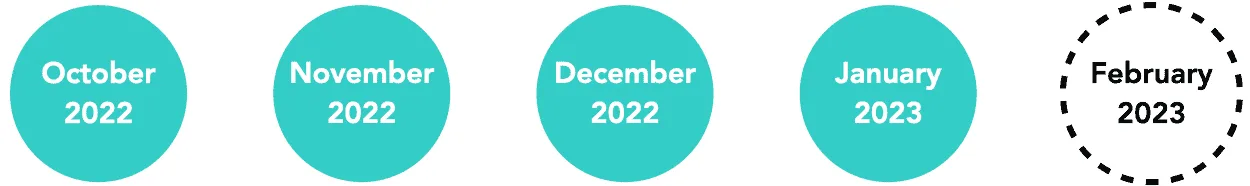
Applichiamo con intelligenza questa struttura al nostro problema: ogni istantanea mensile è trattata come una parola e il Transformer produce i node embedding più probabili per il mese successivo nella sequenza.
Edge Decoder: dare un senso ai node embedding.
Lo scopo di questo componente si può vedere come l’inverso del Graph Encoder. Invece di creare embedding, decifra gli embedding che riceve dal Temporal Encoder trasformandoli in previsioni della variabile target. Implementiamo due reti neurali e ci diamo l’obiettivo di prendere coppie di embedding ed estrarne un singolo numero: la previsione del volume di scambio fra due paesi.
Il risultato è un’unità in grado di ricostruire il volume di scambio per ogni coppia di paesi all’interno del grafo per il mese di interesse. Perciò, migliore è l’Edge Decoder, più le previsioni saranno vicine ai valori reali.
I risultati
Per valutare le prestazioni del nostro modello prendiamo i tre mesi più recenti (con dati sui volumi di scambio disponibili) e li diamo in ingresso al modello. Poi confrontiamo le previsioni con i valori reali. Per rendere valido il test, questi tre mesi non li abbiamo mai mostrati al modello.
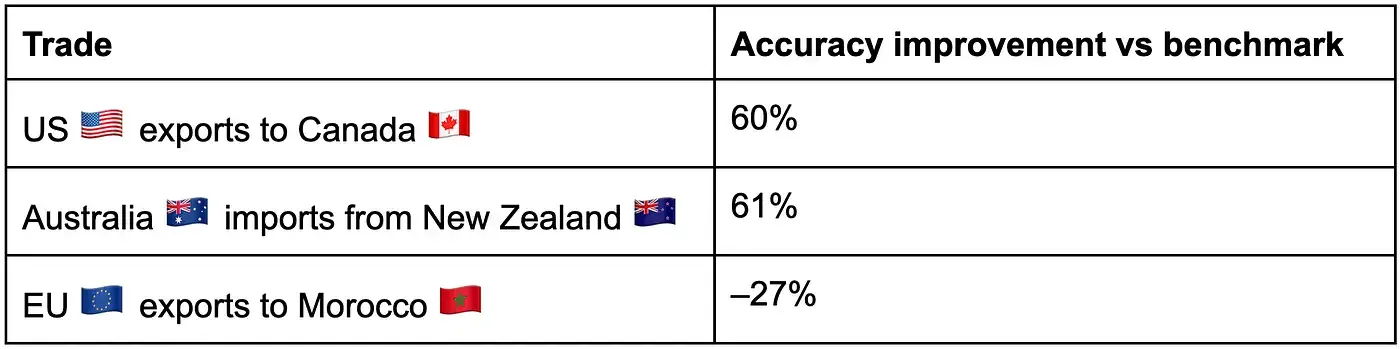
Il modello eccelle nel prevedere quando non avviene alcuno scambio fra due paesi. Se la cava bene anche nel prevedere quando i volumi di scambio sono eccezionalmente alti. Questo potrebbe essere dovuto proprio alla dimensione dei volumi di scambio, che si discostano in modo marcato dal valore medio dei dati e perciò sono facilmente riconoscibili dal modello.
Curiosamente, fatica con i volumi di scambio medi. Quando confrontiamo le nostre previsioni con i metodi tradizionali di previsione delle serie storiche, diventa chiaro che, per aumentare l’accuratezza del nostro modello, dobbiamo agevolare la distinzione fra rotte commerciali medie più simili fra loro. Questo si può ottenere incorporando più caratteristiche dei dati utili a creare una rappresentazione del mercato più ricca, e includendo informazioni commerciali su altre materie prime.
Alla luce di queste considerazioni, il miglioramento medio del nostro modello su tutte le rotte commerciali è trascurabile ed è più informativo studiare le singole coppie. Qui sotto trovate le prestazioni del nostro modello su due rotte con volumi scambiati molto alti e su una media. Come vedete, i risultati sono molto diversi.