Les produits laitiers rencontrent le machine learning : un aperçu accessible de la prévision des volumes échangés à l’aide de réseaux de neurones en graphes et de transformers
Un goût différé
Chaque minute, environ 22 tonnes de beurre sont produites dans le monde. Il en résulte un paysage commercial complexe, avec plus de 2 300 transactions enregistrées chaque mois. Compte tenu des multiples usages du beurre et des nombreux produits qui en dérivent, il est essentiel pour les acheteurs, les vendeurs et les traders de suivre les échanges, afin d’être informés au moment de prendre leurs décisions commerciales.
Pourtant, l’accès à des analyses en temps réel reste un défi. Comme la collecte des données repose entièrement sur les organismes publics, un décalage notable existe. En moyenne, il faut trois mois pour que tous les pays déclarent leurs volumes échangés.
Notre objectif ? Supprimer entièrement le délai de déclaration. Nous entendons mettre en œuvre des technologies de pointe pour prévoir les trois derniers mois de volumes du commerce international, et ainsi combler l’écart.
Résoudre ce type de problèmes est au cœur de Vesper. Nous nous efforçons de construire la plateforme de veille sur les matières premières la plus complète, et nous associons des données de qualité et une expertise professionnelle à la Data Science pour produire des outils uniques pour nos utilisateurs.
Dans cet article, nous donnons un aperçu de notre mise en œuvre. Nous commencerons par parcourir avec vous la dynamique du marché du beurre, puis nous présenterons notre nouvelle représentation du problème à l’aide de graphes temporels. Vous découvrirez ensuite les bases de notre modèle de machine learning, avec un bref résumé de chacun de ses trois composants essentiels. Enfin, nous apporterons un éclairage sur les résultats.
Le beurre s’étale sur toute la planète
Le beurre est l’une des matières premières les plus activement échangées du secteur laitier. Chaque mois, des dizaines de milliers de tonnes de beurre franchissent les frontières internationales. À eux seuls, l’UE, la Nouvelle-Zélande et les États-Unis ont expédié en moyenne environ 46 000 tonnes par mois en 2022. Ces importations et exportations peuvent aller de simples fractions à des dizaines de milliers de tonnes.
Le marché international du beurre fonctionne en grande partie comme un oligopole. Les trois producteurs excédentaires dominants sont les États-Unis, la Nouvelle-Zélande et les pays de l’UE, tous en concurrence pour la demande des autres pays. En 2022, l’Union européenne, la Nouvelle-Zélande et les États-Unis ont exporté ensemble environ 555 000 tonnes de beurre. Si d’autres pays produisent du beurre sur leur marché intérieur, ils se tournent souvent vers l’un des trois grands acteurs pour un approvisionnement complémentaire.
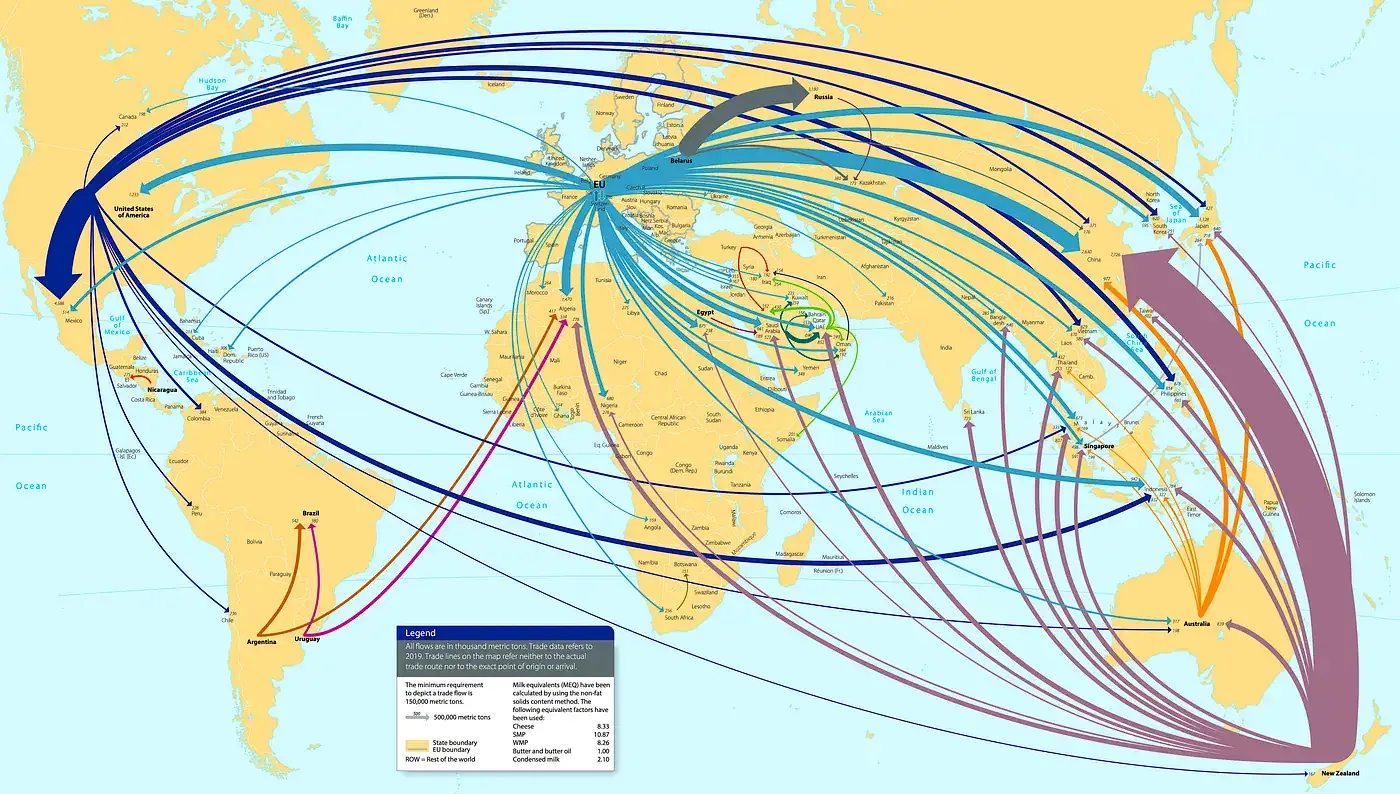
Au fil des ans, de nombreux pays ont établi des routes commerciales solides avec ces grands producteurs, grâce à des accords commerciaux et à des conditions géopolitiques favorables. Par conséquent, les échanges avec ces grands acteurs sont généralement réguliers en volume et dans le temps. Cela vaut par comparaison avec les échanges de beurre entre d’autres paires de pays, qui ont tendance à être plus sporadiques. Souvent influencés par des événements de court terme, ils sont de nature considérablement plus « aléatoire » et donc plus difficiles à prévoir.
Du point de vue d’un acheteur, le choix du grand producteur auprès duquel s’approvisionner en beurre dépend de nombreux facteurs. Le beurre étant une matière première, les différences sont faibles, voire négligeables. Le principal facteur de décision est donc l’écart entre les prix proposés par les grands acteurs, suivi des droits de douane et des coûts de transport.
Représentation du problème : un vaste réseau social.
Nous utilisons des graphes pour représenter efficacement la dynamique du marché des échanges de beurre. Contrairement aux tableaux classiques, qui répertorient les points de données séparément, les graphes mettent l’accent sur les liens entre ces points et préservent les nuances précieuses d’un réseau interconnecté. Cela inclut les types et l’intensité des relations entre les points de données.
Pour mieux visualiser les graphes, pensez à votre réseau social d’amis et de collègues. Chaque nœud est une personne, et chaque arête représente votre relation avec cette personne. Grâce aux graphes, nous pouvons représenter l’intégralité de votre réseau social, en conservant les qualités uniques des personnes sous forme de caractéristiques des nœuds et les caractéristiques des relations sous forme d’attributs des arêtes.
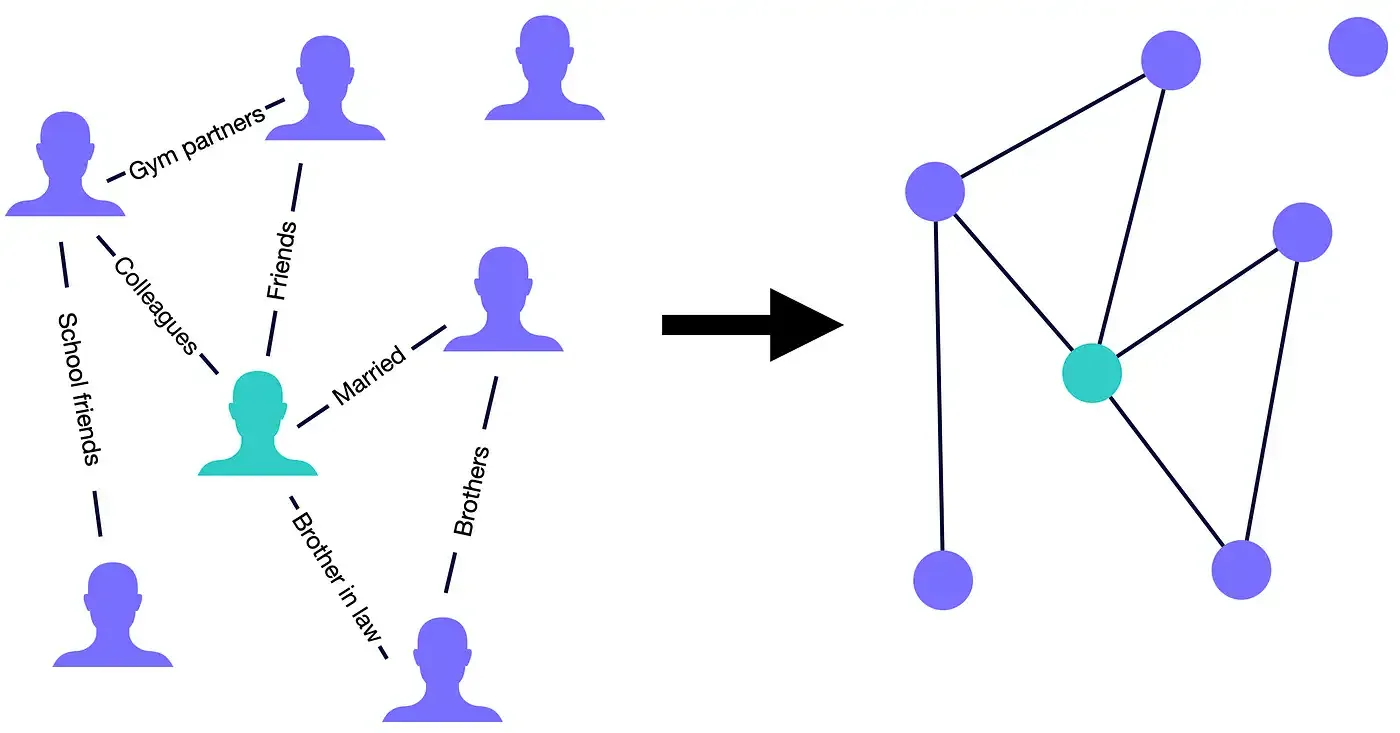
De la même manière, dans notre cas, nous utilisons les nœuds pour symboliser les différents pays et les arêtes pour désigner les échanges entre eux. Chaque pays possède un ensemble de qualités distinctes, appelées caractéristiques propres au pays (stockées dans les nœuds), comme la production intérieure de beurre ou le PIB. Viennent ensuite des caractéristiques exclusives à la paire de pays, appelées attributs propres à la paire (enregistrés dans les arêtes), comme le volume échangé ou le taux de change en vigueur entre les monnaies concernées.
Pour créer le graphe, nous utilisons toutes nos données d’import-export disponibles à partir de janvier 2015. Nous insérons d’abord les 242 nœuds disponibles, un pour chaque « pays ». Nous sélectionnons ensuite tous les échanges enregistrés sur cette période. Le résultat est impressionnant : 267 376 arêtes.
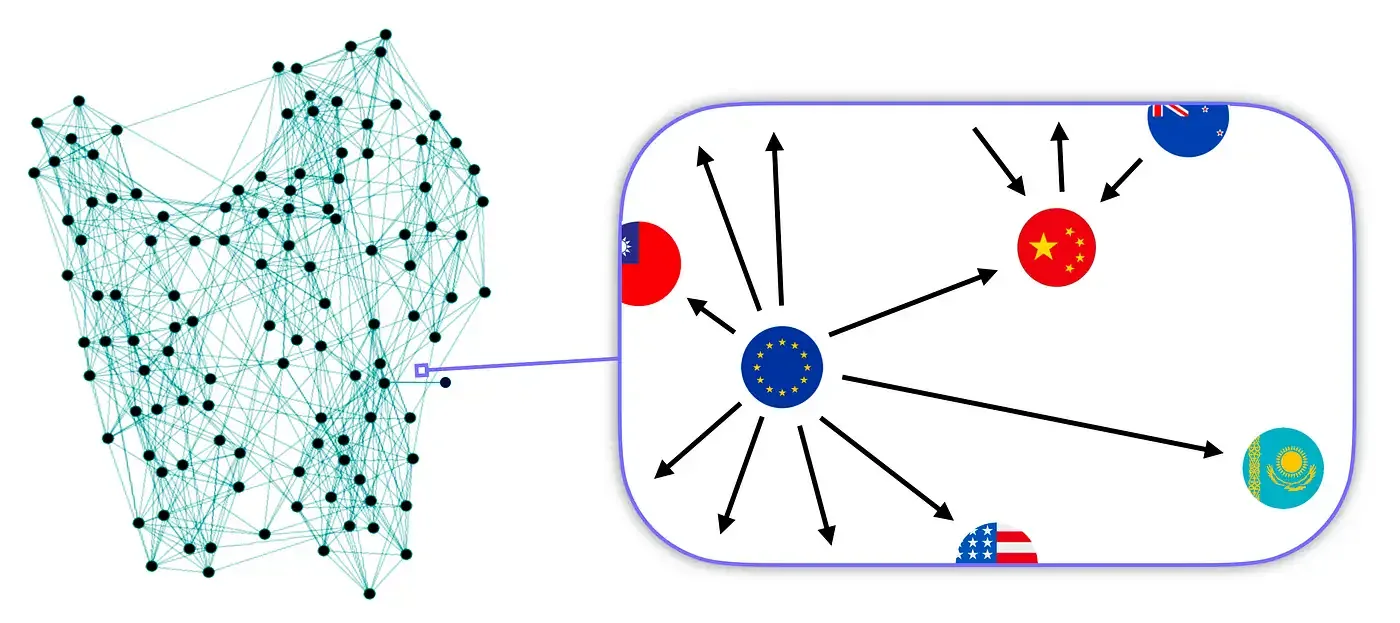
Pour mieux étudier le problème, nous segmentons les données par mois. Cela produit une séquence de graphes plus légers, comptant environ 2 000 arêtes, qui servent d’instantané de l’état mensuel du marché. Nous pouvons interpréter cette séquence historique de graphes comme une série de données générale qui regroupe les séries temporelles de nombreux points individuels. Une série temporelle est un ensemble de mesures d’une seule variable dans le temps, par exemple le volume échangé entre une seule paire de pays.
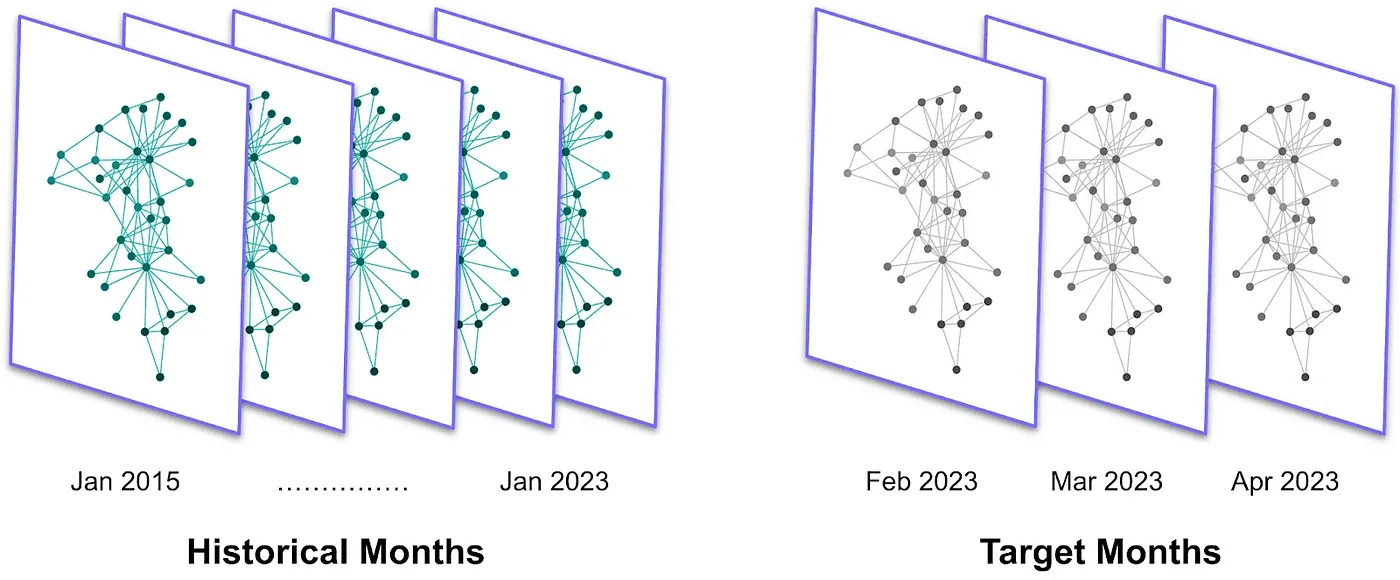
Le principal avantage de notre représentation fondée sur les graphes est sa capacité à capter les tendances à l’échelle mondiale. En regroupant toutes les paires de pays dans une seule structure, nous pouvons étudier plusieurs routes simultanément. À l’inverse, les techniques de prévision classiques ne peuvent traiter qu’une seule série de données à la fois.
De plus, comme toutes les autres variables qui nous intéressent (les caractéristiques propres au pays et les attributs propres à la paire) ne subissent pas un délai aussi long, nous pouvons déjà créer les graphes des trois mois les plus récents que nous cherchons à prévoir, appelés mois cibles. Avec cette séquence historique de graphes, nous sommes prêts à développer notre modèle de machine learning.
Prévoir les volumes échangés grâce au machine learning
Pour notre problème, nous allons mettre en œuvre une approche qui relève de l’apprentissage supervisé. Nous entraînons d’abord le modèle en lui fournissant à la fois les données de caractéristiques et la variable cible.
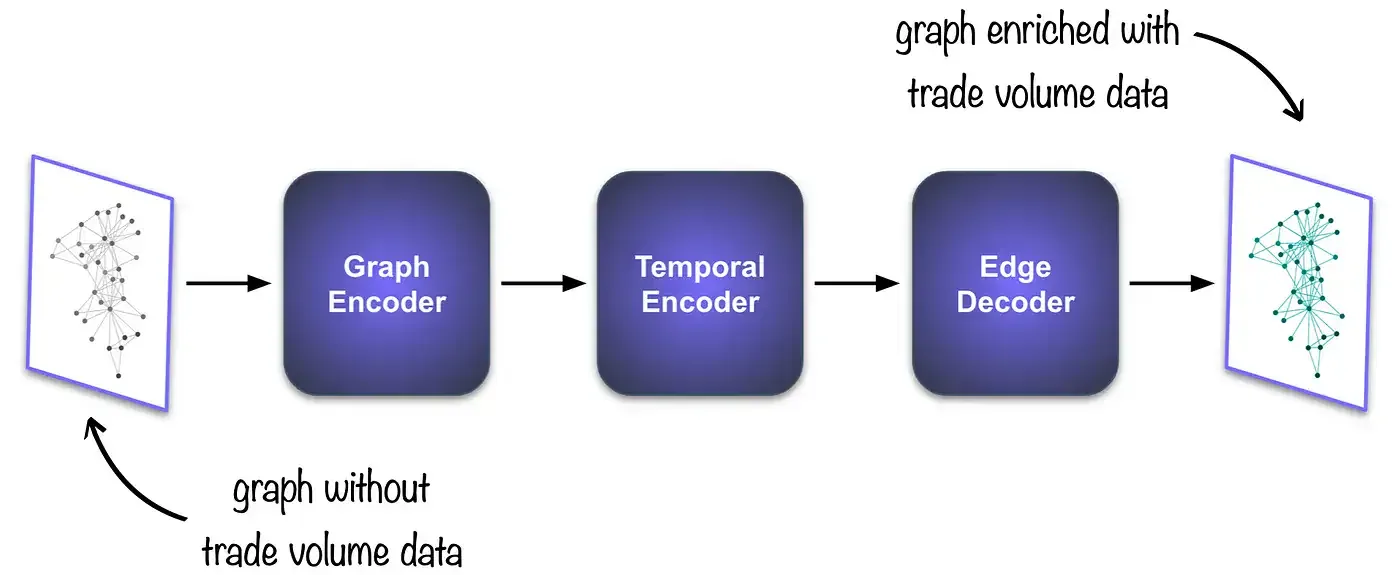
Après avoir entraîné notre modèle sur les mois historiques, nous lui soumettrons un instantané mensuel issu des mois cibles, contenant toutes les caractéristiques propres au pays et tous les attributs propres à la paire, mais dépourvu de données de volumes échangés. Il le traitera, puis, à partir des schémas appris pendant l’entraînement, il produira les volumes échangés prévus pour chaque paire de pays.
Maintenant que l’approche générale est posée, décomposons notre modèle en ses composants. Nous discuterons ensuite des résultats. Les parties clés de notre modèle sont les suivantes :
- Encodeur de graphe : pour condenser chaque graphe dans un format lisible par la machine, appelé embeddings.
- Encodeur temporel : pour extraire les relations temporelles des embeddings mensuels précédents.
- Décodeur d’arêtes : pour traduire les embeddings en prévisions de volumes échangés.
Encodeur de graphe : retour aux réseaux sociaux.
Pour ce composant, nous cherchons à transformer efficacement toutes les données stockées dans le graphe en une liste de nombres. Du fait des différences de forme, une certaine perte d’information est inévitable. Notre objectif est de la réduire au minimum.
Nous déployons un réseau de neurones en graphes (Graph Neural Network, GNN). Les GNN sont capables de combiner les informations du nœud lui-même, de son voisinage et des attributs des arêtes. C’est comme le dicton qui laisse entendre qu’une personne se définit le mieux par ses amis les plus proches. La sortie du GNN s’appelle les embeddings de nœuds.
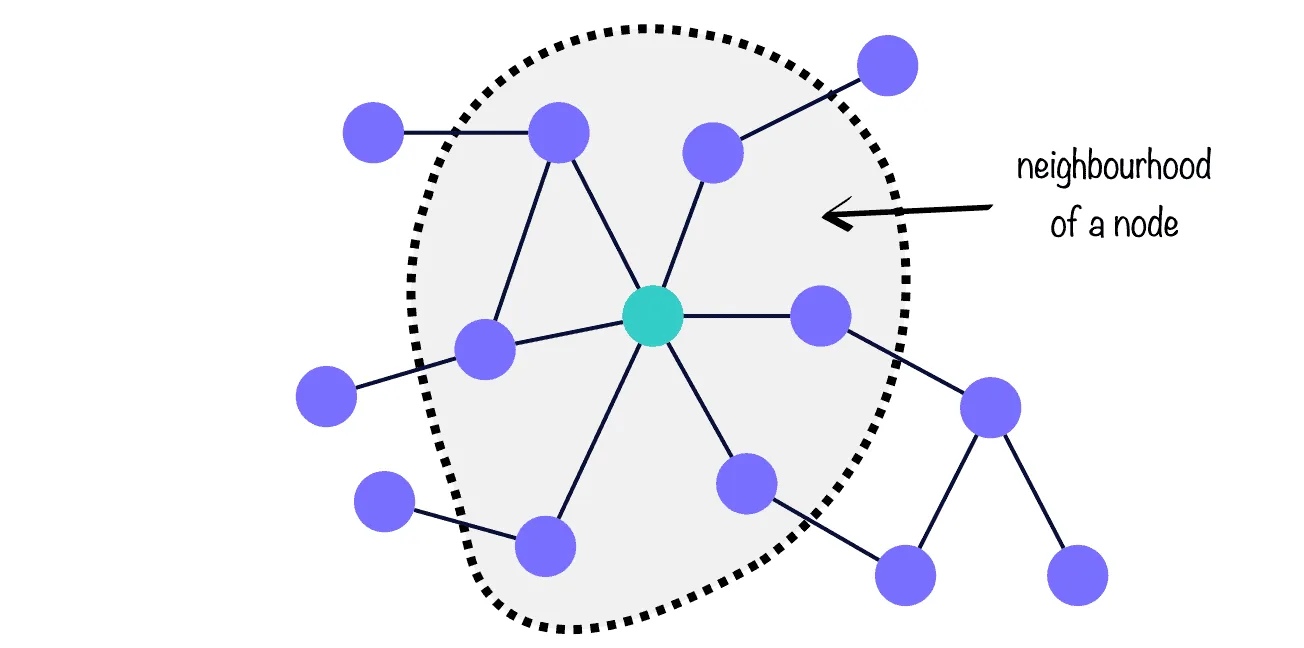
Et tout comme dans nos réseaux sociaux, où certains amis ont plus d’influence sur nous que d’autres, il en va de même pour les nœuds d’un graphe. Dans le jargon des GNN, cela s’appelle l’attention, et nous l’utilisons dans notre modèle pour déterminer quelles routes commerciales sont les plus informatives afin d’en prévoir d’autres.
Encodeur temporel : inspiré de ChatGPT
Cette unité apprend comment un mois donné est lié à ceux qui le précèdent. L’idée est que les conditions de marché d’un mois sont influencées par l’état du marché des mois précédents. Nous déployons le Transformer, une architecture de pointe qui est à la base des modèles de langage comme ChatGPT, en raison de sa capacité à produire des prévisions « sequence-to-sequence ».
Imaginez un scénario de prédiction de saisie. À partir d’une phrase (une séquence de mots), le Transformer comprend l’ordre des mots et leur importance dans la transmission du message, le tout au regard du contexte général de la phrase. Il produit ensuite le mot ayant la plus forte probabilité d’être le suivant dans la séquence.
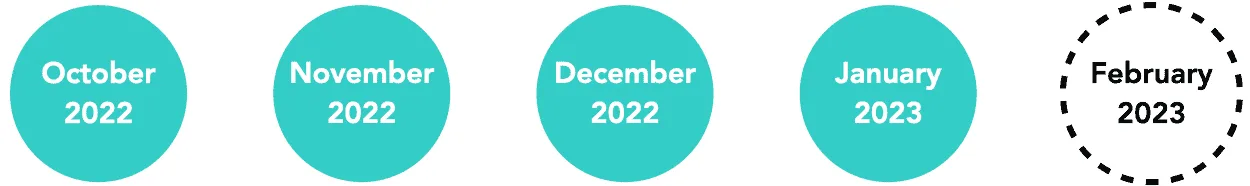
Nous appliquons astucieusement cette structure à notre problème : chaque instantané mensuel est traité comme un mot, et le Transformer produit les embeddings de nœuds les plus probables pour le mois suivant dans la séquence.
Décodeur d’arêtes : donner du sens aux embeddings de nœuds.
On peut voir la fonction de ce composant comme l’inverse de celle de l’encodeur de graphe. Au lieu de créer des embeddings, il déchiffre ceux qu’il reçoit de l’encodeur temporel pour en faire des prévisions de la variable cible. Nous mettons en œuvre deux réseaux de neurones, avec pour objectif de prendre des paires d’embeddings et d’en extraire un seul nombre : la prévision du volume échangé entre deux pays.
Le résultat est une unité capable de reconstituer le volume échangé de chaque paire de pays du graphe pour le mois considéré. Ainsi, meilleur est le décodeur d’arêtes, plus les prévisions seront proches des valeurs réelles.
Les résultats
Pour évaluer la performance de notre modèle, nous prenons les trois mois les plus récents (pour lesquels les données de volumes échangés sont disponibles) et nous les soumettons au modèle. Nous comparons ensuite les prévisions aux valeurs réelles. Pour que le test soit valide, nous n’avons jamais montré ces trois mois au modèle.
Le modèle excelle à prévoir les cas où aucun échange n’a lieu entre deux pays. Il se comporte également bien pour prévoir les cas où les volumes échangés sont exceptionnellement élevés. Cela pourrait tenir à l’ampleur même de ces volumes, qui s’écartent nettement de la valeur moyenne des données et sont donc facilement reconnaissables par le modèle.
Fait intéressant, il peine sur les volumes échangés moyens. Lorsque nous comparons nos prévisions aux méthodes traditionnelles de prévision de séries temporelles, il apparaît clairement que, pour améliorer la précision de notre modèle, nous devons faciliter la distinction entre les routes commerciales moyennes qui se ressemblent davantage. On peut y parvenir en intégrant davantage de caractéristiques de données, qui contribuent à créer une représentation plus riche du marché, et en incluant des informations commerciales issues d’autres matières premières.
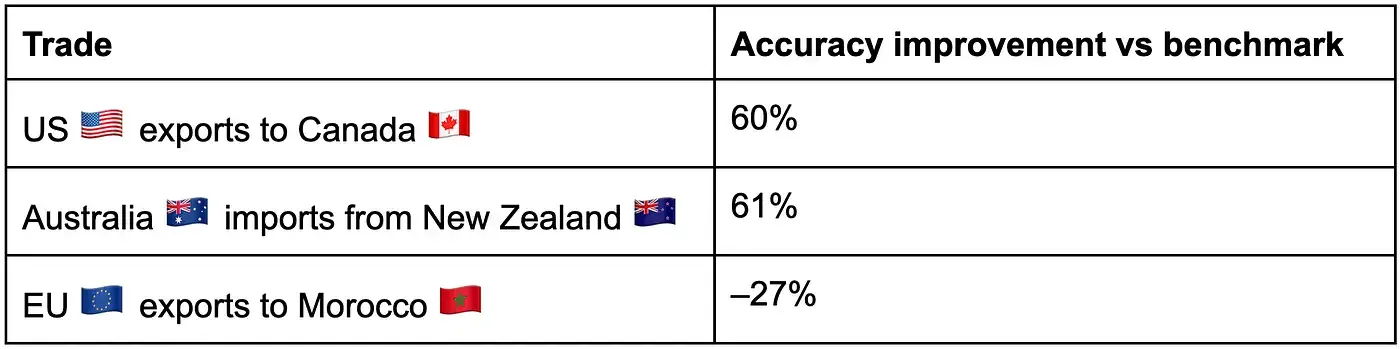
Compte tenu de ces considérations, l’amélioration moyenne de notre modèle sur l’ensemble des routes commerciales est négligeable, et il est plus instructif d’étudier les paires individuellement. Vous trouverez ci-dessous la performance de notre modèle sur deux routes aux volumes échangés très élevés et sur une route moyenne. Comme vous pouvez le constater, les résultats diffèrent beaucoup.