Nabiał spotyka uczenie maszynowe: przystępny przegląd prognozowania wolumenów handlu z użyciem grafowych sieci neuronowych i transformerów
Opóźniony smak
Co minutę na świecie produkuje się około 22 ton masła. Tworzy to złożony krajobraz handlowy z ponad 2300 odnotowanymi transakcjami miesięcznie. Ze względu na ogromną liczbę zastosowań masła i jego licznych produktów pochodnych śledzenie handlu jest kluczowe dla kupujących, sprzedających i traderów, dzięki czemu są dobrze poinformowani, gdy podejmują decyzje biznesowe.
Jest jednak wyzwanie w dostępie do informacji w czasie rzeczywistym. Ponieważ zbieranie danych opiera się w całości na instytucjach rządowych, występuje zauważalne opóźnienie. Średnio mijają trzy miesiące, zanim wszystkie kraje zgłoszą swoje wolumeny handlu.
Nasz cel? Całkowicie wyeliminować opóźnienie w raportowaniu. Zamierzamy wdrożyć najnowocześniejsze technologie, żeby prognozować wolumeny handlu międzynarodowego z ostatnich trzech miesięcy i w ten sposób skutecznie wypełnić lukę.
Rozwiązywanie takich problemów to sedno działalności Vesper. Dążymy do zbudowania najbardziej kompleksowej platformy analityki surowcowej, a wysokiej jakości dane i wiedzę ekspercką łączymy z Data Science, żeby tworzyć unikalne narzędzia dla naszych użytkowników.
W tym artykule przedstawiamy przegląd naszej implementacji. Zaczniemy od omówienia dynamiki rynku masła, a następnie wprowadzimy nasz nowatorski sposób reprezentacji problemu z użyciem grafów czasowych. Potem poznasz podstawy naszego modelu uczenia maszynowego wraz z krótkim omówieniem każdego z jego trzech kluczowych komponentów. Na koniec przybliżymy wyniki.
Masło rozsmarowane po całym świecie
Masło to jeden z najaktywniej handlowanych surowców w branży mleczarskiej. Co miesiąc dziesiątki tysięcy ton masła przekraczają granice państw. Same UE, Nowa Zelandia i Stany Zjednoczone wysyłały w 2022 roku średnio około 46 000 ton miesięcznie. Wielkość tego importu i eksportu waha się od zaledwie ułamków tony do dziesiątek tysięcy ton.
Międzynarodowy rynek masła funkcjonuje w dużej mierze jak oligopol. Trzej dominujący producenci z nadwyżkami to USA, Nowa Zelandia i kraje UE, a wszyscy konkurują o popyt pozostałych państw. W 2022 roku Unia Europejska, Nowa Zelandia i Stany Zjednoczone wyeksportowały łącznie około 555 000 ton masła. Choć inne kraje produkują masło na własnym rynku, po dodatkowe dostawy często zwracają się do jednego z trzech głównych graczy.
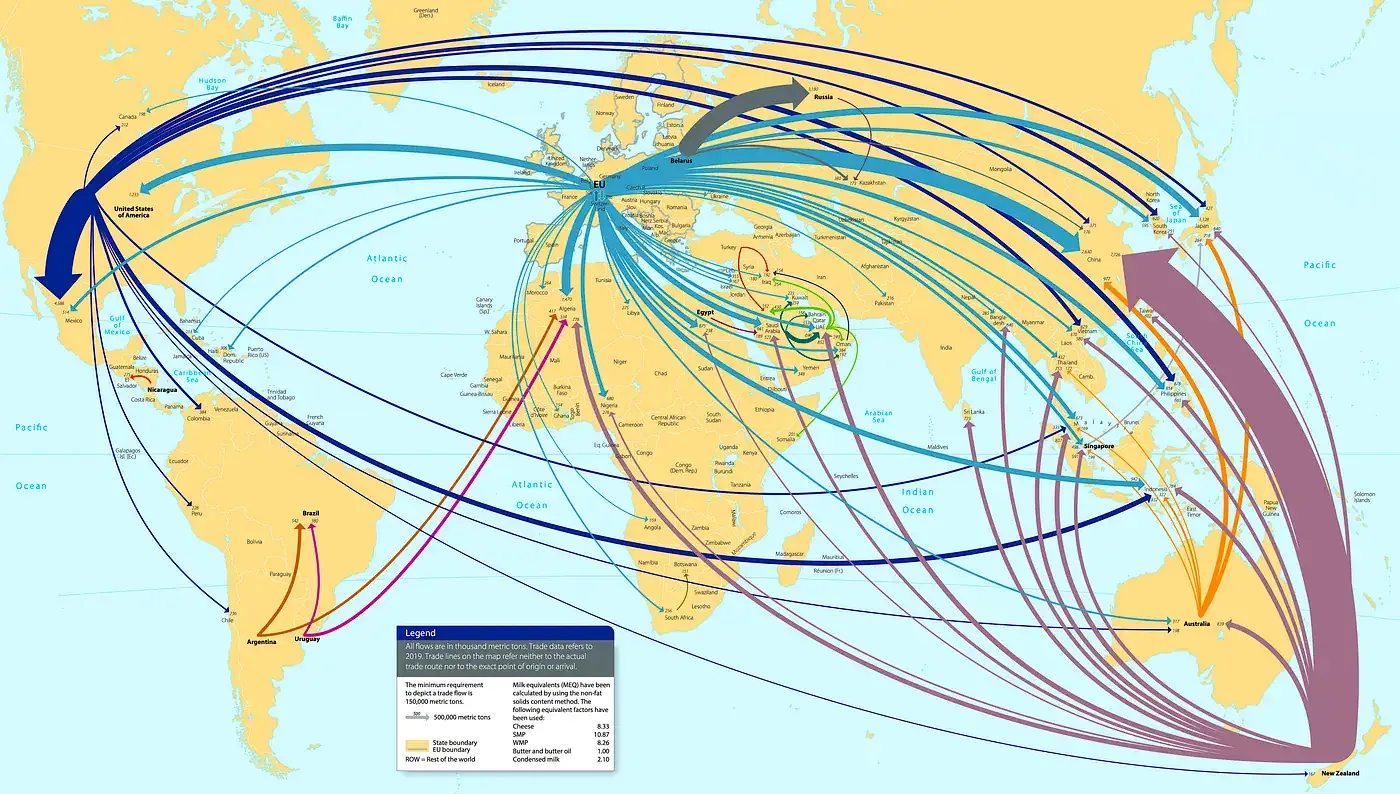
Przez lata wiele krajów zbudowało silne szlaki handlowe z tymi dużymi producentami, dzięki umowom handlowym i sprzyjającym warunkom geopolitycznym. W efekcie wymiana handlowa z tymi dużymi graczami jest zwykle stabilna pod względem wolumenu i terminów. Jest tak w porównaniu z handlem masłem między innymi parami krajów, który bywa bardziej sporadyczny. Często pod wpływem krótkoterminowych wydarzeń ich charakter jest znacznie bardziej „losowy”, a przez to trudniejszy do przewidzenia.
Z perspektywy kupującego wybór głównego producenta, od którego zamówi masło, zależy od wielu czynników. Ponieważ masło jest surowcem, różnice są niewielkie, jeśli nie pomijalne. Dlatego głównym czynnikiem decyzyjnym jest rozbieżność w cenach ofertowych dużych graczy, a w dalszej kolejności cła i koszty transportu.
Reprezentacja problemu: ogromna sieć społeczna.
Do skutecznego przedstawienia dynamiki rynku handlu masłem używamy grafów. W przeciwieństwie do zwykłych tabel, które wymieniają punkty danych osobno, grafy podkreślają powiązania między nimi i zachowują cenne niuanse połączonej sieci. Obejmuje to rodzaje i siłę relacji między punktami danych.
Żeby lepiej zobrazować grafy, pomyśl o swojej sieci społecznej znajomych i współpracowników. Każdy węzeł to osoba, a każda krawędź odzwierciedla Twoją relację z tą osobą. Za pomocą grafów możemy przedstawić całą Twoją sieć społeczną, zachowując unikalne właściwości poszczególnych osób jako cechy węzłów, a charakterystykę relacji zapisaną jako atrybuty krawędzi.
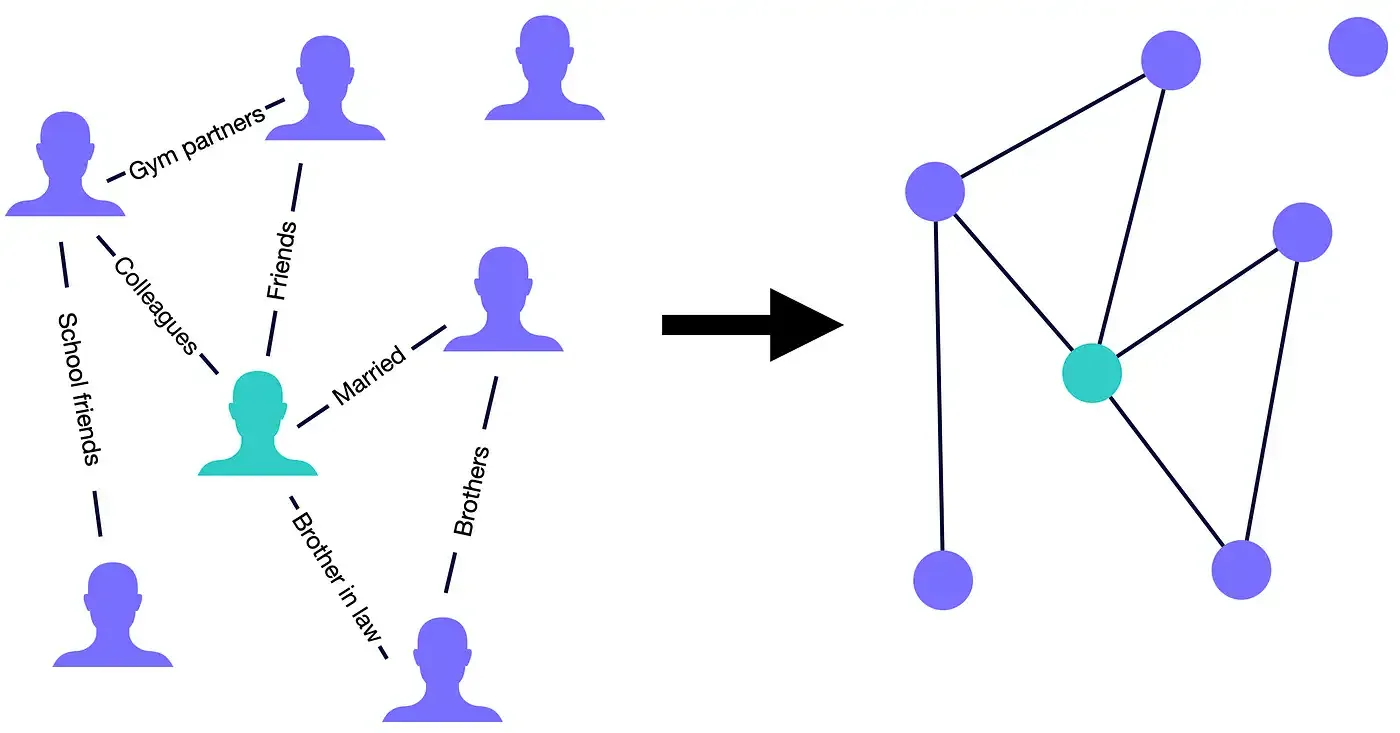
Podobnie w naszym scenariuszu węzły symbolizują poszczególne kraje, a krawędzie oznaczają zdarzenia handlowe między nimi. Każdy kraj ma zestaw odrębnych właściwości nazywanych cechami specyficznymi dla kraju (przechowywanymi w węzłach), takich jak krajowa produkcja masła czy PKB. Są też charakterystyki właściwe wyłącznie dla danej pary krajów, nazywane atrybutami specyficznymi dla pary (zapisanymi w krawędziach), takie jak wolumen handlu czy obowiązujący kurs wymiany między odpowiednimi walutami.
Do stworzenia grafu wykorzystujemy wszystkie dostępne dane o imporcie i eksporcie od stycznia 2015 roku. Najpierw wstawiamy dostępne 242 węzły, po jednym dla każdego „kraju”. Następnie wybieramy wszystkie transakcje odnotowane w tym oknie czasowym. Efekt to imponujące 267 376 krawędzi.
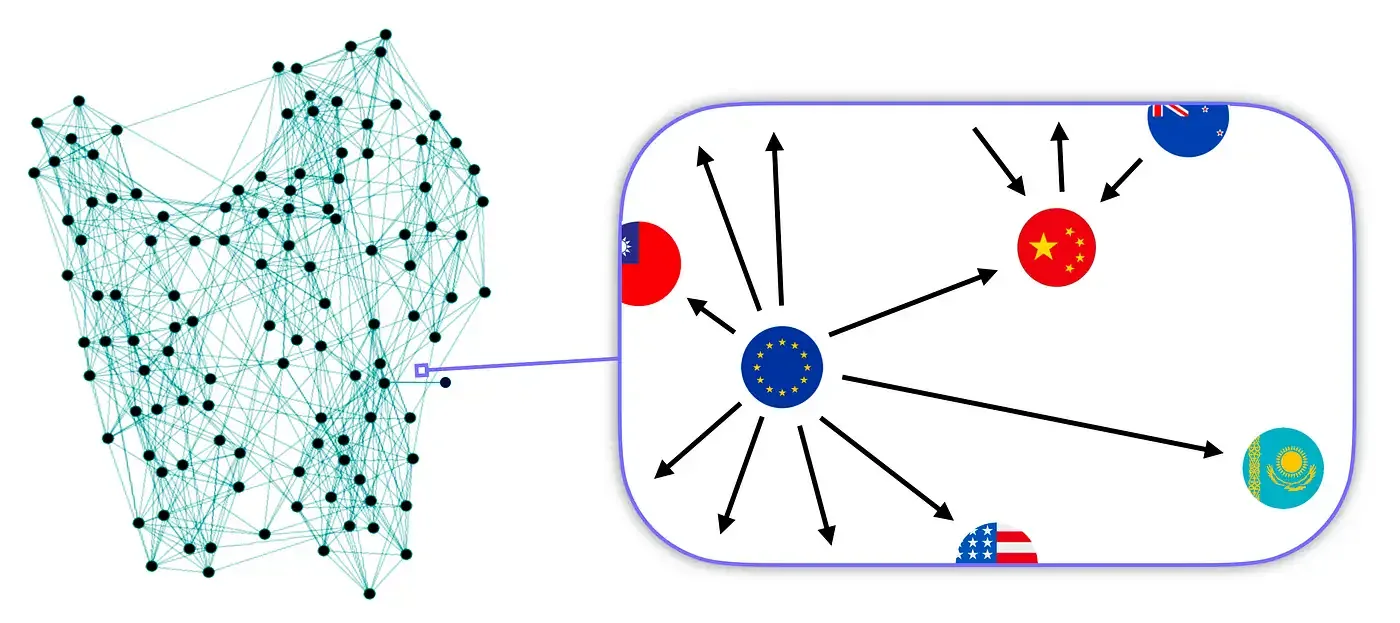
Żeby lepiej zbadać problem, dzielimy dane na miesiące. Daje to sekwencję lżejszych grafów z około 2000 krawędzi, z których każdy jest migawką miesięcznego stanu rynku. Tę historyczną sekwencję grafów można interpretować jako ogólną serię danych, która grupuje szeregi czasowe wielu pojedynczych punktów. Szereg czasowy to zbiór pomiarów jednej zmiennej w czasie, na przykład wolumenu handlu między tylko jedną parą krajów.
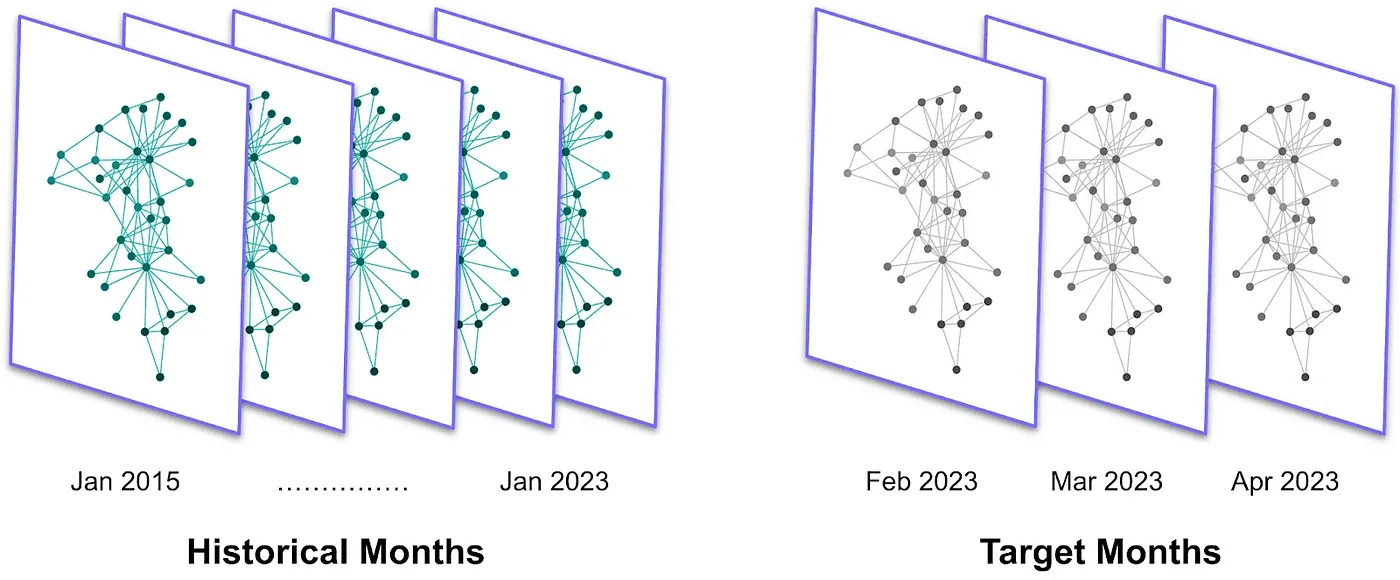
Kluczową zaletą naszej reprezentacji opartej na grafach jest zdolność uchwycenia trendów w skali całego świata. Grupując wszystkie pary krajów w jednej strukturze, możemy badać wiele szlaków jednocześnie. Dla porównania standardowe techniki prognozowania obsługują tylko jedną serię danych naraz.
Co więcej, ponieważ wszystkie pozostałe zmienne, które nas interesują (cechy specyficzne dla kraju i atrybuty specyficzne dla pary), nie mają tak długiego opóźnienia, możemy już teraz tworzyć grafy dla trzech ostatnich miesięcy, które chcemy prognozować, nazywanych miesiącami docelowymi. Mając tę historyczną sekwencję grafów, jesteśmy gotowi zbudować nasz model uczenia maszynowego.
Prognozowanie wolumenów handlu z użyciem uczenia maszynowego
W naszym problemie zastosujemy podejście, które należy do uczenia nadzorowanego. Najpierw trenujemy model, podając mu zarówno dane o cechach, jak i zmienną docelową.
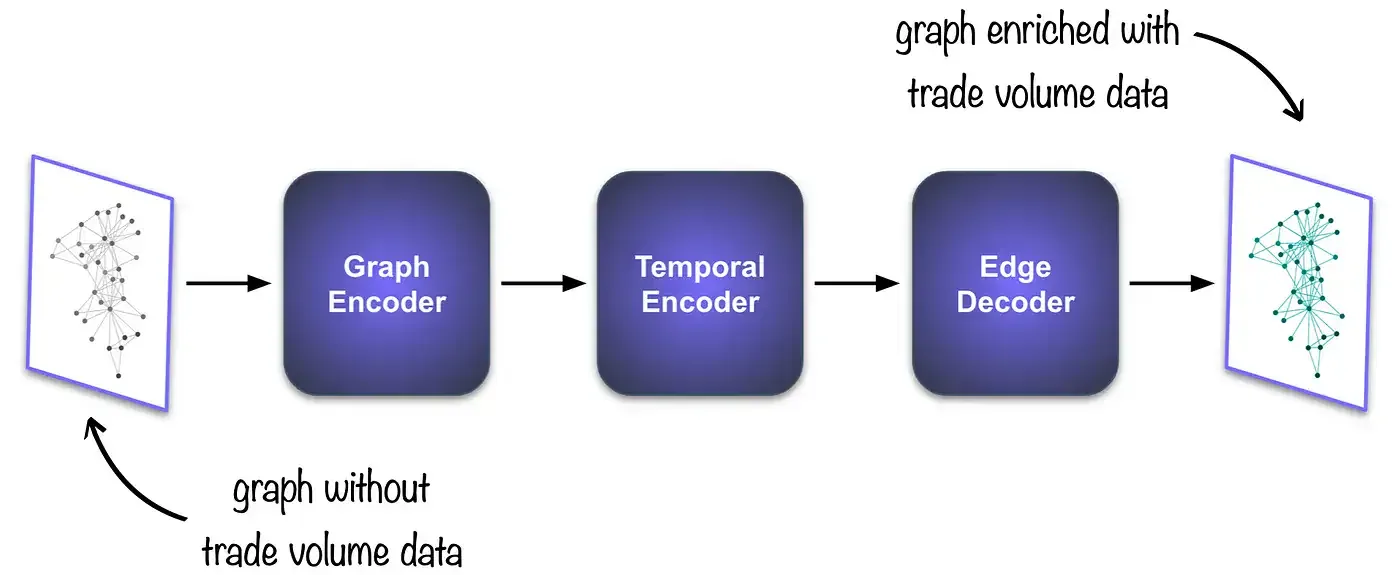
Po wytrenowaniu modelu na miesiącach historycznych podamy mu miesięczną migawkę z miesięcy docelowych, zawierającą wszystkie cechy specyficzne dla kraju i atrybuty specyficzne dla pary, ale pozbawioną danych o wolumenie handlu. Model ją przetworzy, a potem, na podstawie wzorców poznanych podczas treningu, zwróci prognozowane wolumeny handlu dla każdej pary krajów.
Znając ogólne podejście, rozłóżmy nasz model na komponenty. Potem omówimy wyniki. Kluczowe części naszego modelu to:
- Koder grafu (Graph Encoder): zagęszcza pojedynczy graf do formatu czytelnego dla maszyny, nazywanego embeddingami.
- Koder czasowy: wydobywa zależności czasowe z embeddingów z poprzednich miesięcy.
- Dekoder krawędzi: przekłada embeddingi na prognozy wolumenów handlu.
Koder grafu: wracamy do sieci społecznych.
W tym komponencie zależy nam na sprawnym przekształceniu wszystkich danych zapisanych w grafie w listę liczb. Ze względu na różnice w formie pewna utrata informacji jest nieunikniona. Naszym celem jest zminimalizowanie tej utraty.
Wdrażamy grafową sieć neuronową (GNN). Sieci GNN potrafią łączyć informacje z pojedynczego węzła, jego sąsiedztwa i atrybutów krawędzi. To jak powiedzenie, według którego człowieka najlepiej definiują jego najbliżsi przyjaciele. Wynik działania GNN nazywa się embeddingami węzłów.
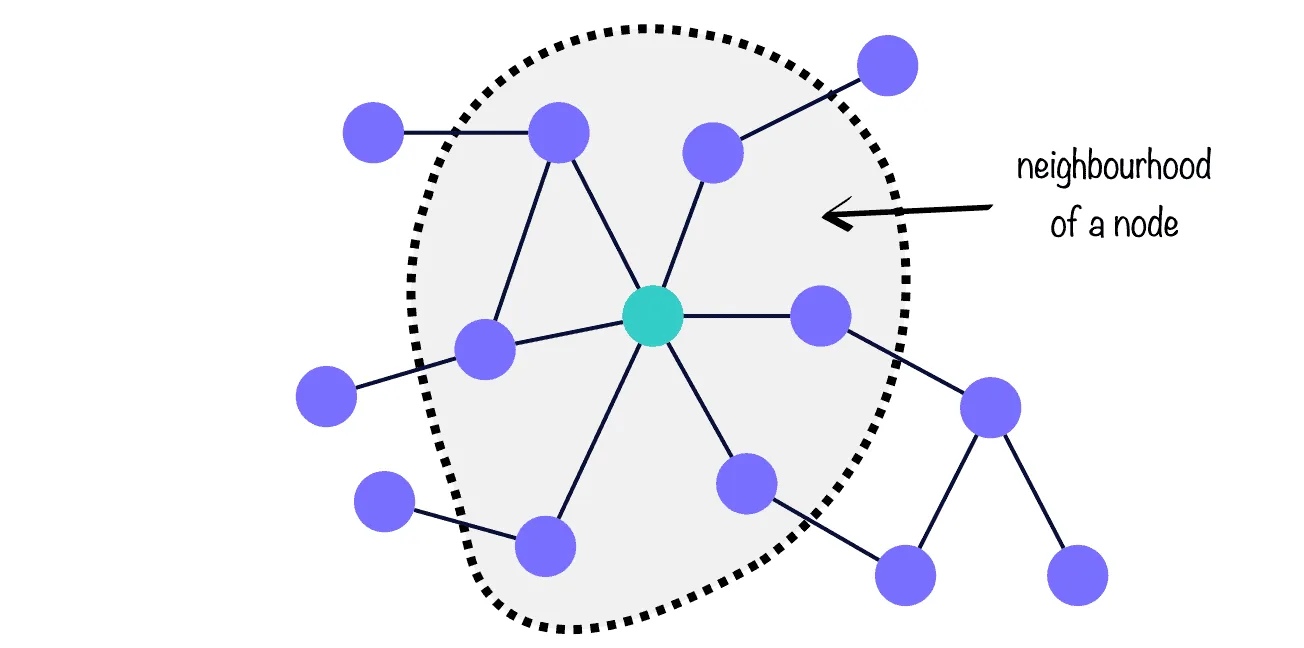
I podobnie jak w naszych sieciach społecznych, gdzie jedni znajomi mają na nas większy wpływ niż inni, tak samo jest z węzłami w grafie. W żargonie GNN nazywa się to uwagą (attention), a my wykorzystujemy ją w naszym modelu do uszeregowania szlaków handlowych według tego, jak wiele informacji niosą przy prognozowaniu innych szlaków handlowych.
Koder czasowy: inspirowany ChatGPT
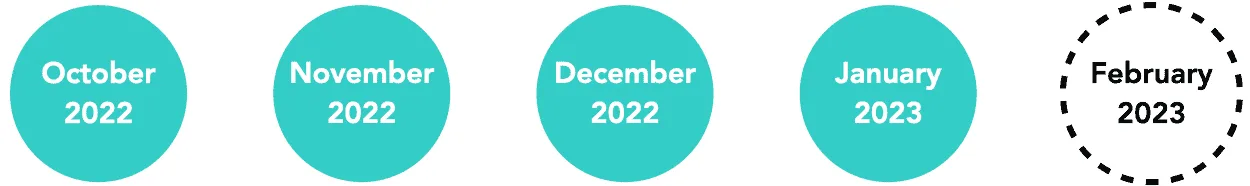
Ta jednostka uczy się, jak konkretny miesiąc wiąże się z miesiącami go poprzedzającymi. Założenie jest takie, że na warunki rynkowe danego miesiąca wpływa stan rynku w miesiącach poprzednich. Wdrażamy Transformer, czołową architekturę, która leży u podstaw modeli językowych takich jak ChatGPT, a to za sprawą jej zdolności do prognoz typu „sequence-to-sequence”.
Wyobraź sobie podpowiadanie słów podczas pisania. Mając zdanie (sekwencję słów), Transformer rozumie kolejność słów i ich znaczenie dla przekazu, wszystko w odniesieniu do ogólnego kontekstu wypowiedzi. Następnie zwraca słowo o najwyższym prawdopodobieństwie, że będzie następne w sekwencji.
Sprytnie stosujemy tę strukturę do naszego problemu: każdą miesięczną migawkę traktujemy jak słowo, a Transformer zwraca najbardziej prawdopodobne embeddingi węzłów dla kolejnego miesiąca w sekwencji.
Dekoder krawędzi: jak odczytać embeddingi węzłów.
Zadanie tego komponentu można postrzegać jako odwrotność Kodera grafu. Zamiast tworzyć embeddingi, rozszyfrowuje te, które otrzymuje z Kodera czasowego, zamieniając je w prognozy zmiennej docelowej. Implementujemy dwie sieci neuronowe i stawiamy im cel: wziąć pary embeddingów i wyciągnąć z nich jedną liczbę, czyli prognozę wolumenu handlu między dwoma krajami.
Efektem jest jednostka, która potrafi odtworzyć wolumen handlu dla każdej pary krajów w grafie dla interesującego nas miesiąca. Im lepszy Dekoder krawędzi, tym bliższe rzeczywistym wartościom będą prognozy.
Wyniki
Żeby ocenić skuteczność naszego modelu, bierzemy trzy ostatnie miesiące (dla których dostępne są dane o wolumenie handlu) i podajemy je modelowi. Następnie porównujemy prognozy z prawdziwymi wartościami. Żeby test był wiarygodny, nigdy nie pokazaliśmy modelowi tych trzech miesięcy.
Model świetnie radzi sobie z przewidywaniem sytuacji, w których między dwoma krajami nie dochodzi do handlu. Dobrze wypada też w prognozowaniu wyjątkowo wysokich wolumenów handlu. Może to wynikać z samej skali tych wolumenów, które mocno odbiegają od wartości średniej w danych i dzięki temu są dla modelu łatwo rozpoznawalne.
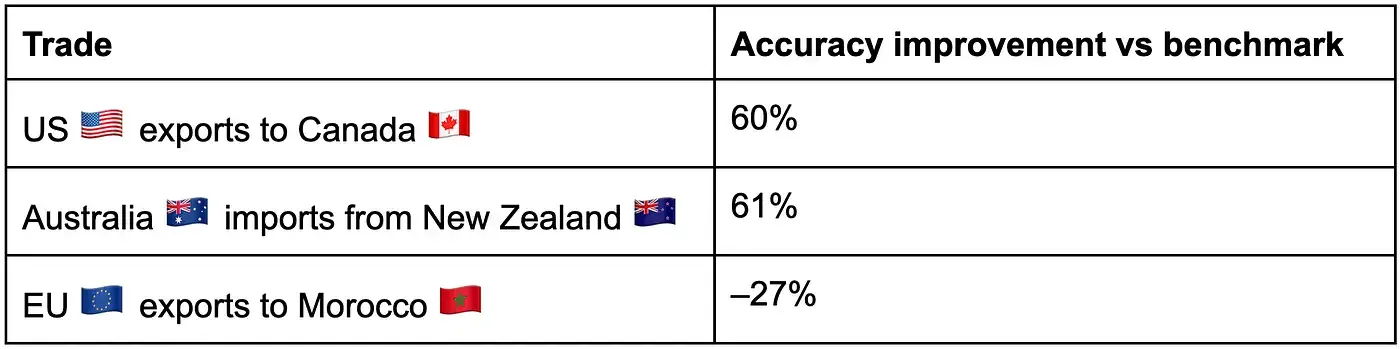
Co ciekawe, model ma trudności z przeciętnymi wolumenami handlu. Kiedy porównujemy nasze prognozy z tradycyjnymi metodami prognozowania szeregów czasowych, staje się jasne, że aby poprawić dokładność modelu, musimy ułatwić mu rozróżnianie przeciętnych szlaków handlowych, które są do siebie bardziej podobne. Można to osiągnąć, dodając więcej cech danych, które pomagają zbudować bogatszą reprezentację rynku, oraz włączając informacje handlowe z innych surowców.
Biorąc to pod uwagę, średnia poprawa naszego modelu na wszystkich szlakach handlowych jest pomijalna i więcej mówi analiza poszczególnych par. Poniżej znajdziesz skuteczność naszego modelu na dwóch szlakach o bardzo wysokich wolumenach handlu i na jednym przeciętnym. Jak widać, wyniki mocno się różnią.