Lácteos y aprendizaje automático: una introducción sencilla a la predicción de volúmenes comerciales con redes neuronales de grafos y transformers
Sabor con retraso
Cada minuto se producen en todo el mundo unas 22 toneladas métricas de mantequilla. El resultado es un panorama comercial complejo, con más de 2.300 transacciones registradas al mes. Dados los numerosos usos de la mantequilla y sus muchos productos derivados, resulta esencial que compradores, vendedores y traders sigan el comercio, de modo que estén informados al tomar decisiones de negocio.
Sin embargo, acceder a información en tiempo real plantea una dificultad. Debido a la dependencia total de los organismos gubernamentales para la recopilación de datos, existe un retraso notable. En promedio, pasan tres meses hasta que todos los países declaran sus volúmenes comerciales.
¿Nuestro objetivo? Eliminar por completo el retraso en la declaración de los datos. Nos proponemos implementar tecnologías de vanguardia para prever los volúmenes comerciales internacionales de los últimos tres meses y salvar así, en la práctica, esa brecha.
Resolver problemas como este es el núcleo de Vesper. Nos esforzamos por construir la plataforma de inteligencia de materias primas más completa, y combinamos datos de calidad y experiencia profesional con la ciencia de datos para crear herramientas únicas para nuestros usuarios.
En este artículo ofrecemos una visión general de nuestra implementación. Empezaremos por recorrer la dinámica del mercado de la mantequilla, seguida de una introducción a nuestra novedosa representación del problema mediante grafos temporales. Después conocerá los fundamentos de nuestro modelo de aprendizaje automático, con un breve resumen de cada uno de sus tres componentes cruciales. Y, por último, daremos una idea de los resultados.
La mantequilla se extiende por todo el mundo
La mantequilla es una de las materias primas que más se negocian en el sector lácteo. Cada mes, decenas de miles de toneladas métricas de mantequilla cruzan fronteras internacionales. Solo la UE, Nueva Zelanda y Estados Unidos enviaron un promedio de unas 46.000 mt al mes en 2022. Estas importaciones y exportaciones pueden ir desde fracciones mínimas hasta decenas de miles de toneladas métricas.
El mercado internacional de la mantequilla funciona en gran medida como un oligopolio. Los tres productores excedentarios dominantes son EE. UU., Nueva Zelanda y los países de la UE, que compiten todos por la demanda del resto de países. En 2022, la Unión Europea, Nueva Zelanda y Estados Unidos exportaron en conjunto unas 555.000 toneladas métricas de mantequilla. Aunque otros países producen mantequilla a nivel nacional, a menudo recurren a uno de los tres grandes actores para obtener suministro adicional.
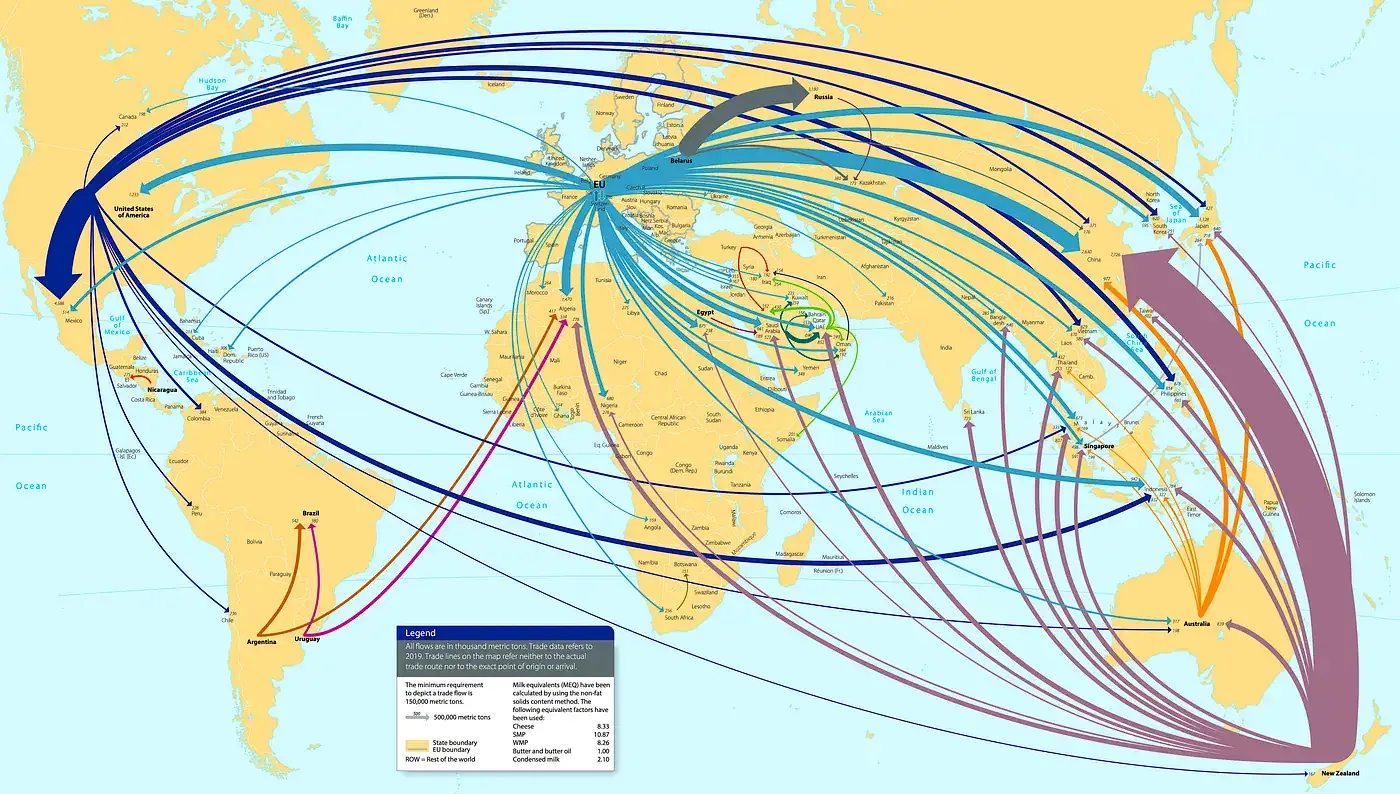
Con los años, muchos países han establecido sólidas rutas comerciales con estos grandes productores, gracias a los acuerdos comerciales y a unas condiciones geopolíticas favorables. En consecuencia, las interacciones comerciales con estos grandes actores suelen ser constantes en volumen y en calendario. Esto es así en comparación con los intercambios de mantequilla entre otros pares de países, que tienden a ser más esporádicos. A menudo influidos por acontecimientos a corto plazo, estos intercambios tienen una naturaleza considerablemente más «aleatoria» y, por lo tanto, más difícil de predecir.
Desde el punto de vista del comprador, la elección del gran productor del que abastecerse de mantequilla depende de muchos factores. Como la mantequilla es una materia prima, las diferencias son pequeñas, si no insignificantes. Por lo tanto, el principal factor de decisión es la discrepancia entre los precios de oferta de los grandes actores, seguida de los aranceles y los costos de transporte.
Representación del problema: una enorme red social.
Utilizamos grafos para representar de forma eficaz la dinámica del mercado del comercio de mantequilla. A diferencia de las tablas convencionales, que enumeran los puntos de datos por separado, los grafos destacan los vínculos entre ellos y preservan los valiosos matices de una red interconectada. Eso incluye los tipos y la intensidad de las relaciones entre los puntos de datos.
Para visualizar mejor los grafos, piense en su red social de amigos y colegas. Cada nodo es una persona y cada arista representa su relación con esa persona. Con grafos podemos representar toda su red social, preservando las cualidades únicas de las personas como características de los nodos y los rasgos de las relaciones guardados como atributos de las aristas.
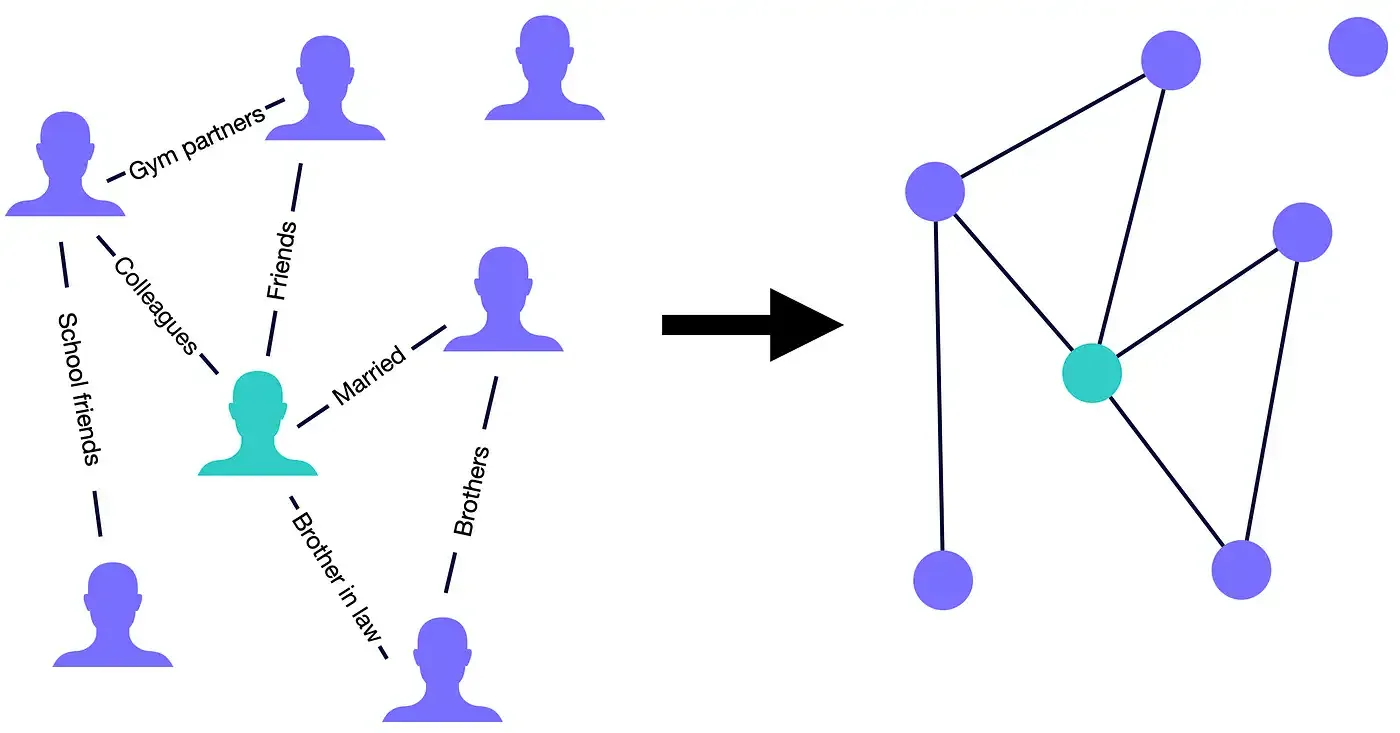
De forma similar, en nuestro escenario utilizamos los nodos para simbolizar países concretos y las aristas para denotar los intercambios comerciales entre ellos. Cada país posee un conjunto de cualidades propias llamadas características específicas de cada país (almacenadas en los nodos), como la producción nacional de mantequilla o el PIB. Además, hay rasgos exclusivos del par de países, llamados atributos específicos del par (guardados en las aristas), como el volumen comercial o el tipo de cambio vigente entre las respectivas monedas.
Para crear el grafo utilizamos todos nuestros datos de importación y exportación disponibles desde enero de 2015. En primer lugar, insertamos los 242 nodos disponibles, uno por cada «país». Después seleccionamos todos los intercambios registrados durante ese periodo. El resultado son unas impresionantes 267.376 aristas.
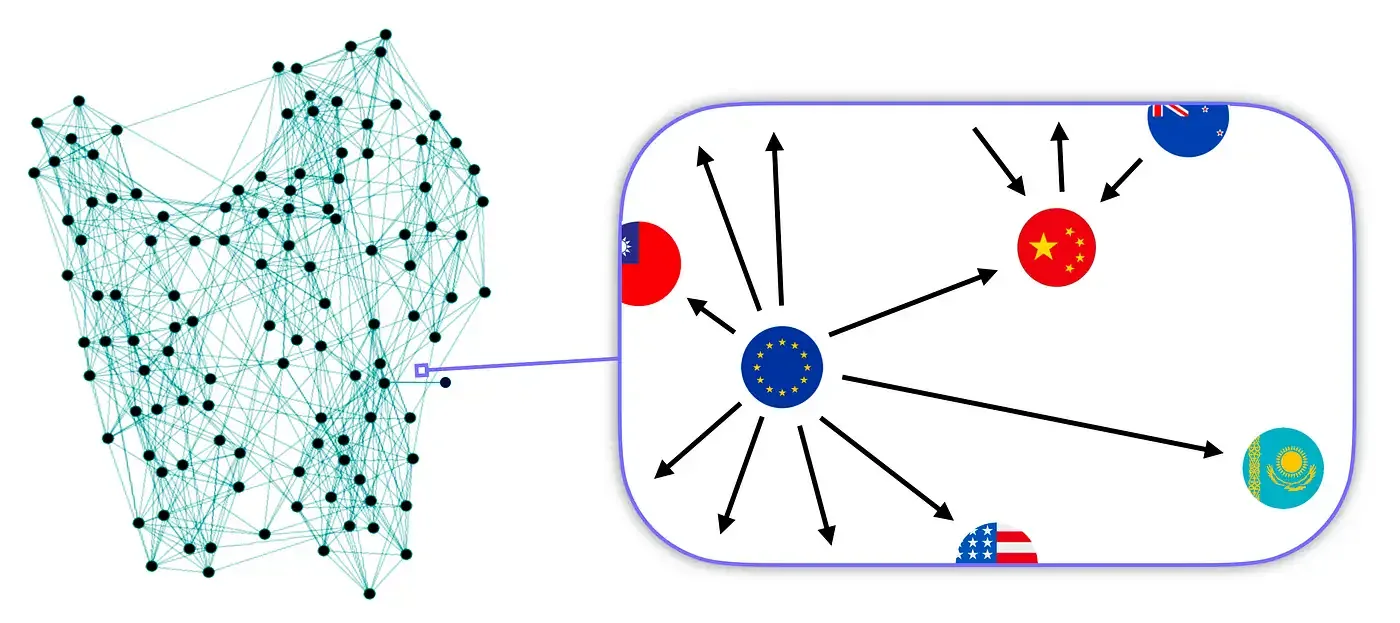
Para estudiar mejor el problema, segmentamos los datos por meses. Eso produce una secuencia de grafos más ligeros, con aproximadamente 2.000 aristas, que sirven de instantánea del estado mensual del mercado. Podemos interpretar esta secuencia histórica de grafos como una serie de datos general que agrupa las series temporales de muchos puntos individuales. Una serie temporal es un conjunto de mediciones de una sola variable a lo largo del tiempo, por ejemplo, el volumen comercial entre un único par de países.
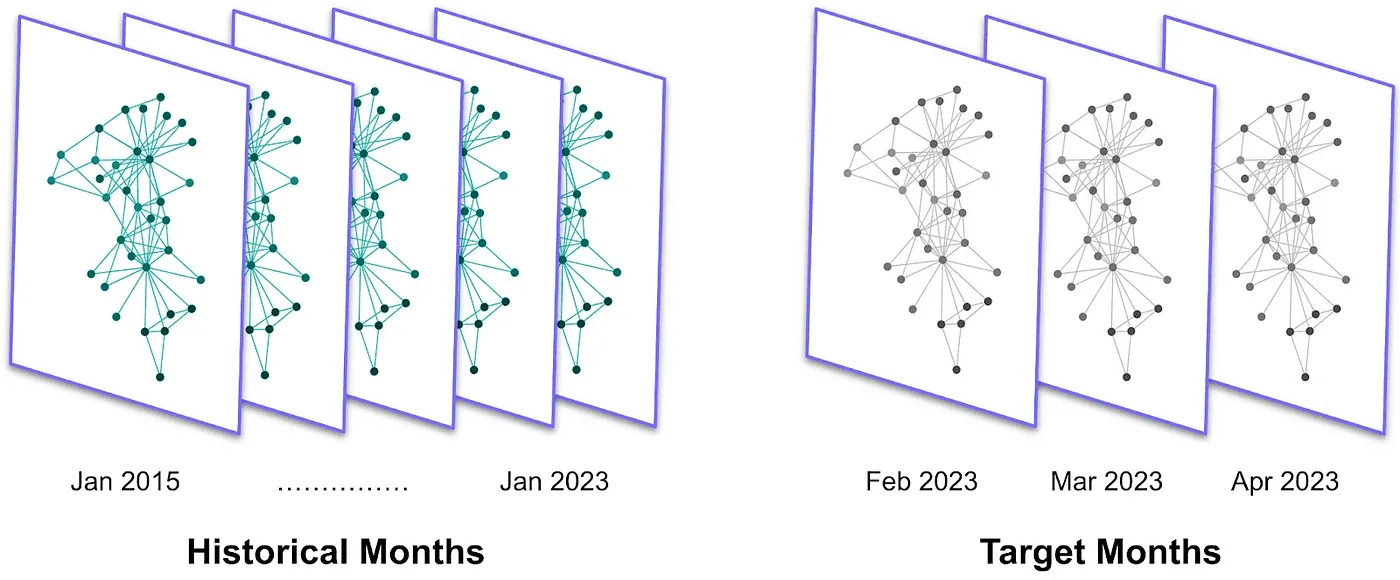
La ventaja principal de nuestra representación basada en grafos es su capacidad para captar tendencias a escala mundial. Al agrupar todos los pares de países en una única estructura, podemos estudiar varias rutas a la vez. En cambio, las técnicas de previsión convencionales solo pueden manejar una serie de datos cada vez.
Además, como todas las demás variables que nos interesan (las características específicas de cada país y los atributos específicos del par) no sufren un retraso tan largo, ya podemos crear los grafos de los tres meses más recientes que queremos predecir, llamados meses objetivo. Con esta secuencia histórica de grafos, estamos listos para desarrollar nuestro modelo de aprendizaje automático.
Predecir los volúmenes comerciales con aprendizaje automático
Para nuestro problema implementaremos un enfoque que se enmarca en el aprendizaje supervisado. Primero entrenamos el modelo proporcionándole tanto los datos de las características como la variable objetivo.
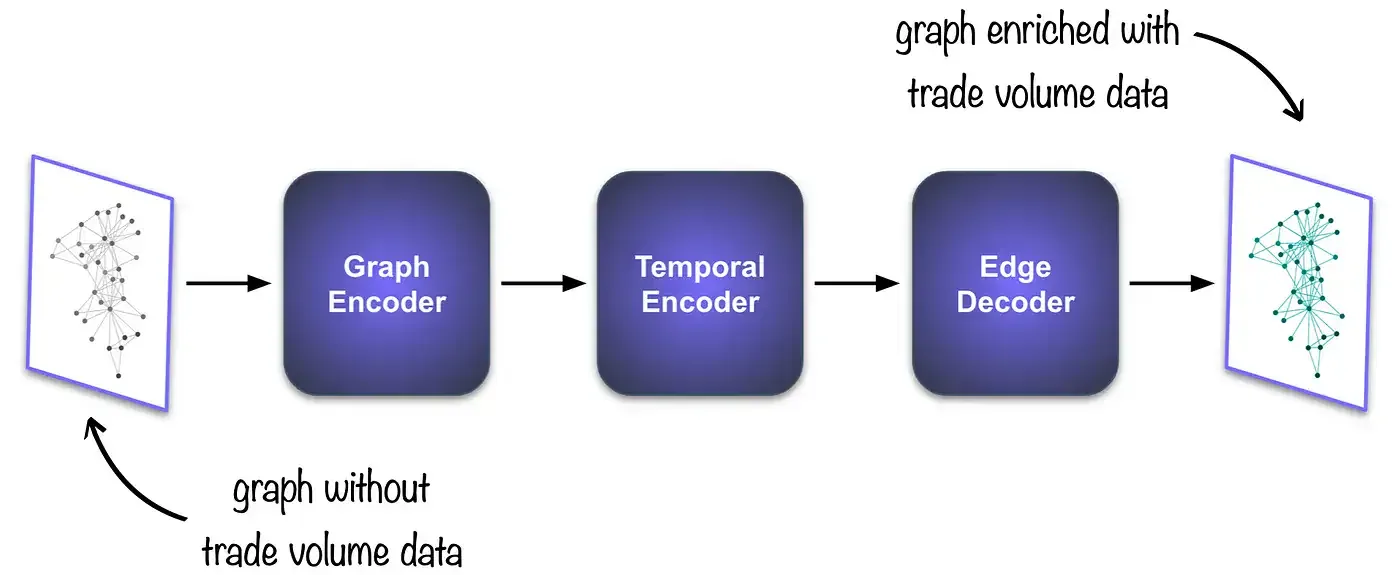
Tras entrenar el modelo con los meses históricos, le introduciremos una instantánea mensual de los meses objetivo, que contiene todas las características específicas de cada país y los atributos específicos del par, pero carece de datos de volumen comercial. El modelo la procesará y, a partir de los patrones que ha aprendido durante el entrenamiento, devolverá los volúmenes comerciales previstos para cada par de países.
Conocido el enfoque general, vamos a descomponer nuestro modelo en sus componentes. Después comentaremos los resultados. Las partes clave de nuestro modelo son:
- Codificador de grafos: para condensar cada grafo en un formato legible por máquina llamado embeddings.
- Codificador temporal: para extraer las relaciones temporales de los embeddings mensuales anteriores.
- Decodificador de aristas: para traducir los embeddings en predicciones de volúmenes comerciales.
Codificador de grafos: volvemos a las redes sociales.
En este componente nos interesa transformar de forma eficiente todos los datos almacenados en el grafo en una lista de números. Debido a las diferencias de formato, cierta pérdida de información es inevitable. Nuestro objetivo es minimizar esa pérdida.
Empleamos una red neuronal de grafos (GNN). Las GNN son capaces de combinar la información del nodo individual, de su vecindario y de los atributos de las aristas. Es como el dicho que sugiere que a una persona la definen mejor sus amigos más cercanos. El resultado de la GNN se denomina embeddings de nodos.
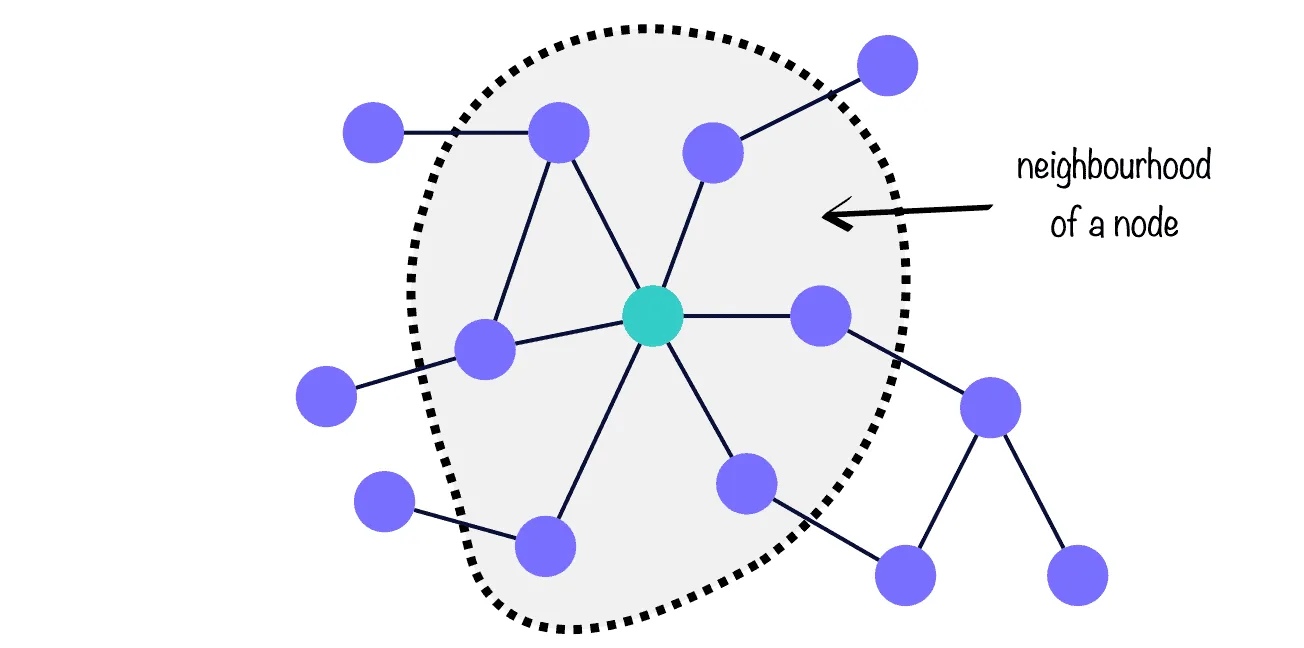
Y, al igual que en nuestras redes sociales algunos amigos influyen más en nosotros que otros, lo mismo ocurre con los nodos de un grafo. En la jerga de las GNN esto se llama atención, y la utilizamos en nuestro modelo para ordenar las rutas comerciales según lo informativas que sean a la hora de predecir otras rutas comerciales.
Codificador temporal: inspirado en ChatGPT
Esta unidad aprende cómo se relaciona un mes concreto con los que lo preceden. La idea es que las condiciones de mercado de un mes están influidas por el estado del mercado de los meses anteriores. Empleamos el Transformer, una arquitectura de vanguardia que está en la base de modelos de lenguaje como ChatGPT por su capacidad para realizar predicciones «sequence-to-sequence».
Imagine un escenario de predicción de escritura. Dada una frase (una secuencia de palabras), el Transformer entiende el orden de las palabras y su importancia para transmitir el mensaje, todo ello en relación con el contexto general de la frase. Después devuelve la palabra con mayor probabilidad de ser la siguiente de la secuencia.
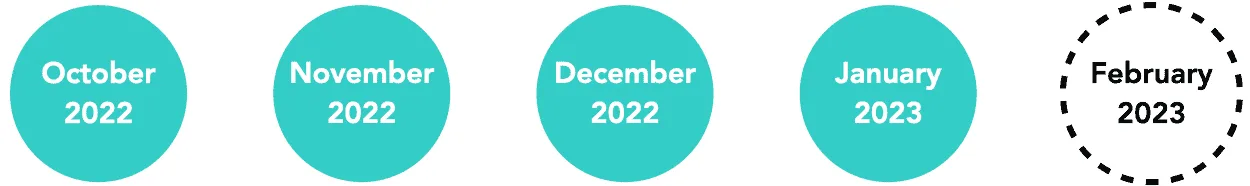
Aplicamos esta estructura a nuestro problema de forma ingeniosa: cada instantánea mensual se trata como una palabra y el Transformer devuelve los embeddings de nodos más probables para el mes siguiente de la secuencia.
Decodificador de aristas: dar sentido a los embeddings de nodos.
La función de este componente puede verse como la inversa del Codificador de grafos. En lugar de crear embeddings, descifra los embeddings que recibe del Codificador temporal y los convierte en predicciones de la variable objetivo. Implementamos dos redes neuronales y fijamos el objetivo de tomar pares de embeddings y extraer un único número: la previsión del volumen comercial entre dos países.
El resultado es una unidad capaz de reconstruir el volumen comercial de cada par de países dentro del grafo para el mes de interés. Así, cuanto mejor sea el Decodificador de aristas, más cerca estarán las predicciones de los valores reales.
Los resultados
Para evaluar el rendimiento de nuestro modelo, tomamos los tres meses más recientes (con datos de volumen comercial disponibles) y se los introducimos al modelo. Después comparamos las predicciones con los valores verdaderos. Para que la prueba fuera válida, nunca mostramos esos tres meses al modelo.
El modelo destaca a la hora de predecir cuándo no hay comercio entre dos países. También funciona bien al predecir cuándo los volúmenes comerciales son excepcionalmente altos. Esto podría deberse al enorme tamaño de esos volúmenes comerciales, que se desvían significativamente del valor medio de los datos y que, por lo tanto, son fácilmente reconocibles para el modelo.
Curiosamente, tiene dificultades con los volúmenes comerciales medios. Al comparar nuestras predicciones con los métodos tradicionales de previsión de series temporales, queda claro que, para mejorar la precisión de nuestro modelo, necesitamos facilitar la distinción entre las rutas comerciales medias que se parecen más entre sí. Esto se puede lograr incorporando más características de los datos, que ayudan a crear una representación más rica del mercado, e incluyendo información comercial de otras materias primas.
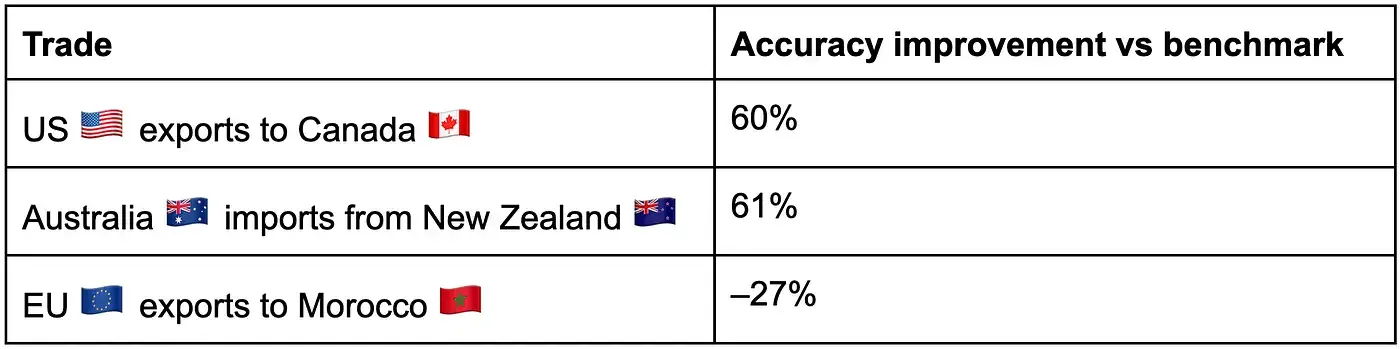
Teniendo en cuenta estas consideraciones, la mejora media de nuestro modelo en el conjunto de las rutas comerciales es insignificante, y resulta más informativo estudiar pares individuales. A continuación puede ver el rendimiento de nuestro modelo en dos rutas con volúmenes negociados muy altos y en una ruta media. Como puede comprobar, los resultados difieren mucho.