Milchwirtschaft trifft Machine Learning: ein leicht verständlicher Überblick über die Vorhersage von Handelsvolumina mit Graph Neural Networks und Transformern
Verzögerter Geschmack
Jede Minute werden weltweit rund 22 Tonnen Butter produziert. Daraus entsteht eine komplexe Handelslandschaft mit über 2.300 erfassten Transaktionen pro Monat. Angesichts der breiten Verwendung von Butter und ihrer zahlreichen Folgeprodukte ist es für Einkäufer, Verkäufer und Händler unerlässlich, den Handel zu verfolgen, sodass sie bei geschäftlichen Entscheidungen informiert sind.
Der Zugang zu Echtzeit-Erkenntnissen ist jedoch eine Herausforderung. Weil die Datenerhebung vollständig auf staatliche Stellen angewiesen ist, besteht eine merkliche Verzögerung. Im Schnitt dauert es drei Monate, bis alle Länder ihre Handelsvolumina melden.
Unser Ziel? Die Meldeverzögerung vollständig beseitigen. Wir wollen modernste Technologien einsetzen, um die letzten drei Monate der internationalen Handelsvolumina zu prognostizieren und die Lücke damit faktisch zu schließen.
Probleme wie dieses zu lösen, steht im Zentrum von Vesper. Wir streben danach, die umfassendste Commodity-Intelligence-Plattform aufzubauen, und wir verbinden hochwertige Daten und Fachwissen mit Data Science, um einzigartige Tools für unsere Nutzer zu schaffen.
In diesem Artikel geben wir einen Überblick über unsere Umsetzung. Wir beginnen damit, Sie durch die Dynamik des Buttermarktes zu führen, gefolgt von einer Einführung in unsere neuartige Problemdarstellung mit temporalen Graphen. Anschließend lernen Sie die Grundlagen unseres Machine-Learning-Modells kennen, mit einer kurzen Zusammenfassung zu jeder seiner drei entscheidenden Komponenten. Und zum Schluss geben wir Einblick in die Ergebnisse.
Butter verteilt sich über die ganze Welt
Butter gehört zu den am aktivsten gehandelten Rohstoffen der Milchwirtschaft. Jeden Monat überqueren Zehntausende Tonnen Butter internationale Grenzen. Allein die EU, Neuseeland und die Vereinigten Staaten verschifften 2022 durchschnittlich rund 46.000 mt pro Monat. Diese Ein- und Ausfuhren reichen von bloßen Bruchteilen bis zu Zehntausenden Tonnen.
Der internationale Buttermarkt funktioniert weitgehend als Oligopol. Die drei dominierenden Überschussproduzenten sind die USA, Neuseeland und die Länder der EU, die alle um die Nachfrage der übrigen Länder konkurrieren. 2022 exportierten die Europäische Union, Neuseeland und die Vereinigten Staaten zusammen rund 555.000 Tonnen Butter. Andere Länder produzieren zwar selbst Butter, wenden sich für zusätzliche Mengen aber häufig an einen der drei großen Akteure.
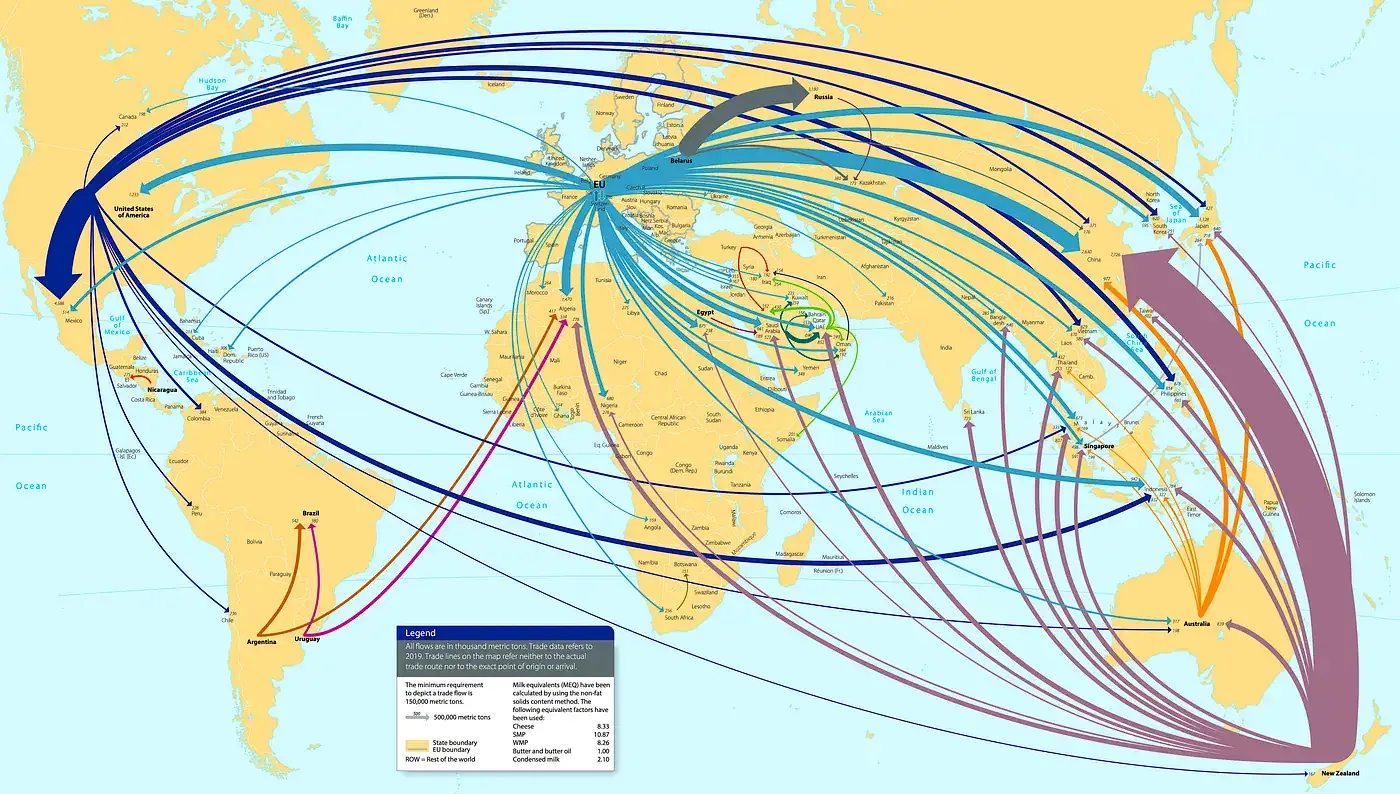
Im Laufe der Jahre haben viele Länder dank Handelsabkommen und günstiger geopolitischer Bedingungen feste Handelsrouten zu diesen großen Produzenten aufgebaut. Folglich verläuft der Handel mit diesen großen Akteuren in Volumen und Zeitpunkt in der Regel gleichmäßig. Das gilt im Vergleich zu Buttergeschäften zwischen anderen Länderpaaren, die tendenziell sporadischer ausfallen. Häufig von kurzfristigen Ereignissen beeinflusst, ist ihr Charakter deutlich „zufälliger“ und damit schwerer vorherzusagen.
Aus Sicht des Einkäufers hängt die Wahl des großen Produzenten, bei dem Butter beschafft wird, von vielen Faktoren ab. Da Butter ein Rohstoff ist, sind die Unterschiede gering, wenn nicht vernachlässigbar. Ausschlaggebend ist daher in erster Linie der Unterschied in den Angebotspreisen der großen Akteure, gefolgt von Zöllen und Transportkosten.
Problemdarstellung: ein riesiges soziales Netzwerk.
Wir nutzen Graphen, um die Dynamik des Butterhandelsmarktes wirksam abzubilden. Anders als herkömmliche Tabellen, die Datenpunkte einzeln auflisten, betonen Graphen die Verbindungen zwischen ihnen und bewahren so die wertvollen Nuancen eines vernetzten Netzwerks. Dazu gehören die Arten und Stärken der Beziehungen zwischen den Datenpunkten.
Um sich Graphen besser vorzustellen, denken Sie an Ihr soziales Netzwerk aus Freunden und Kollegen. Jeder Knoten ist eine Person, und jede Kante steht für Ihre Beziehung zu dieser Person. Mit Graphen können wir Ihr gesamtes soziales Netzwerk abbilden, wobei die einzigartigen Eigenschaften der Personen als Knotenmerkmale erhalten bleiben und die Charakteristika der Beziehungen als Kantenattribute gespeichert werden.
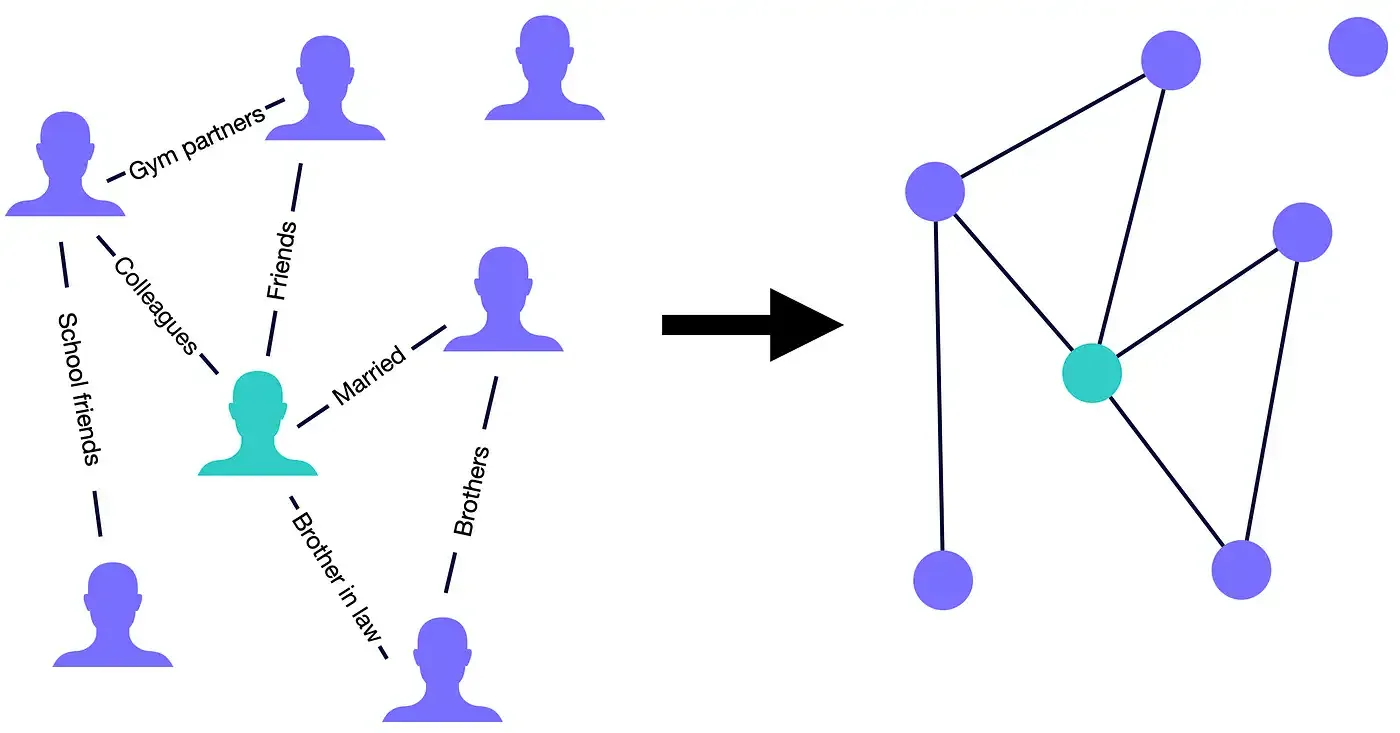
Ähnlich nutzen wir in unserem Szenario Knoten, um einzelne Länder darzustellen, und Kanten, um Handelsereignisse zwischen ihnen zu kennzeichnen. Jedes Land besitzt eine Reihe eigener Eigenschaften, die länderspezifische Merkmale heißen (in den Knoten gespeichert), etwa die heimische Butterproduktion oder das BIP. Hinzu kommen Charakteristika, die ausschließlich dem Länderpaar zukommen und paarspezifische Attribute heißen (in den Kanten gespeichert), etwa das Handelsvolumen oder der geltende Wechselkurs zwischen den jeweiligen Währungen.
Für den Aufbau des Graphen nutzen wir alle verfügbaren Import-Export-Daten ab Januar 2015. Zuerst fügen wir die verfügbaren 242 Knoten ein, einen für jedes „Land“. Dann wählen wir alle in diesem Zeitfenster erfassten Geschäfte aus. Das Ergebnis sind beeindruckende 267.376 Kanten.
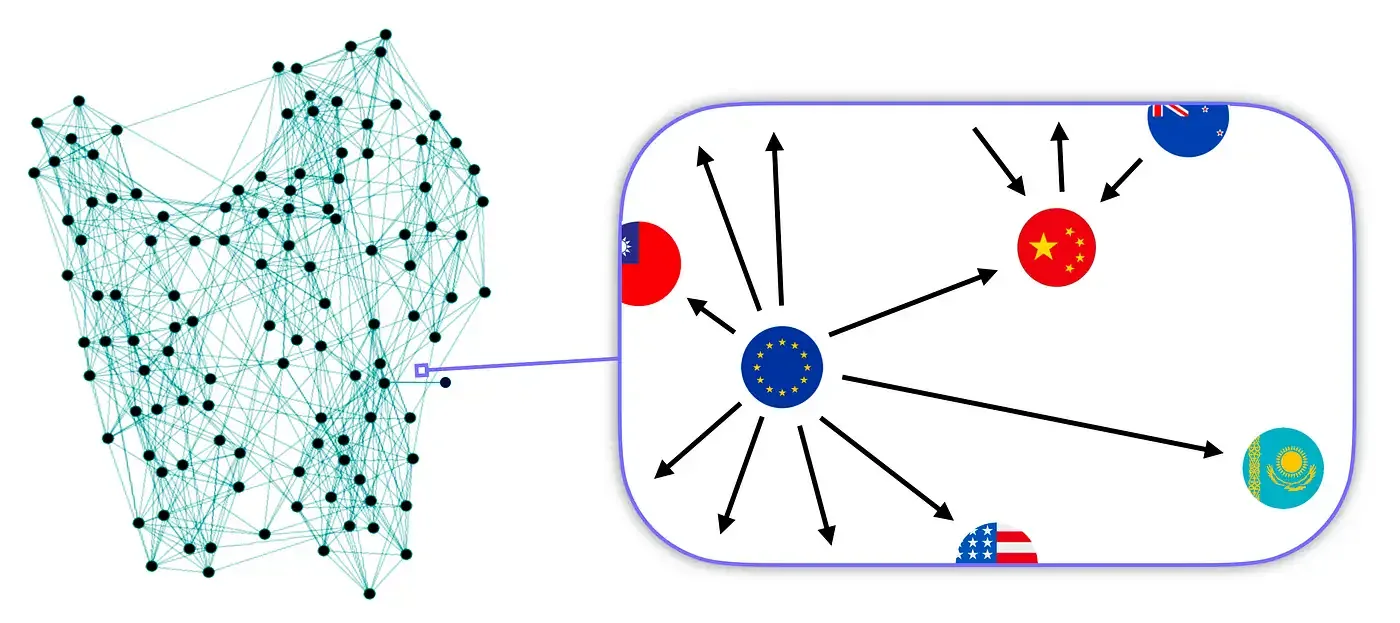
Um das Problem besser zu untersuchen, segmentieren wir die Daten monatlich. Das ergibt eine Folge leichterer Graphen mit rund 2.000 Kanten, die als Momentaufnahme des monatlichen Marktzustands dienen. Diese historische Folge von Graphen können wir als allgemeine Datenreihe interpretieren, die die Zeitreihen vieler einzelner Punkte bündelt. Eine Zeitreihe ist eine Menge von Messwerten einer einzelnen Variablen über die Zeit, zum Beispiel das Handelsvolumen zwischen nur einem Länderpaar.
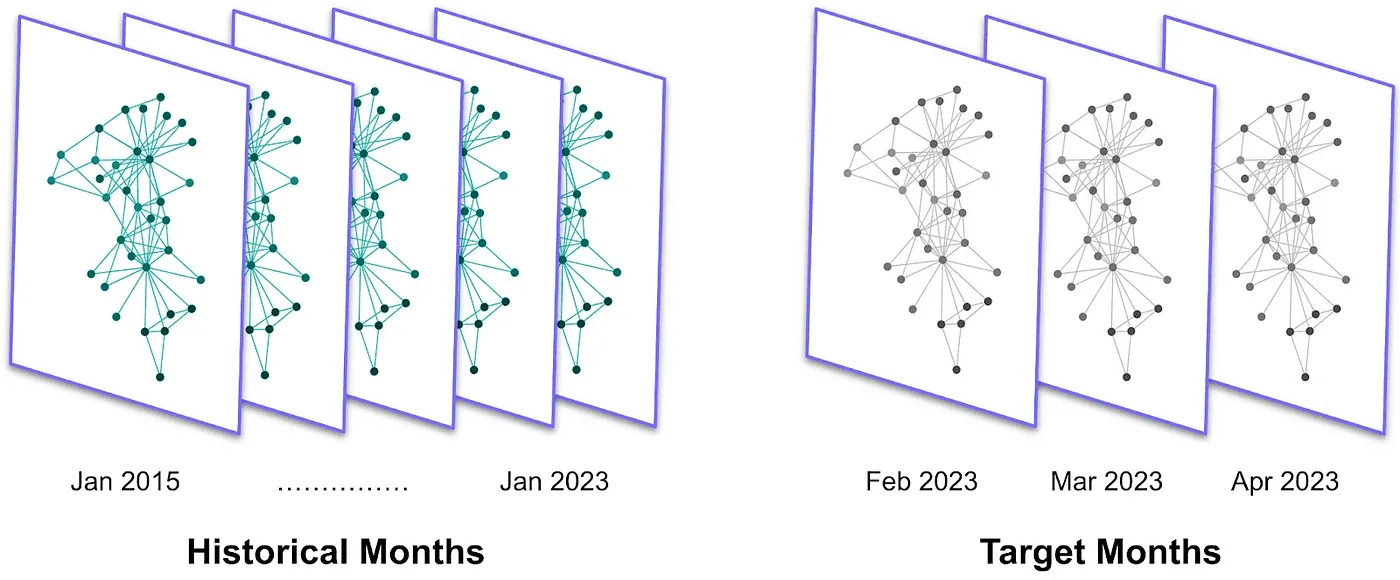
Der zentrale Vorteil unserer graphbasierten Darstellung ist ihre Fähigkeit, weltweite Trends zu erfassen. Indem wir alle Länderpaare in einer einzigen Struktur bündeln, können wir mehrere Routen gleichzeitig untersuchen. Herkömmliche Prognosemethoden können dagegen immer nur eine einzige Datenreihe verarbeiten.
Da zudem alle übrigen Variablen, die uns interessieren (länderspezifische Merkmale und paarspezifische Attribute), nicht unter einer so langen Verzögerung leiden, können wir die Graphen für die drei jüngsten Monate, die wir vorhersagen wollen, bereits erstellen; wir nennen sie Zielmonate. Mit dieser historischen Folge von Graphen sind wir bereit, unser Machine-Learning-Modell zu entwickeln.
Handelsvolumina mit Machine Learning vorhersagen
Für unser Problem setzen wir einen Ansatz um, der zum überwachten Lernen zählt. Zunächst trainieren wir das Modell, indem wir ihm sowohl die Merkmalsdaten als auch die Zielvariable geben.
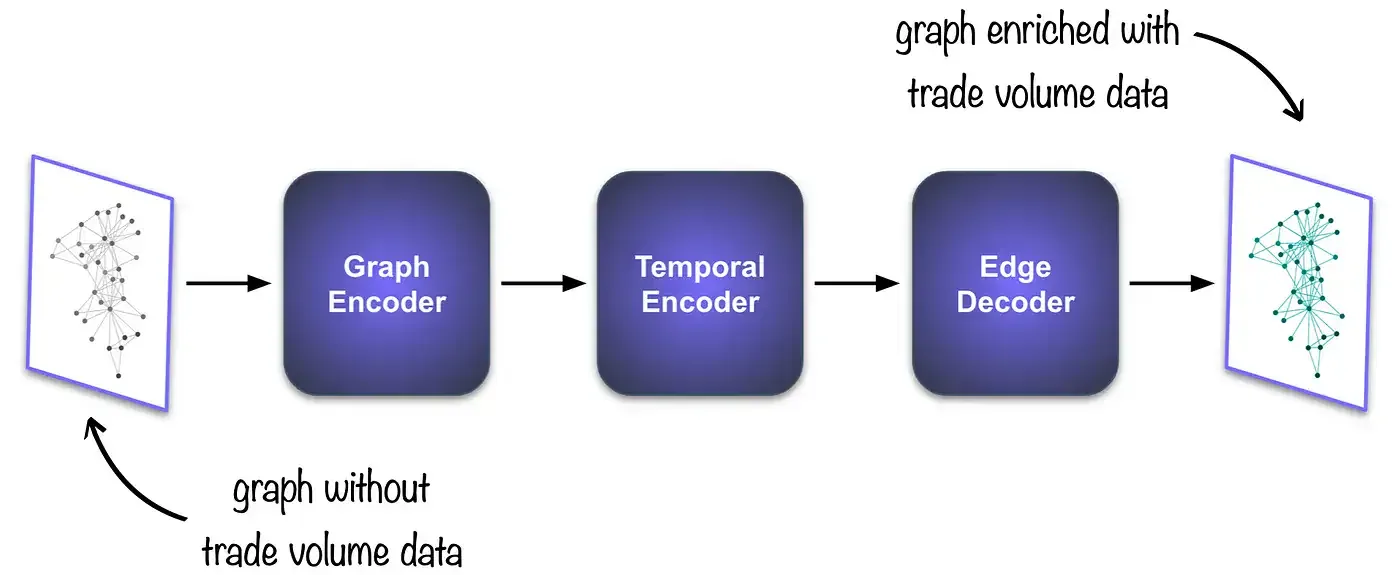
Nachdem wir unser Modell auf historischen Monaten trainiert haben, geben wir eine Monats-Momentaufnahme aus den Zielmonaten ein, die alle länderspezifischen Merkmale und paarspezifischen Attribute enthält, aber keine Daten zum Handelsvolumen. Das Modell verarbeitet sie und gibt dann, ausgehend von den im Training gelernten Mustern, die vorhergesagten Handelsvolumina für jedes Länderpaar aus.
Da der übergeordnete Ansatz nun klar ist, zerlegen wir unser Modell in seine Komponenten. Anschließend besprechen wir die Ergebnisse. Die zentralen Bestandteile unseres Modells sind:
- Graph-Encoder: verdichtet den einzelnen Graphen in ein maschinenlesbares Format namens Embeddings.
- Temporal-Encoder: extrahiert die zeitlichen Beziehungen aus den Embeddings früherer Monate.
- Kanten-Decoder: übersetzt die Embeddings in Vorhersagen für Handelsvolumina.
Graph-Encoder: zurück zu den sozialen Netzwerken.
Bei dieser Komponente geht es uns darum, alle im Graphen gespeicherten Daten effizient in eine Liste von Zahlen zu überführen. Wegen der Unterschiede in der Form ist ein gewisser Informationsverlust unvermeidlich. Unser Ziel ist es, diesen Verlust zu minimieren.
Wir setzen ein Graph Neural Network (GNN) ein. GNNs können Informationen aus dem einzelnen Knoten, seiner Nachbarschaft und den Kantenattributen kombinieren. Das ist wie der Spruch, der nahelegt, dass sich ein Mensch am besten über seine engsten Freunde definieren lässt. Die Ausgabe des GNN heißt Knoten-Embeddings.
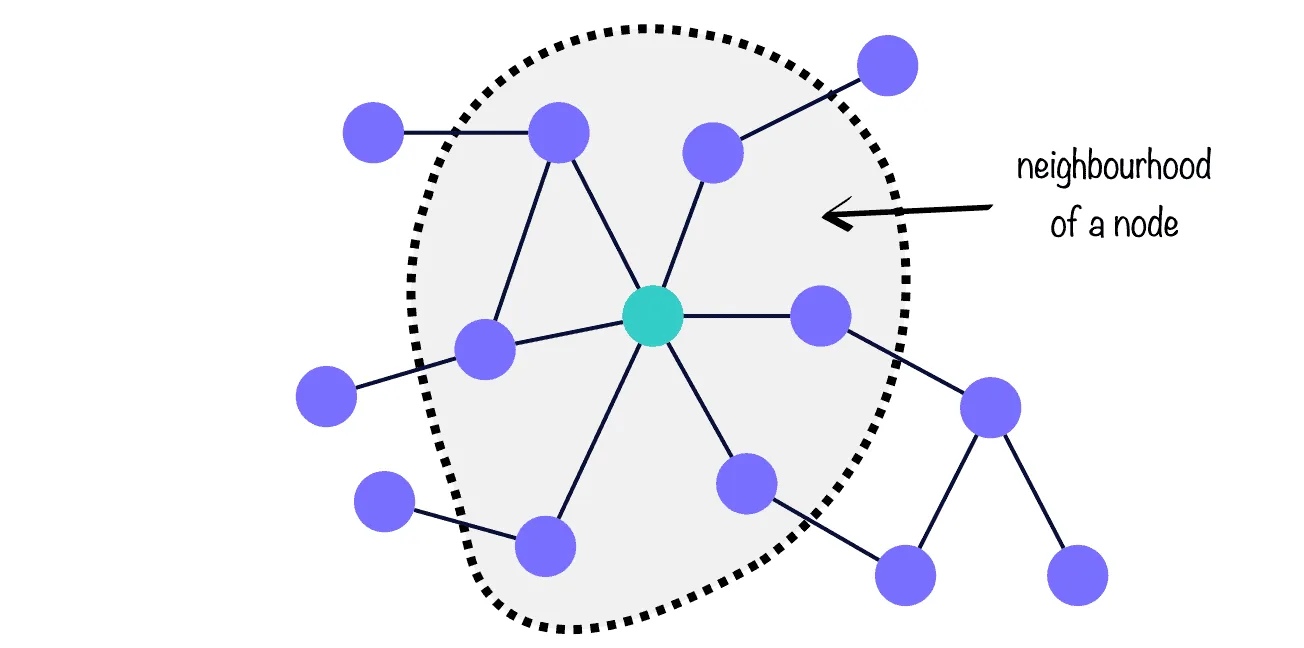
Und ganz wie in unseren sozialen Netzwerken, in denen manche Freunde mehr Einfluss auf uns haben als andere, gilt das Gleiche für Knoten in einem Graphen. Im GNN-Jargon heißt das Attention, und wir nutzen es in unserem Modell, um die Handelsrouten danach zu ordnen, wie aussagekräftig sie für die Vorhersage anderer Handelsrouten sind.
Temporal-Encoder: inspiriert von ChatGPT
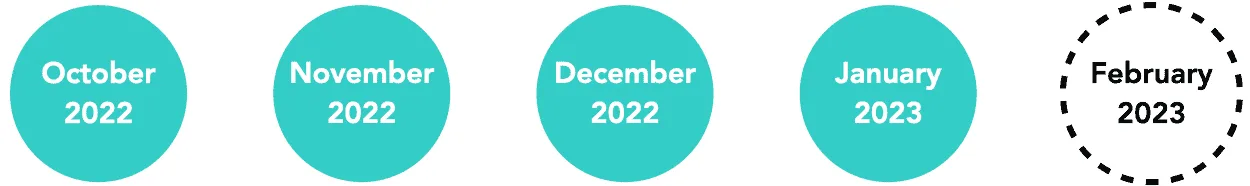
Diese Einheit lernt, wie ein bestimmter Monat mit seinen Vorgängern zusammenhängt. Die Idee ist, dass die Marktbedingungen eines Monats vom Marktzustand der vorangegangenen Monate beeinflusst werden. Wir setzen den Transformer ein, eine hochmoderne Architektur, die wegen ihrer Stärke bei „Sequence-to-Sequence“-Vorhersagen die Grundlage von Sprachmodellen wie ChatGPT bildet.
Stellen Sie sich die Wortvorhersage beim Tippen vor. Aus einem Satz (einer Folge von Wörtern) erfasst der Transformer die Reihenfolge der Wörter und ihre Bedeutung für die Botschaft, jeweils bezogen auf den Gesamtkontext des Satzes. Anschließend gibt er das Wort aus, das mit der höchsten Wahrscheinlichkeit als Nächstes in der Folge steht.
Diese Struktur übertragen wir geschickt auf unser Problem: Jede Monats-Momentaufnahme wird wie ein Wort behandelt, und der Transformer gibt die wahrscheinlichsten Knoten-Embeddings für den nächsten Monat der Folge aus.
Kanten-Decoder: Knoten-Embeddings verständlich machen.
Der Zweck dieser Komponente lässt sich als Umkehrung des Graph-Encoders verstehen. Statt Embeddings zu erzeugen, entschlüsselt der Kanten-Decoder die Embeddings, die er vom Temporal-Encoder erhält, zu Vorhersagen für die Zielvariable. Wir implementieren zwei neuronale Netze und setzen uns das Ziel, aus Paaren von Embeddings eine einzige Zahl zu gewinnen: die Prognose für das Handelsvolumen zwischen zwei Ländern.
Das Ergebnis ist eine Einheit, die das Handelsvolumen für jedes Länderpaar im Graphen für den betrachteten Monat rekonstruieren kann. Je besser der Kanten-Decoder, desto näher liegen die Vorhersagen damit an den tatsächlichen Werten.
Die Ergebnisse
Um die Leistung unseres Modells zu bewerten, nehmen wir die drei jüngsten Monate (für die Daten zum Handelsvolumen vorliegen) und geben sie in das Modell ein. Dann vergleichen wir die Vorhersagen mit den wahren Werten. Damit der Test valide ist, haben wir dem Modell diese drei Monate nie gezeigt.
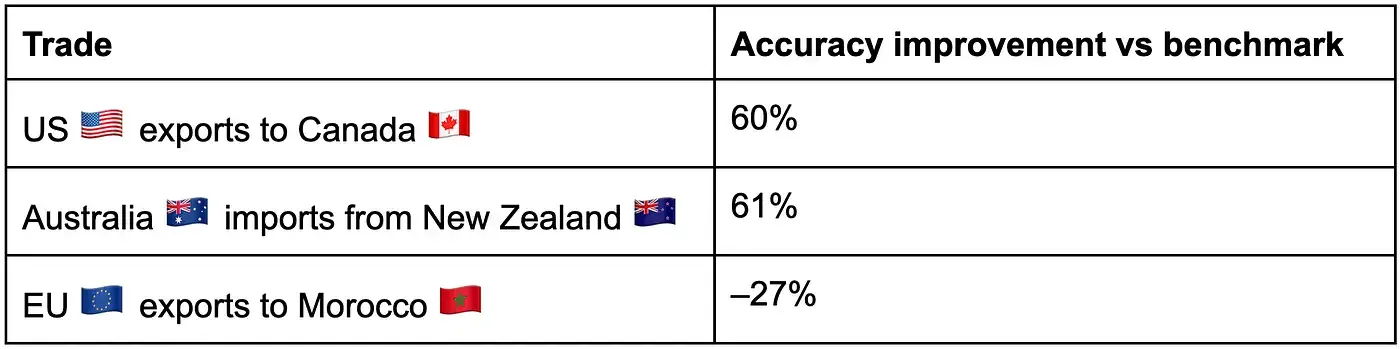
Das Modell ist besonders gut darin, vorherzusagen, wann zwischen zwei Ländern kein Handel stattfindet. Auch bei der Vorhersage außergewöhnlich hoher Handelsvolumina schneidet es gut ab. Das könnte an der schieren Größe dieser Handelsvolumina liegen, die deutlich vom Mittelwert in den Daten abweichen und daher für das Modell leicht erkennbar sind.
Interessanterweise tut es sich mit durchschnittlichen Handelsvolumina schwer. Wenn wir unsere Vorhersagen an traditionellen Prognosemethoden für Zeitreihen messen, wird deutlich: Um die Genauigkeit unseres Modells zu erhöhen, müssen wir die Unterscheidung zwischen durchschnittlichen Handelsrouten erleichtern, die einander ähnlicher sind. Erreichen lässt sich das, indem wir weitere Datenmerkmale einbeziehen, die zu einer reichhaltigeren Marktdarstellung beitragen, und indem wir Handelsinformationen zu anderen Rohstoffen aufnehmen.
Vor diesem Hintergrund ist die durchschnittliche Verbesserung unseres Modells über alle Handelsrouten hinweg vernachlässigbar, und es ist aufschlussreicher, einzelne Paare zu betrachten. Unten finden Sie die Leistung unseres Modells auf zwei Routen mit sehr hohen gehandelten Volumina und einer durchschnittlichen Route. Wie Sie sehen, unterscheiden sich die Ergebnisse stark.