乳制品遇上机器学习:用图神经网络与 Transformer 预测贸易量的入门概览
迟来的滋味
全球每分钟约生产 22 吨黄油。由此形成了复杂的贸易格局,每月有超过 2,300 笔记录在案的交易。鉴于黄油用途广泛、衍生产品众多,买方、卖方与贸易商必须关注贸易动向,确保在做出商业决策时掌握相关信息。
然而,获取实时洞察存在一个挑战。由于数据采集完全依赖政府机构,存在明显的滞后。平均而言,所有国家报告各自的贸易量需要三个月。
我们的目标?彻底消除报告滞后。我们希望采用最先进的技术,预测国际贸易量最近三个月的数值,从而有效弥合这一缺口。
解决这类问题正是 Vesper 的核心所在。我们致力于打造最全面的大宗商品情报平台,并把优质数据和专业知识与数据科学结合起来,为用户打造独特的工具。
本文概述我们的实现方式。我们先带您了解黄油市场的动态,接着介绍我们用时序图(temporal graph)表示问题的新颖方法。然后,您会了解我们机器学习模型的基础,以及它三个关键组件各自的简要说明。最后,我们会带您了解结果。
黄油抹向全世界
黄油是乳制品行业中交易最活跃的大宗商品之一。每个月都有数万吨黄油跨越国界。仅欧盟、新西兰与美国三方,2022 年每月平均出货量就约为 4.6 万吨。这些进出口量小到不足一吨,大到数万吨。
国际黄油市场在很大程度上以寡头垄断的方式运行。占据主导地位的三大过剩生产方是美国、新西兰和欧盟各国,它们都在争夺其他国家的需求。2022 年,欧盟、新西兰与美国合计出口了约 55.5 万吨黄油。其他国家虽然也在国内生产黄油,但往往会转向这三大参与者之一寻求额外供应。
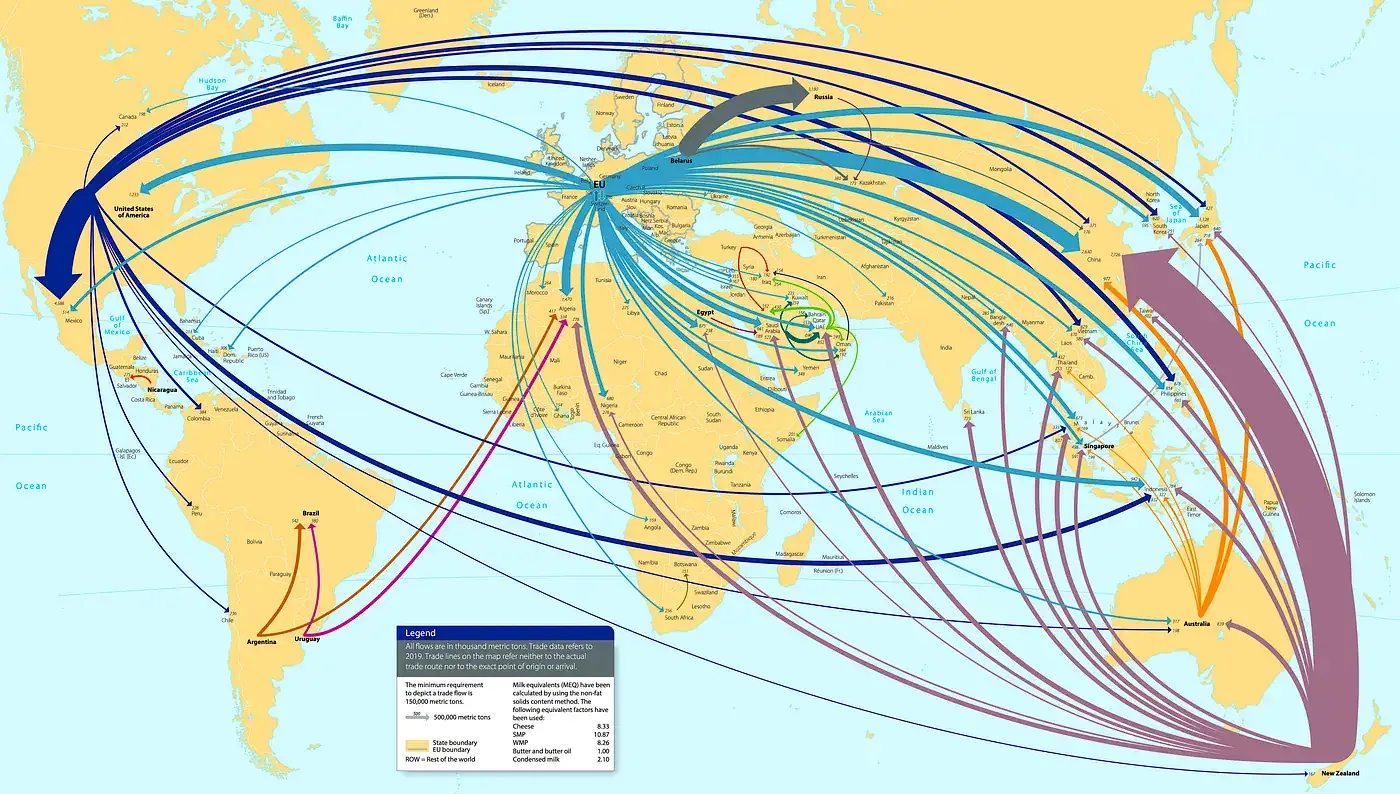
多年来,得益于贸易协定和有利的地缘政治条件,许多国家与这些主要生产方建立了稳固的贸易路线。因此,与这些大参与者之间的贸易往来,在数量和时间上通常是稳定的。这是相对于其他国家对之间的黄油贸易而言的,后者往往更为零星。它们常常受到短期事件的影响,性质上要“随机”得多,因此更难预测。
从买方的角度看,选择从哪家主要生产方采购黄油取决于许多因素。由于黄油是一种大宗商品,其间的差异很小,甚至可以忽略不计。因此,首要的决策驱动因素是各大参与者报价之间的差距,其次是关税和运输成本。
问题表示:一张庞大的社交网络。
我们用图(graph)来有效表示黄油贸易市场的动态。与把数据点分别罗列的常规表格不同,图强调数据点之间的联系,保留了一个相互关联的网络中那些有价值的细微差别。这包括数据点之间关系的类型和强度。
为了更好地想象图,可以想想您由朋友和同事组成的社交网络。每个节点是一个人,每条边代表您与这个人的关系。借助图,我们可以表示您的整个社交网络,把这些人的独特特质保留为节点特征,把关系的特点保存为边属性。
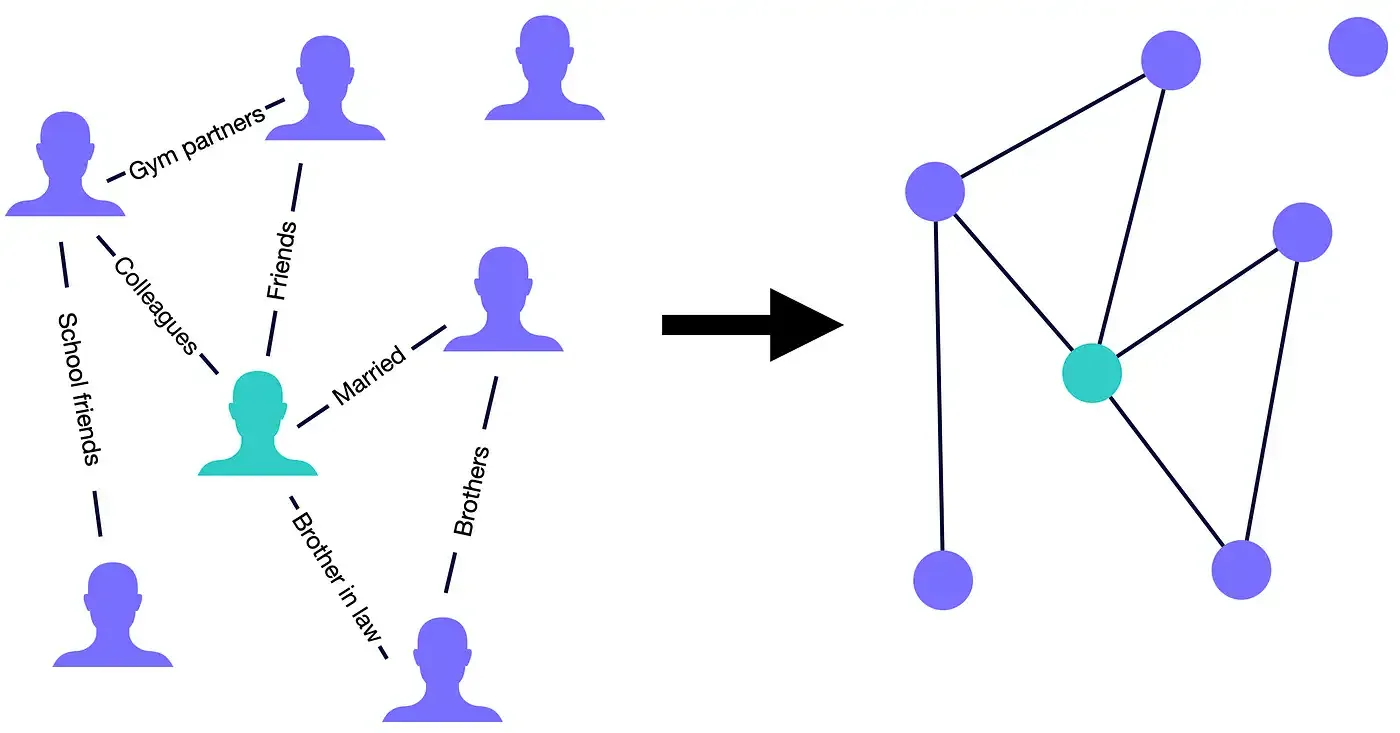
同样地,在我们的场景中,我们用节点来象征各个国家,用边来表示国家之间的贸易事件。每个国家都拥有一组与众不同的特质,称为国家特征(存储在节点中),例如国内黄油产量或国内生产总值(GDP)。此外,还有一些国家对独有的特点,称为国家对属性(保存在边中),例如贸易量或两国货币之间的现行汇率。
为构建这张图,我们使用了 2015 年 1 月以来全部可用的进出口数据。首先,我们放入可用的 242 个节点,每个“国家”一个。然后,我们选取该时间窗口内所有记录在案的贸易。结果是数量可观的 267,376 条边。
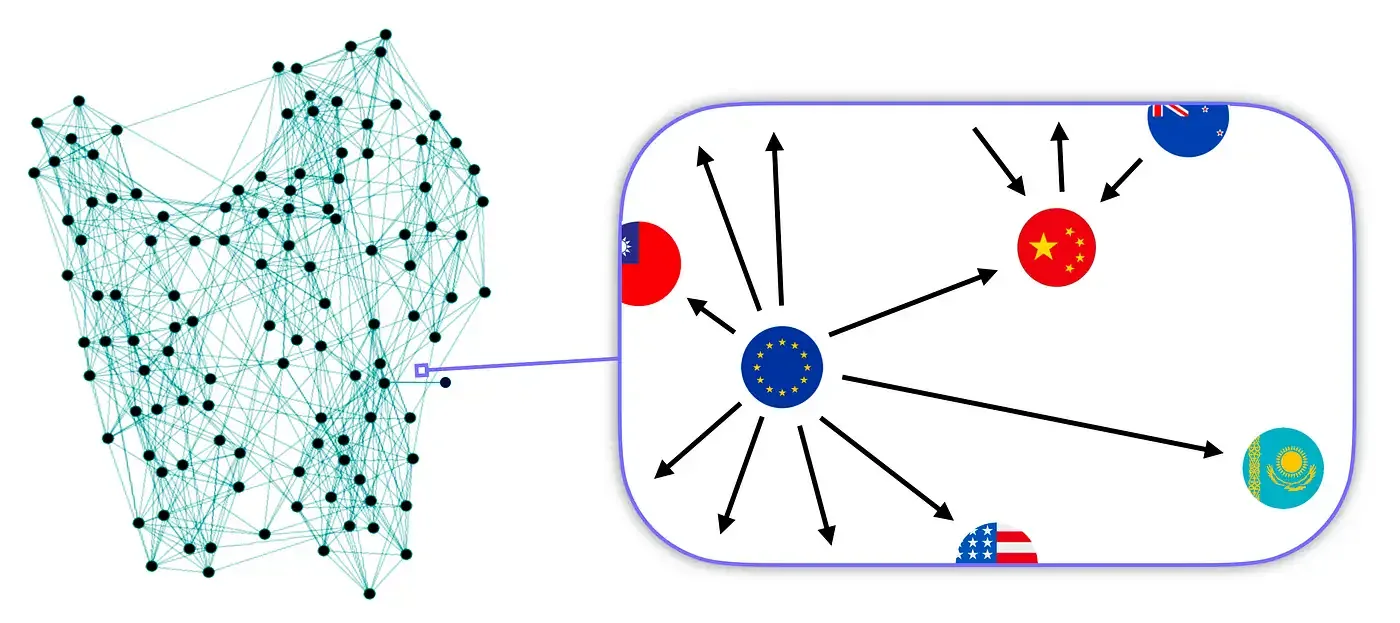
为了更好地研究这个问题,我们按月对数据分段。这会产生一串更轻量的图,每张约有 2,000 条边,作为市场月度状况的快照。我们可以把这一历史图序列理解为一个总体数据序列,它把许多单个点的时间序列聚合在一起。时间序列是对单一变量随时间变化的一组测量值,例如仅仅一对国家之间的贸易量。
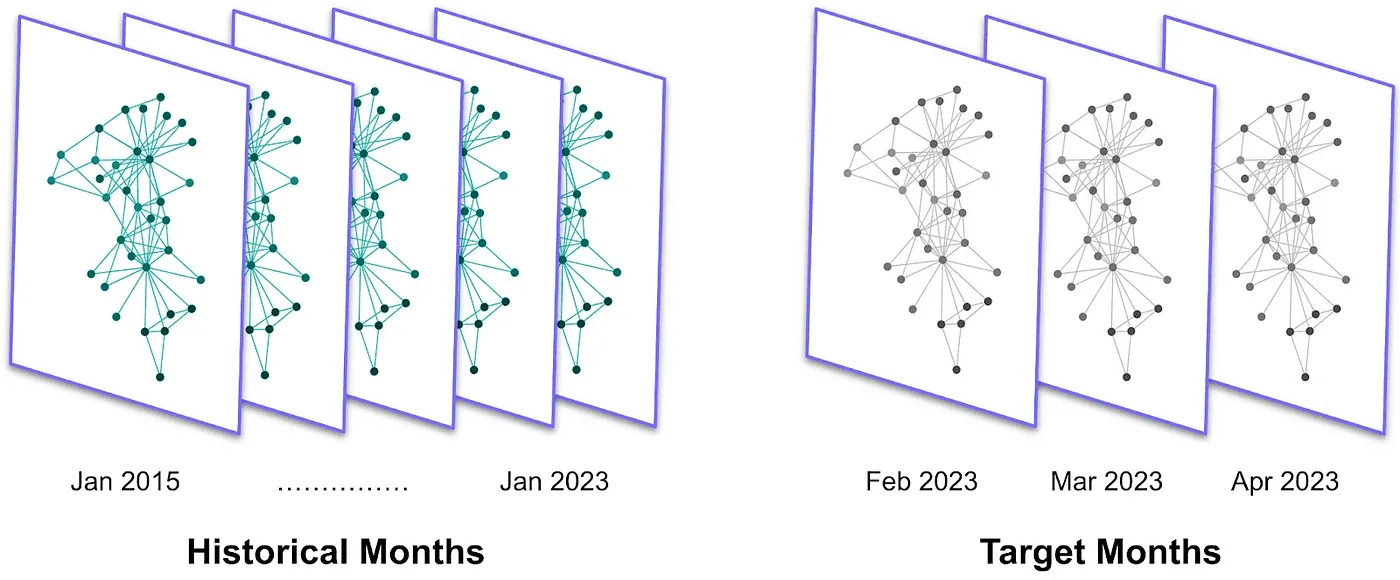
我们这种基于图的表示方法,关键优势在于能够捕捉全球范围的趋势。把所有国家对归入同一个结构之后,我们可以同时研究多条路线。相比之下,标准的预测技术一次只能处理一条数据序列。
此外,由于我们关注的其他所有变量(国家特征与国家对属性)并不存在这么长的滞后,我们已经可以为想要预测的最近三个月构建图,这三个月称为目标月份。有了这一历史图序列,我们就可以着手开发机器学习模型了。
用机器学习预测贸易量
针对我们的问题,我们将采用一种属于监督学习范畴的方法。首先,我们把特征数据和目标变量一起提供给模型,对它进行训练。
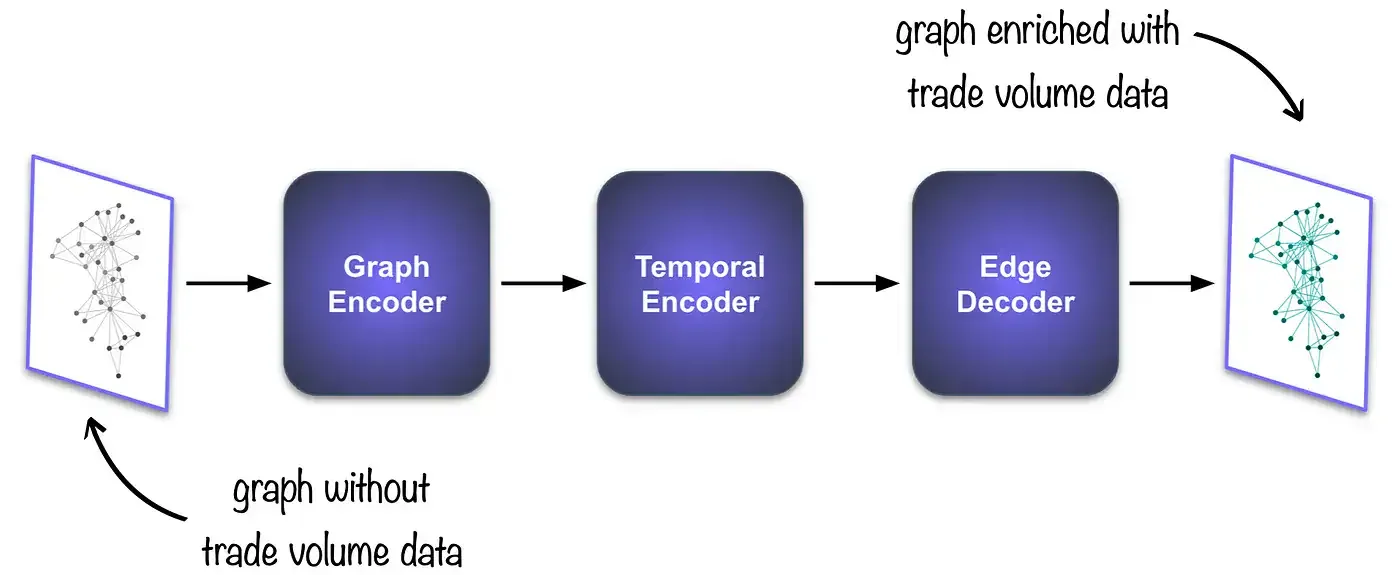
在用历史月份训练模型之后,我们会输入一张来自目标月份的月度快照,它包含全部国家特征与国家对属性,但缺少贸易量数据。模型会处理这张快照,然后根据训练中学到的模式,输出每一对国家的预测贸易量。
了解了总体思路之后,让我们把模型拆解成各个组件。之后我们会讨论结果。模型的关键部分包括:
- 图编码器(Graph Encoder):把单张图压缩成一种机器可读的格式,称为嵌入(embeddings)。
- 时序编码器(Temporal Encoder):从此前各月的嵌入中提取时间关系。
- 边解码器(Edge Decoder):把嵌入转换为贸易量预测。
图编码器:回到社交网络。
对这个组件而言,我们关心的是如何高效地把图中存储的全部数据转换成一串数字。由于形式上的差异,一定程度的信息损失不可避免。我们的目标是把这种损失降到最低。
我们使用图神经网络(Graph Neural Network,GNN)。图神经网络能够把来自单个节点、其邻域以及边属性的信息结合起来。这就像那句话说的,最能定义一个人的是他最亲近的朋友。图神经网络的输出称为节点嵌入。
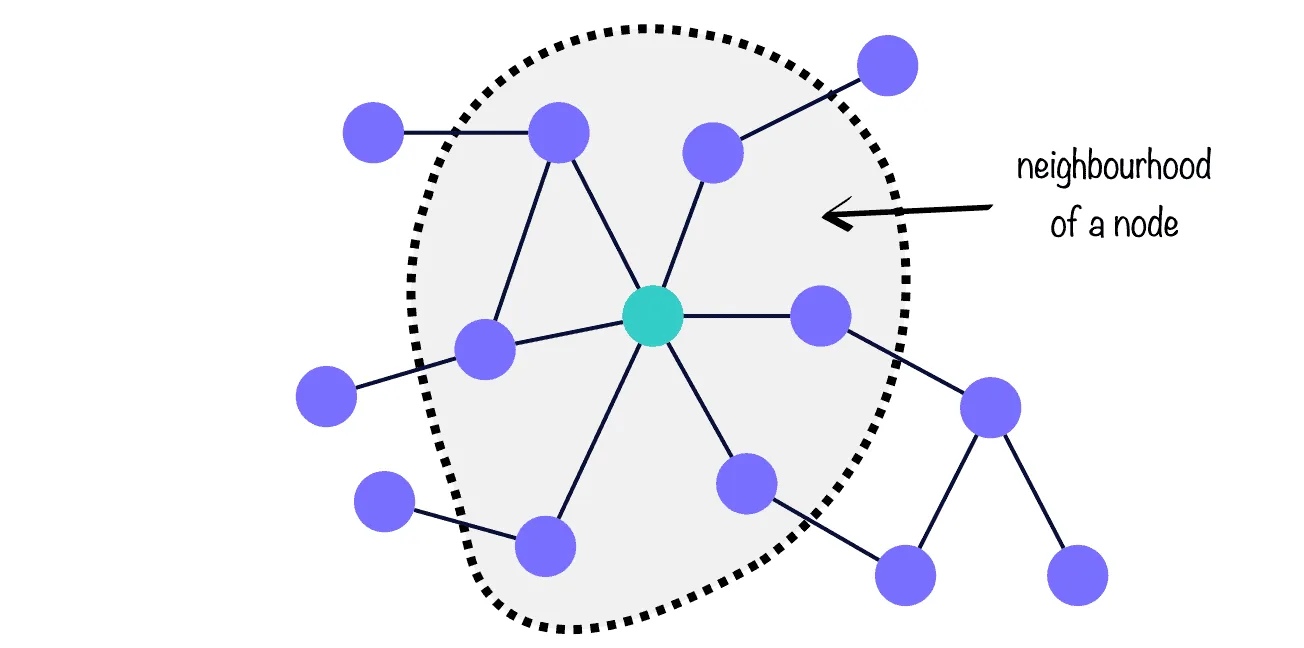
而且,就像在我们的社交网络里有些朋友对我们的影响比别人更大一样,图中的节点也是如此。在图神经网络的术语里,这被称为注意力(attention),我们在模型中用它来衡量哪些贸易路线对预测其他贸易路线信息量最大。
时序编码器:灵感来自 ChatGPT
这个单元学习某个特定月份与它前面几个月之间的关系。其思路是:一个月的市场状况会受到前面几个月市场状态的影响。我们采用 Transformer,这是一种前沿架构,凭借其做“序列到序列”预测的能力,成为 ChatGPT 等语言模型的基础。
想象一个打字预测的场景。给定一个句子(一串词),Transformer 会理解这些词的顺序,以及它们在传达信息时的重要性,而这一切都是相对于整句话的总体语境而言的。然后它会输出在序列中最有可能成为下一个的词。
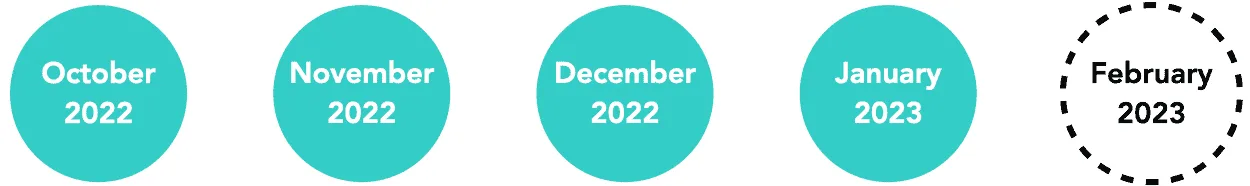
我们巧妙地把这一结构应用到我们的问题上:每一张月度快照都被当作一个词,Transformer 则输出序列中下一个月最有可能的节点嵌入。
边解码器:读懂节点嵌入。
这个组件的作用可以看作图编码器的逆过程。它不是生成嵌入,而是把从时序编码器收到的嵌入解读成对目标变量的预测。我们实现了两个神经网络,并设定这样的目标:接收成对的嵌入,从中提取出一个数字,也就是两国之间贸易量的预测值。
最终得到的是这样一个单元:它能为所关注的那个月重建图中每一对国家的贸易量。因此,边解码器越好,预测就越接近实际值。
结果
为评估模型的表现,我们取最近三个有贸易量数据的月份,把它们输入模型。然后,我们把预测值与真实值做比较。为了让这项测试有效,我们从未把这三个月给模型看过。
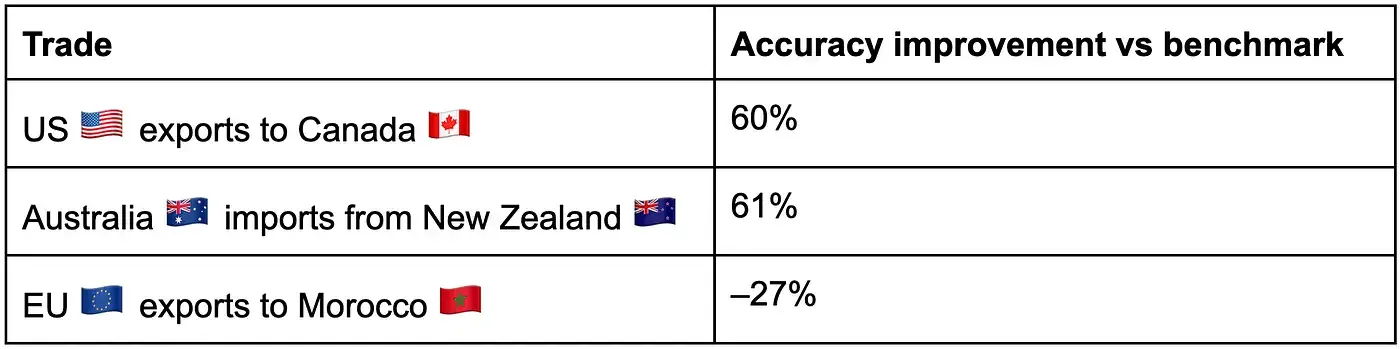
模型在预测两国之间不发生贸易的情形时表现出色。在预测贸易量异常高的情形时,它同样表现良好。这可能是由于这些贸易量本身规模巨大,明显偏离数据中的均值,因而容易被模型识别出来。
有意思的是,它在处理中等贸易量时表现吃力。当我们把预测结果与传统的时间序列预测方法做对标时,可以清楚地看到:要提高模型的准确度,我们需要让那些彼此更为相似的中等贸易路线更容易被区分开。做到这一点的办法,是纳入更多数据特征以帮助构建更丰富的市场表示,以及引入其他大宗商品的贸易信息。
考虑到这些因素,我们的模型在所有贸易路线上的平均改进幅度微乎其微,因此研究单个国家对更有信息量。下面,您可以看到我们的模型在两条贸易量非常高的路线和一条中等路线上的表现。如您所见,结果差异很大。