Laticínios encontram o machine learning: um panorama acessível da previsão de volumes de comércio com redes neurais de grafos e transformers
Sabor com atraso
A cada minuto, aproximadamente 22 toneladas métricas de manteiga são produzidas no mundo. Isso resulta em um cenário comercial complexo, com mais de 2.300 transações registradas por mês. Dados os muitos usos da manteiga e seus vários produtos derivados, é essencial que compradores, vendedores e traders acompanhem o comércio, garantindo que estejam bem informados na hora de decidir.
Ainda assim, há uma dificuldade no acesso a informações em tempo real. Como a coleta de dados depende inteiramente de órgãos governamentais, existe um atraso considerável. Em média, leva três meses até que todos os países reportem seus volumes de comércio.
Nosso objetivo? Eliminar completamente o atraso de divulgação. Queremos aplicar tecnologias de ponta para prever os últimos três meses de volumes de comércio internacional, fechando essa lacuna de fato.
Resolver problemas como esse está no centro da Vesper. Nos empenhamos em construir a plataforma de commodity intelligence mais completa, e combinamos dados de qualidade e expertise profissional com data science para produzir ferramentas únicas para nossos usuários.
Neste artigo, apresentamos um panorama da nossa implementação. Vamos começar percorrendo a dinâmica do mercado de manteiga, seguida de uma introdução à nossa nova forma de representar o problema usando grafos temporais. Em seguida, você vai conhecer os fundamentos do nosso modelo de machine learning, com um resumo breve de cada um dos seus três componentes essenciais. E, por fim, vamos comentar os resultados.
A manteiga se espalha pelo mundo
A manteiga é uma das commodities mais negociadas do setor de laticínios. Todo mês, dezenas de milhares de toneladas métricas de manteiga cruzam fronteiras internacionais. Só a UE, a Nova Zelândia e os Estados Unidos embarcaram uma média de cerca de 46.000 mt por mês em 2022. Essas importações e exportações vão de frações mínimas a dezenas de milhares de toneladas métricas.
O mercado internacional de manteiga funciona em grande medida como um oligopólio. Os três produtores excedentários dominantes são os EUA, a Nova Zelândia e os países da UE, todos disputando a demanda dos demais países. Em 2022, a União Europeia, a Nova Zelândia e os Estados Unidos exportaram juntos cerca de 555.000 toneladas métricas de manteiga. Outros países produzem manteiga internamente, mas costumam recorrer a um dos três grandes para suprimento adicional.
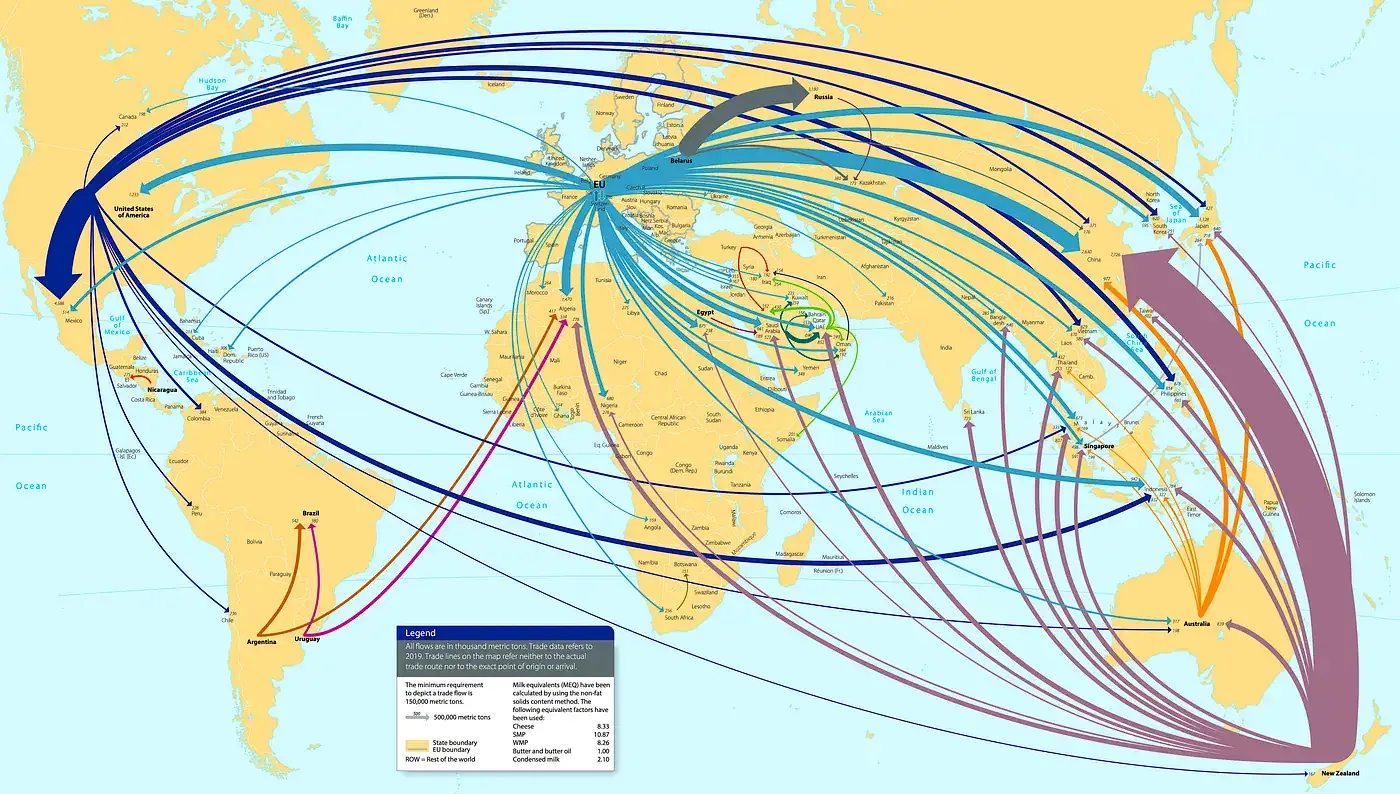
Ao longo dos anos, muitos países estabeleceram rotas comerciais sólidas com esses grandes produtores, graças a acordos comerciais e condições geopolíticas favoráveis. Por consequência, as interações comerciais com esses grandes players costumam ser consistentes em volume e em periodicidade. Isso vale em comparação com as negociações de manteiga entre outros pares de países, que tendem a ser mais esporádicas. Essas negociações são muitas vezes influenciadas por eventos de curto prazo, de modo que sua natureza é bem mais “aleatória” e, portanto, mais difícil de prever.
Do ponto de vista do comprador, a escolha de qual grande produtor usar como fonte de manteiga depende de muitos fatores. Como a manteiga é uma commodity, as diferenças são pequenas, quando não desprezíveis. Por isso, o principal motor da decisão é a discrepância nos preços ofertados pelos grandes players, seguida das tarifas e dos custos de transporte.
Representação do problema: uma vasta rede social.
Usamos grafos para representar a dinâmica do mercado de manteiga de forma eficaz. Diferentemente das tabelas convencionais, que listam os pontos de dados separadamente, os grafos destacam as ligações entre eles e preservam as nuances valiosas de uma rede interconectada. Isso inclui os tipos e as intensidades das relações entre os pontos de dados.
Para visualizar melhor os grafos, pense na sua rede social de amigos e colegas. Cada nó é uma pessoa, e cada aresta representa a sua relação com essa pessoa. Com grafos, conseguimos representar toda a sua rede social, preservando as qualidades únicas das pessoas como atributos dos nós e as características das relações guardadas como atributos das arestas.
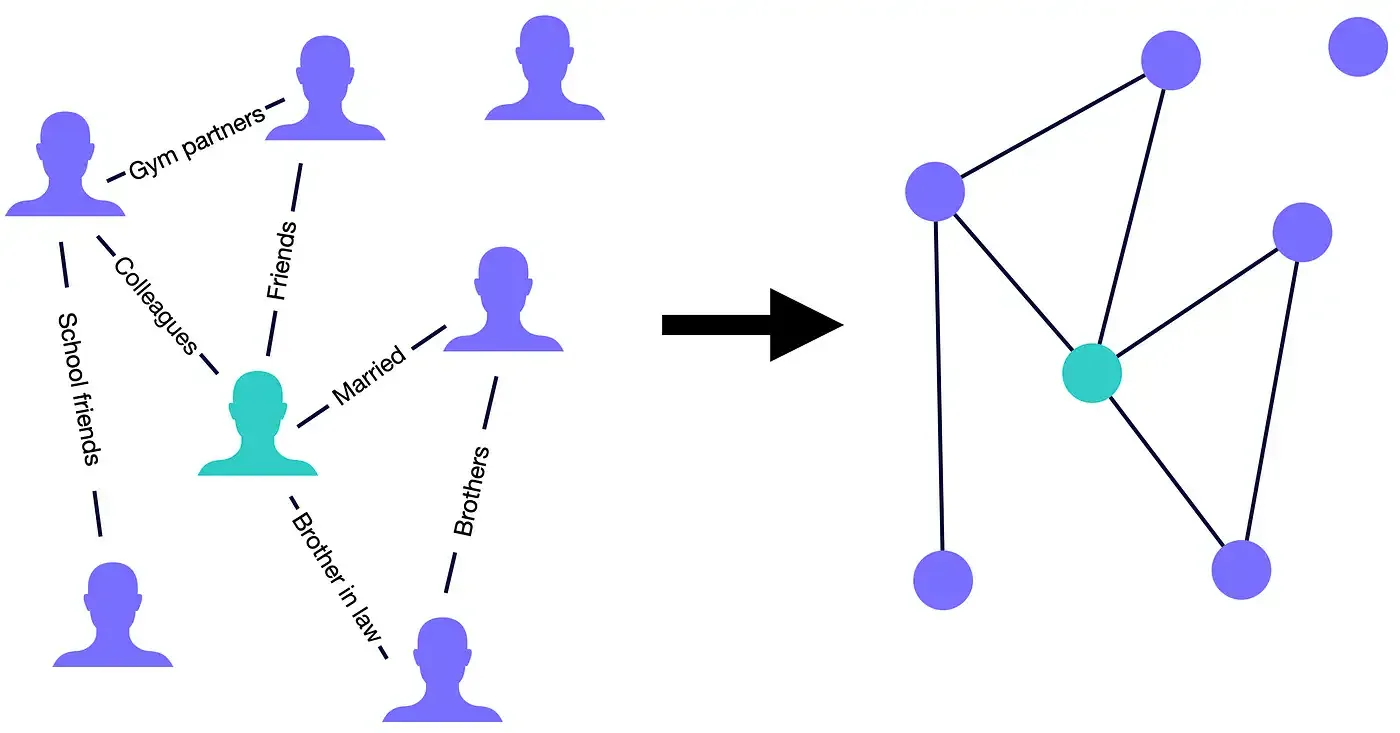
De forma parecida, no nosso cenário usamos os nós para simbolizar países individuais e as arestas para denotar eventos de comércio entre eles. Cada país possui um conjunto de qualidades próprias chamadas atributos específicos do país (armazenadas nos nós), como a produção doméstica de manteiga ou o PIB. Depois, há características exclusivas do par de países, chamadas atributos específicos do par (guardadas nas arestas), como o volume de comércio ou a taxa de câmbio vigente entre as respectivas moedas.
Para criar o grafo, usamos todos os dados de importação e exportação disponíveis a partir de janeiro de 2015. Primeiro, inserimos os 242 nós disponíveis, um para cada “país”. Depois, selecionamos todas as negociações registradas nessa janela de tempo. O resultado são impressionantes 267.376 arestas.
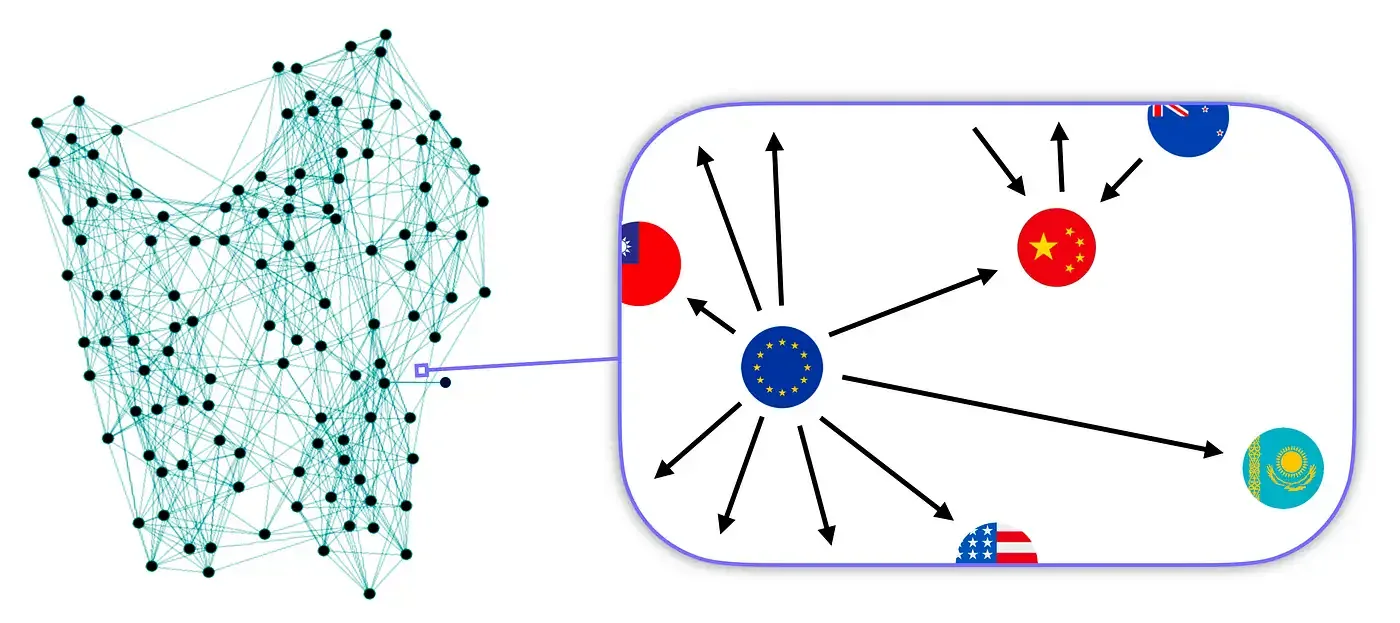
Para estudar melhor o problema, segmentamos os dados por mês. Isso gera uma sequência de grafos mais leves, com aproximadamente 2.000 arestas, e cada grafo funciona como um retrato do estado mensal do mercado. Podemos interpretar essa sequência histórica de grafos como uma série de dados geral que agrupa as séries temporais de muitos pontos individuais. Uma série temporal é um conjunto de medições de uma única variável ao longo do tempo, por exemplo, o volume de comércio entre apenas um par de países.
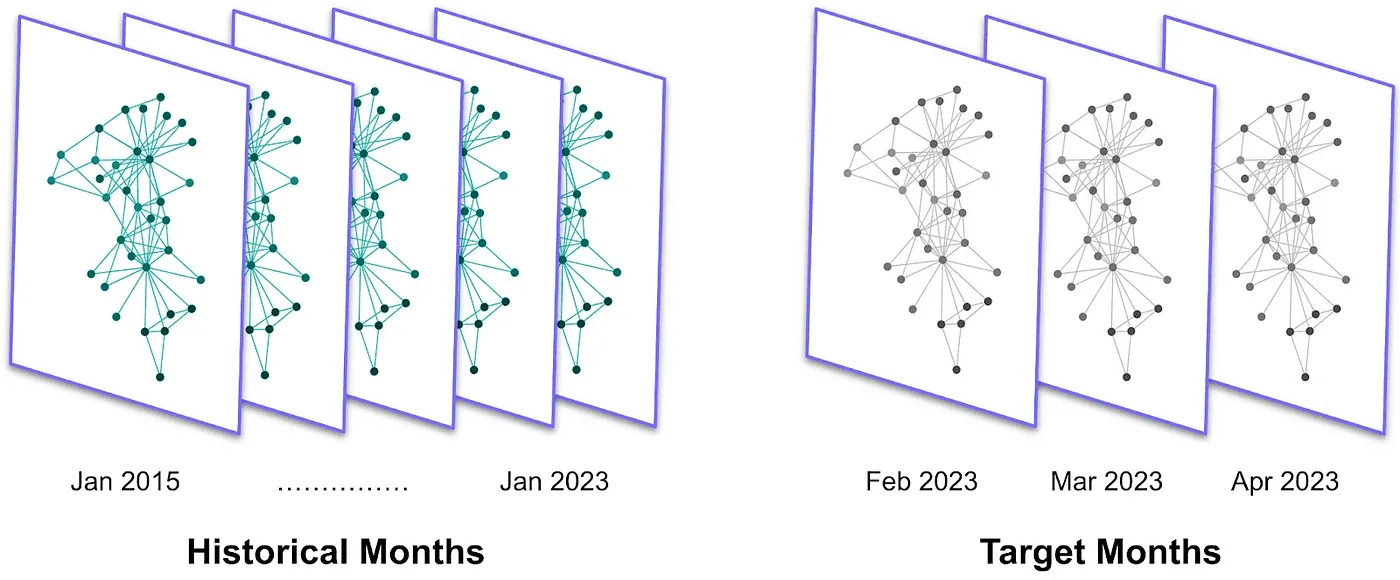
O principal benefício da nossa representação baseada em grafos é a capacidade de capturar tendências mundiais. Ao agrupar todos os pares de países em uma única estrutura, conseguimos estudar várias rotas ao mesmo tempo. Já as técnicas convencionais de previsão só conseguem lidar com uma série de dados por vez.
Além disso, como todas as outras variáveis que nos interessam (atributos específicos do país e atributos específicos do par) não sofrem com esse atraso longo, já conseguimos criar os grafos dos três meses mais recentes que queremos prever, chamados de meses-alvo. Com essa sequência histórica de grafos, estamos prontos para desenvolver nosso modelo de machine learning.
Prevendo volumes de comércio com machine learning
Para o nosso problema, vamos implementar uma abordagem que se enquadra no aprendizado supervisionado. Primeiro, treinamos o modelo fornecendo a ele tanto os dados de atributos quanto a variável-alvo.
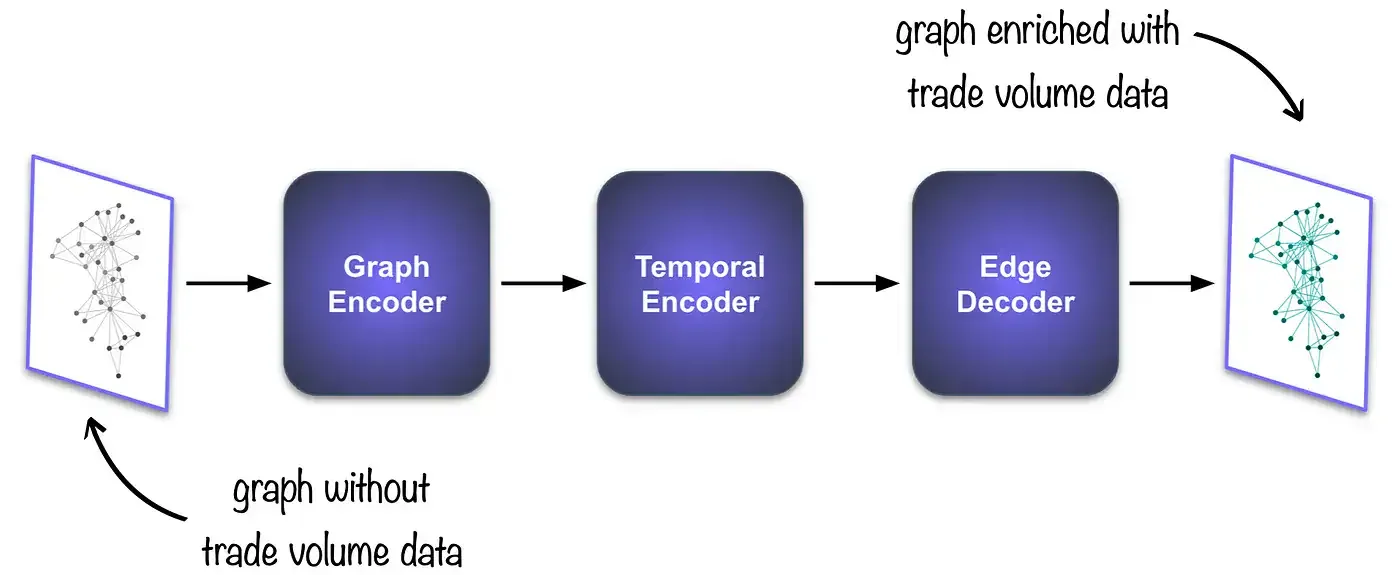
Depois de treinar o modelo com meses históricos, vamos alimentá-lo com um retrato mensal dos meses-alvo; esse retrato contém todos os atributos específicos do país e do par, mas não tem os dados de volume de comércio. O modelo processa esse retrato e, com base nos padrões que aprendeu durante o treinamento, devolve os volumes de comércio previstos para cada par de países.
Conhecida a abordagem geral, vamos dissecar nosso modelo em seus componentes. Depois, discutimos os resultados. As peças principais do nosso modelo são:
- Codificador de grafos: para condensar o grafo individual em um formato legível por máquina chamado embeddings.
- Codificador temporal: para extrair as relações temporais dos embeddings mensais anteriores.
- Decodificador de arestas: para traduzir os embeddings em previsões de volumes de comércio.
Codificador de grafos: de volta às redes sociais.
Neste componente, o que nos interessa é transformar com eficiência todos os dados guardados no grafo em uma lista de números. Por causa das diferenças de formato, alguma perda de informação é inevitável. Nosso objetivo é minimizar essa perda.
Usamos uma rede neural de grafos (GNN). As GNNs são capazes de combinar informações do nó individual, da sua vizinhança e dos atributos das arestas. É como o ditado que sugere que uma pessoa é melhor definida pelos amigos mais próximos. A saída da GNN se chama embeddings de nós.
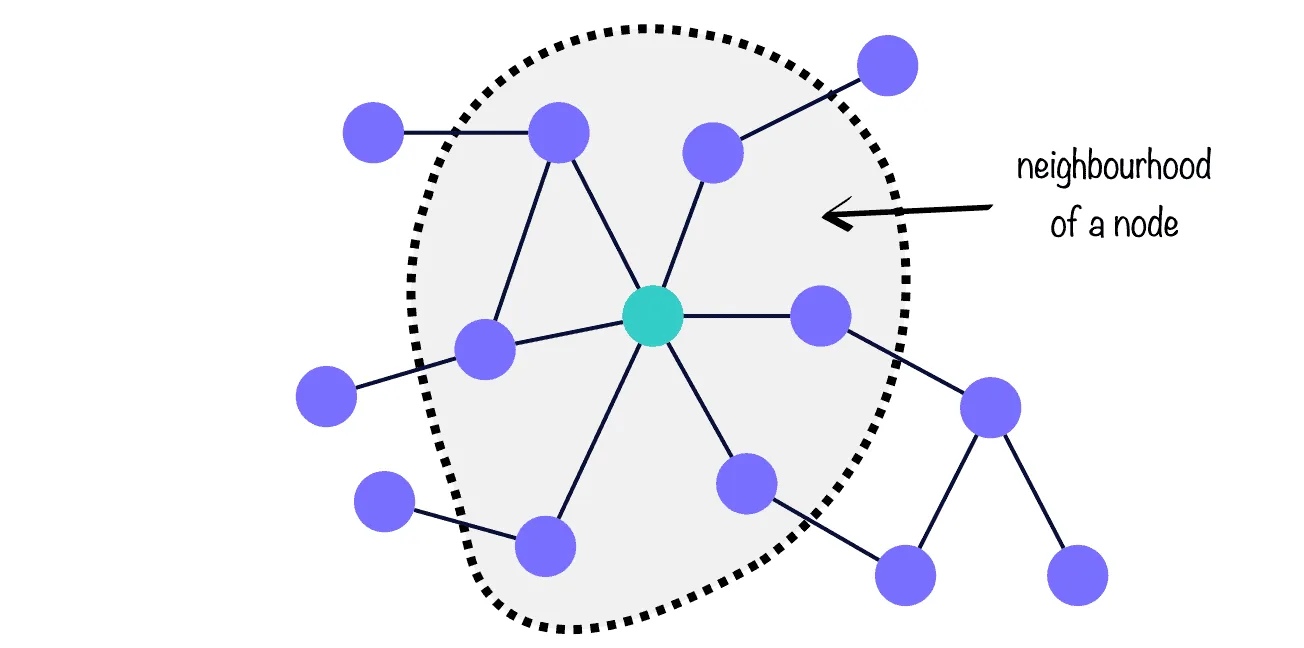
E, assim como nas nossas redes sociais, em que alguns amigos têm mais influência sobre nós do que outros, o mesmo vale para os nós de um grafo. No jargão das GNNs, isso se chama atenção, e nós a usamos no nosso modelo para classificar quais rotas comerciais são mais informativas na previsão de outras rotas comerciais.
Codificador temporal: inspirado no ChatGPT
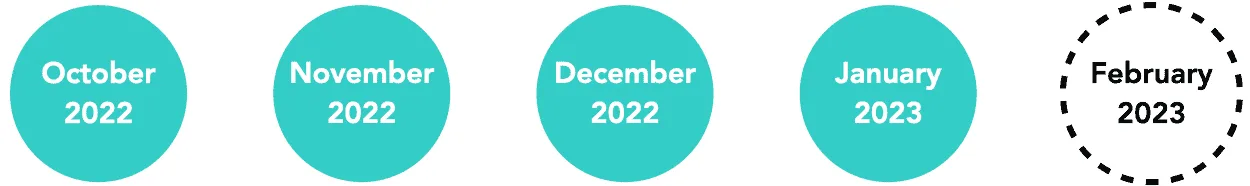
Esta unidade aprende como um mês específico se relaciona com os anteriores. A ideia é que as condições de mercado de um mês são influenciadas pelo estado do mercado nos meses precedentes. Usamos o Transformer, uma arquitetura de ponta que está na base de modelos de linguagem como o ChatGPT por causa da sua capacidade de fazer previsões “sequência a sequência”.
Imagine um cenário de previsão de digitação. Dada uma frase (uma sequência de palavras), o Transformer entende a ordem das palavras e a importância delas para transmitir a mensagem, tudo isso em relação ao contexto geral da frase. Ele então devolve a palavra com maior probabilidade de ser a próxima da sequência.
Aplicamos essa estrutura ao nosso problema com uma sacada: cada retrato mensal é tratado como uma palavra, e o Transformer devolve os embeddings de nós mais prováveis para o mês seguinte da sequência.
Decodificador de arestas: dando sentido aos embeddings de nós.
A função deste componente pode ser vista como o inverso da do codificador de grafos. Em vez de criar embeddings, ele decifra os embeddings que recebe do codificador temporal e os transforma em previsões da variável-alvo. Implementamos duas redes neurais e definimos como objetivo pegar pares de embeddings e extrair um único número: a previsão do volume de comércio entre dois países.
O resultado é uma unidade capaz de reconstruir o volume de comércio de cada par de países dentro do grafo para o mês de interesse. Assim, quanto melhor o decodificador de arestas, mais perto as previsões ficam dos valores reais.
Os resultados
Para avaliar o desempenho do nosso modelo, pegamos os três meses mais recentes (com dados de volume de comércio disponíveis) e os fornecemos ao modelo. Depois, comparamos as previsões com os valores reais. Para que o teste fosse válido, nunca mostramos esses três meses ao modelo.
O modelo se sai muito bem ao prever quando não há comércio entre dois países. Também tem bom desempenho ao prever quando os volumes de comércio são excepcionalmente altos. Isso talvez se deva ao tamanho desses volumes, que se afastam bastante do valor médio dos dados e, por isso, são facilmente reconhecíveis pelo modelo.
Curiosamente, ele tem dificuldade com volumes de comércio médios. Quando comparamos nossas previsões com métodos tradicionais de previsão de séries temporais, fica claro que, para melhorar a acurácia do nosso modelo, precisamos facilitar a distinção entre rotas comerciais médias que são mais parecidas entre si. Isso pode ser alcançado incorporando mais atributos de dados que ajudam a criar uma representação mais rica do mercado, e incluindo informações de comércio de outras commodities.
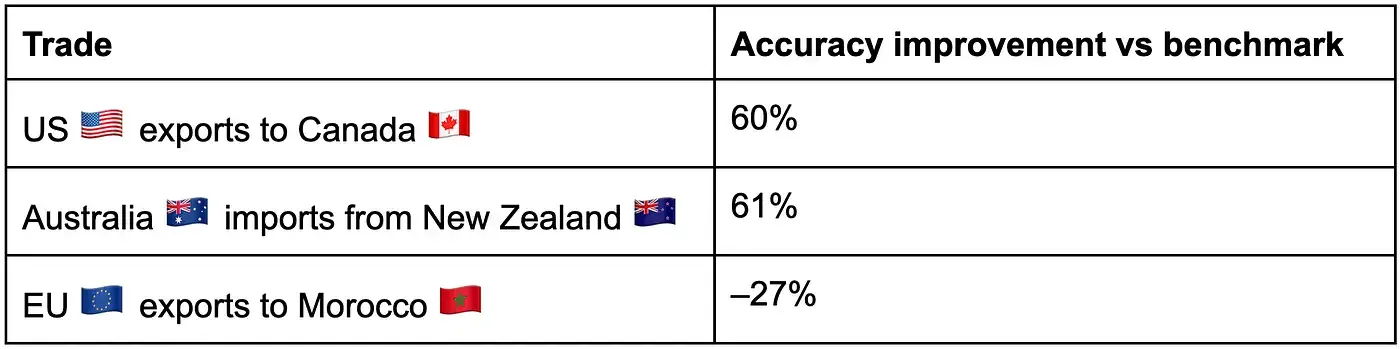
Diante dessas considerações, a melhoria média do nosso modelo em todas as rotas comerciais é desprezível, e é mais informativo estudar pares individuais. Abaixo, você encontra o desempenho do nosso modelo em duas rotas com volumes negociados muito altos e uma rota média. Como você pode ver, os resultados variam bastante.