Zuivel ontmoet machine learning: een toegankelijk overzicht van het voorspellen van handelsvolumes met graph neural networks en transformers
Vertraagde smaak
Elke minuut wordt er wereldwijd ongeveer 22 metrische ton boter geproduceerd. Dat levert een complex handelslandschap op, met maandelijks ruim 2.300 geregistreerde transacties. Gezien de vele toepassingen van boter en de talrijke afgeleide producten is het voor inkopers, verkopers en handelaren essentieel om de handel te volgen, zodat ze goed geïnformeerd zijn bij hun zakelijke beslissingen.
Toch is realtime inzicht lastig te krijgen. Doordat de dataverzameling volledig afhangt van overheidsinstanties, is er een aanzienlijke vertraging. Gemiddeld duurt het drie maanden voordat alle landen hun handelsvolumes rapporteren.
Ons doel? De rapportagevertraging volledig wegnemen. We willen state-of-the-art technologie inzetten om de laatste drie maanden aan internationale handelsvolumes te voorspellen en zo het gat te dichten.
Dit soort problemen oplossen staat centraal bij Vesper. We willen het meest complete platform voor grondstofinformatie bouwen, en we combineren kwalitatieve data en vakkennis met Data Science om unieke tools voor onze gebruikers te maken.
In dit artikel geven we een overzicht van onze implementatie. We beginnen met de dynamiek van de botermarkt, gevolgd door een introductie van onze nieuwe probleemrepresentatie met temporele grafen. Daarna leer je de basis van ons machine-learningmodel kennen, met een korte samenvatting van elk van de drie cruciale onderdelen. En tot slot geven we inzicht in de resultaten.
Boter verspreidt zich over de hele wereld
Boter is een van de meest actief verhandelde grondstoffen in de zuivelsector. Elke maand steken tienduizenden metrische ton boter internationale grenzen over. Alleen de EU, Nieuw-Zeeland en de Verenigde Staten verscheepten in 2022 gemiddeld zo’n 46.000 mt per maand. Die import en export kunnen variëren van fracties tot tienduizenden metrische ton.
De internationale botermarkt werkt grotendeels als een oligopolie. De drie dominante overschotproducenten zijn de VS, Nieuw-Zeeland en de EU-landen; alle drie concurreren ze om de vraag van de andere landen. In 2022 exporteerden de Europese Unie, Nieuw-Zeeland en de Verenigde Staten samen ongeveer 555.000 metrische ton boter. Andere landen produceren zelf boter, maar wenden zich voor extra aanbod vaak tot een van de drie grote spelers.
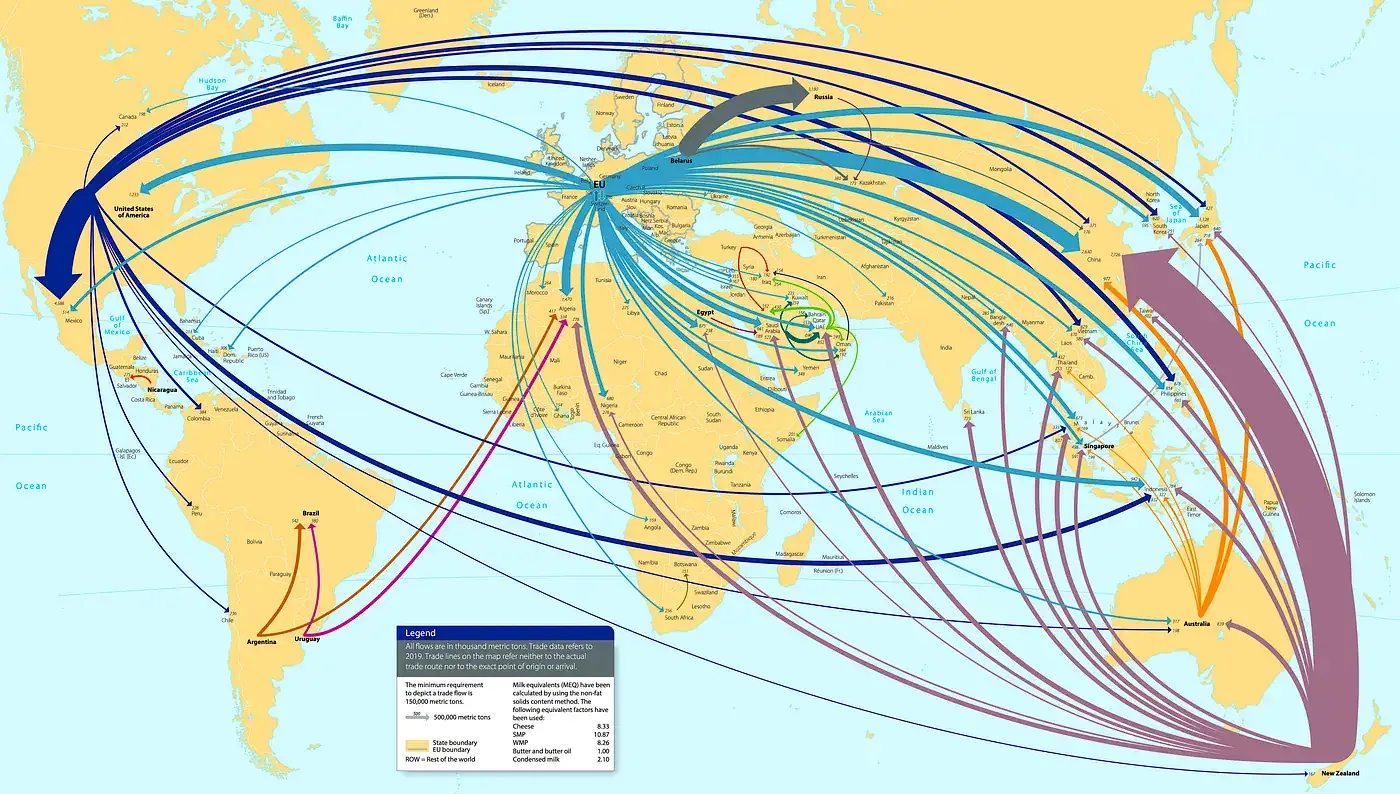
Door de jaren heen hebben veel landen sterke handelsroutes opgebouwd met deze grote producenten, dankzij handelsakkoorden en gunstige geopolitieke omstandigheden. Daardoor zijn handelscontacten met deze grote spelers over het algemeen constant in volume en timing. Dat is relatief ten opzichte van de botertransacties tussen andere landenparen; die transacties zijn doorgaans sporadischer. Ze worden vaak beïnvloed door kortetermijngebeurtenissen, waardoor hun karakter veel ‘willekeuriger’ en dus moeilijker te voorspellen is.
Vanuit het perspectief van de inkoper hangt de keuze bij welke grote producent je boter koopt van veel factoren af. Omdat boter een commodity is, zijn de verschillen klein, zo niet verwaarloosbaar. De belangrijkste doorslaggevende factor is daarom het verschil in de aanbiedingsprijzen van de grote spelers, gevolgd door tarieven en transportkosten.
Probleemrepresentatie: een enorm sociaal netwerk.
We gebruiken grafen om de dynamiek van de boterhandelsmarkt effectief weer te geven. Anders dan standaardtabellen, die datapunten los van elkaar opsommen, benadrukken grafen de verbanden ertussen en behouden ze de waardevolle nuances van een onderling verbonden netwerk. Daaronder vallen de typen en de sterkte van de relaties tussen datapunten.
Om grafen beter voor te stellen: denk aan je sociale netwerk van vrienden en collega’s. Elke node is een persoon en elke edge staat voor jouw relatie met die persoon. Met grafen kunnen we je hele sociale netwerk weergeven, waarbij de unieke eigenschappen van de mensen als node-kenmerken worden bewaard en de kenmerken van de relaties als edge-attributen.
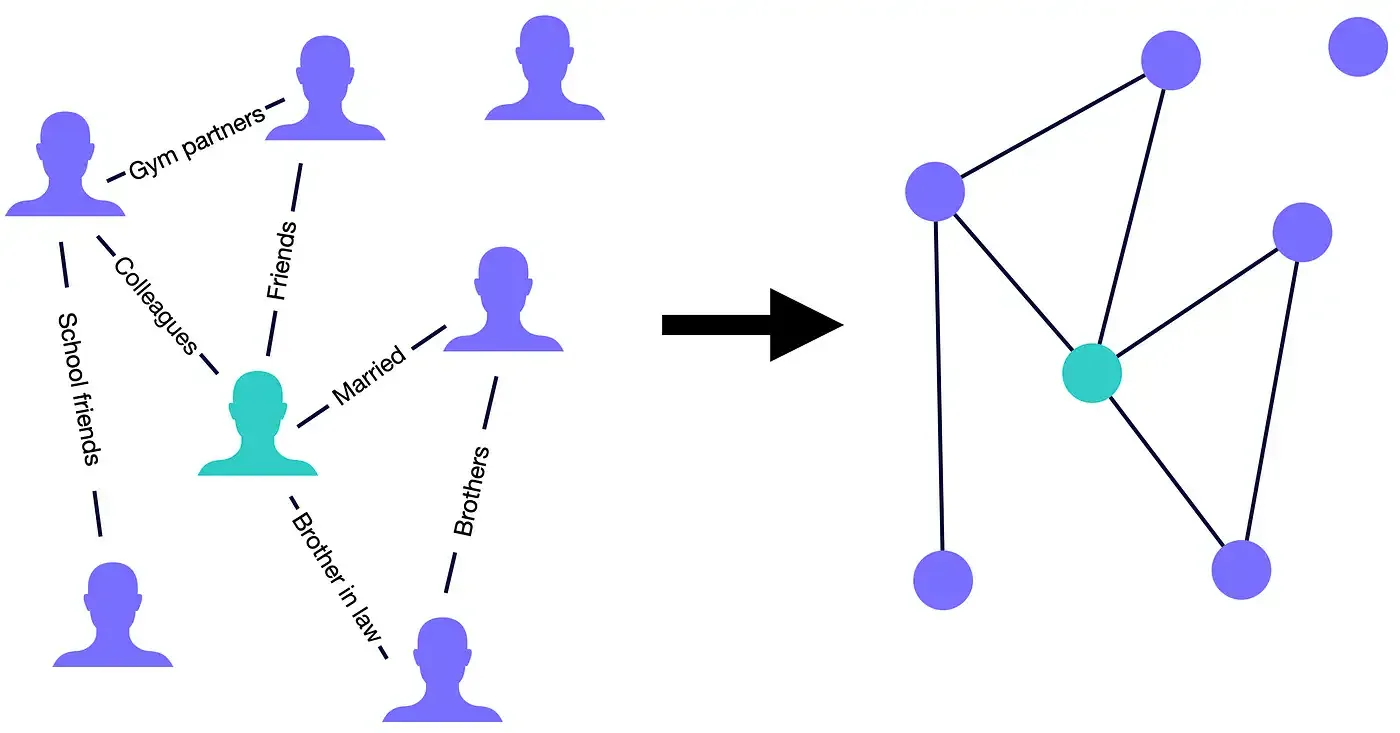
Zo gebruiken ook wij in ons scenario nodes om individuele landen te symboliseren en edges om handelsgebeurtenissen daartussen aan te duiden. Elk land heeft een set eigen kenmerken, de country-specific features (opgeslagen in de nodes), zoals de binnenlandse boterproductie of het bbp. Daarnaast zijn er kenmerken die exclusief bij het landenpaar horen, de pair-specific attributes (bewaard in de edges), zoals het handelsvolume of de geldende wisselkoers tussen de betreffende valuta’s.
Om de graaf te maken gebruiken we alle beschikbare import-exportdata vanaf januari 2015. Eerst voegen we de beschikbare 242 nodes toe, één voor elk “land”. Daarna selecteren we alle geregistreerde handelstransacties in dat tijdvenster. Het resultaat is een indrukwekkende 267.376 edges.
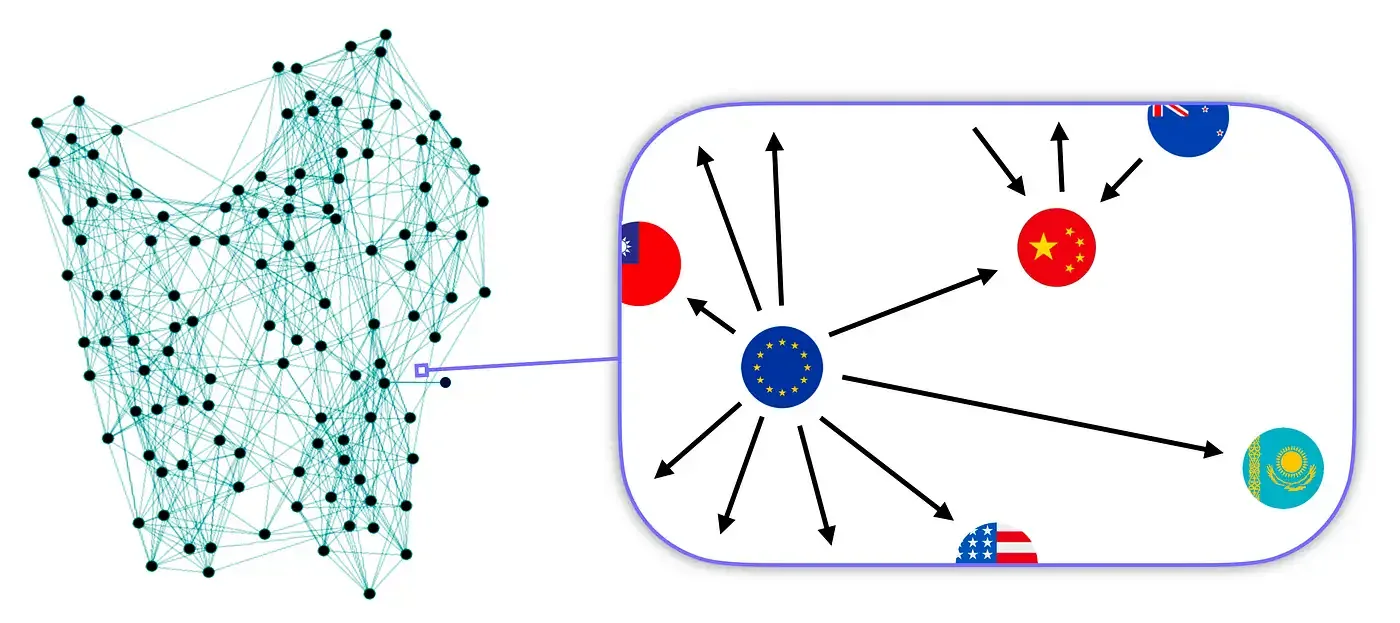
Om het probleem beter te bestuderen segmenteren we de data per maand. Dat levert een reeks lichtere grafen op met ongeveer 2.000 edges; elke graaf is een momentopname van de maandelijkse toestand van de markt. We kunnen deze historische reeks grafen zien als een algemene datareeks die de tijdreeksen van veel individuele punten bundelt. Een tijdreeks is een set metingen van één variabele door de tijd heen, bijvoorbeeld het handelsvolume tussen slechts één landenpaar.
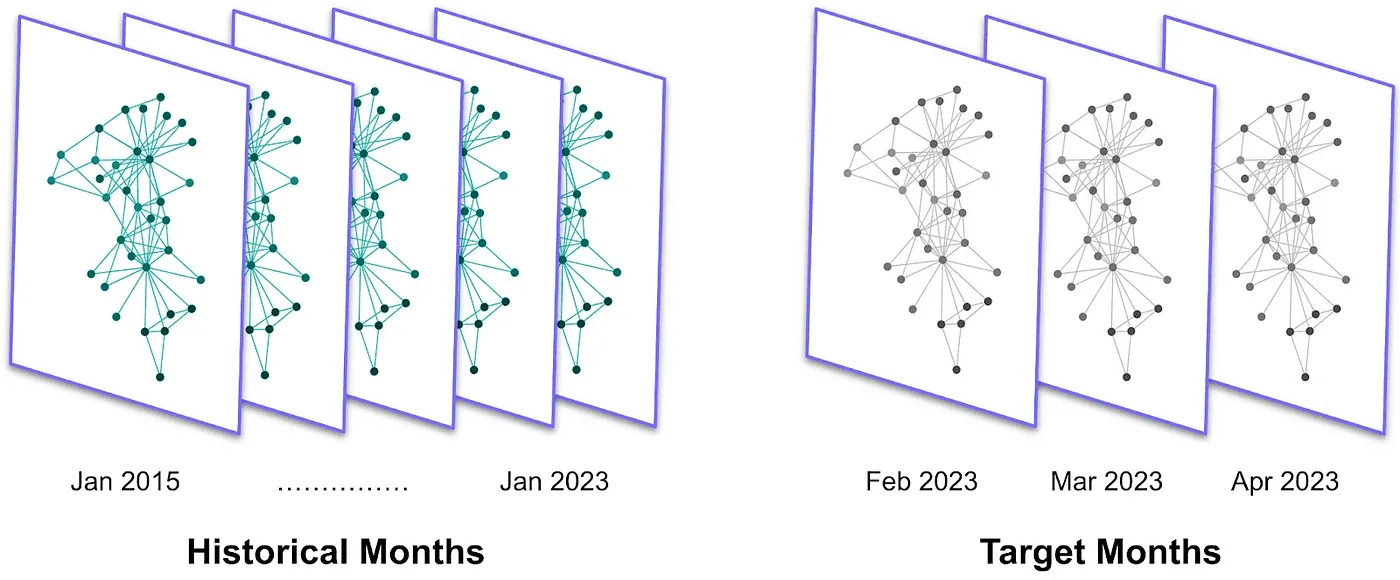
Het belangrijkste voordeel van onze graafgebaseerde representatie is dat die wereldwijde trends kan vangen. Door alle landenparen in één structuur te bundelen, kunnen we meerdere routes tegelijk bestuderen. Standaardprognosetechnieken kunnen daarentegen maar één datareeks tegelijk aan.
Bovendien kunnen we, omdat alle andere variabelen waarin we geïnteresseerd zijn (country-specific features en pair-specific attributes) niet met zo’n lange vertraging te maken hebben, de grafen voor de drie meest recente maanden die we willen voorspellen al maken: de target months. Met deze historische reeks grafen zijn we klaar om ons machine-learningmodel te ontwikkelen.
Handelsvolumes voorspellen met machine learning
Voor ons probleem implementeren we een aanpak die onder supervised learning valt. Eerst trainen we het model door het zowel de featuredata als de doelvariabele te geven.
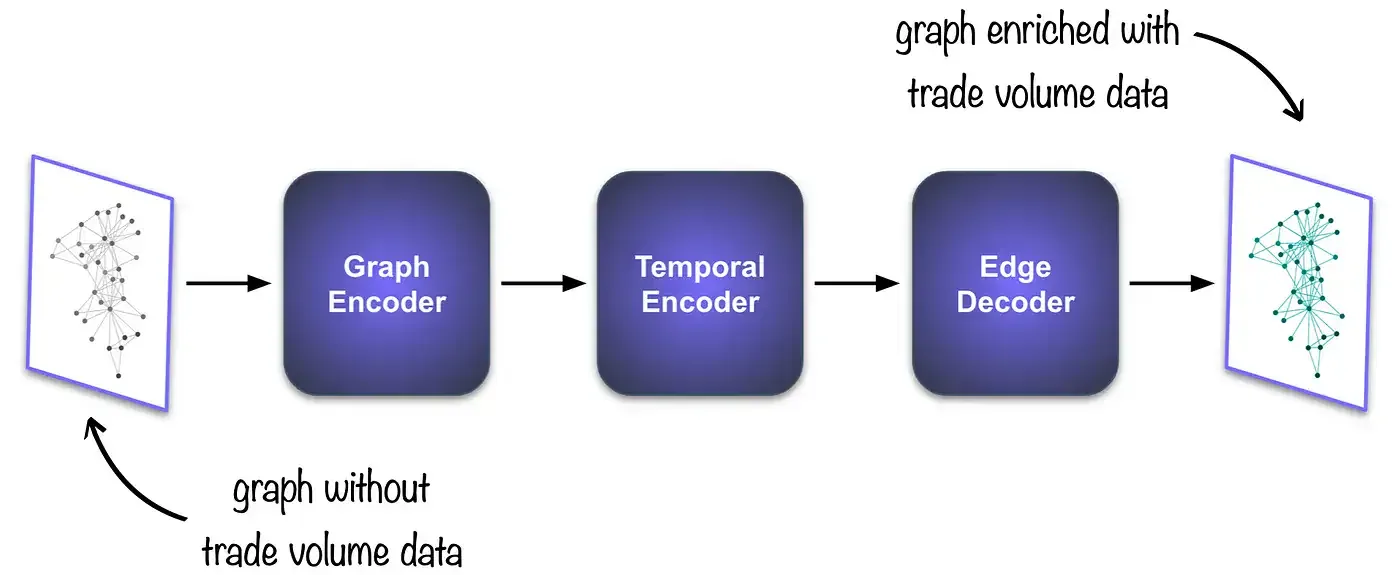
Nadat we ons model op historische maanden hebben getraind, voeren we een maandelijkse momentopname uit de target months in, met alle country-specific features en pair-specific attributes maar zonder handelsvolumedata. Het model verwerkt die en geeft vervolgens, op basis van de patronen die het tijdens de training heeft geleerd, de voorspelde handelsvolumes voor elk landenpaar als uitvoer.
Nu de overkoepelende aanpak duidelijk is, ontleden we ons model in de onderdelen. Daarna bespreken we de resultaten. De belangrijkste onderdelen van ons model zijn:
- Graph Encoder: om de individuele graaf samen te persen tot een machineleesbaar formaat dat embeddings heet.
- Temporal Encoder: om de temporele relaties uit eerdere maandelijkse embeddings te halen.
- Edge Decoder: om de embeddings te vertalen naar voorspellingen voor handelsvolumes.
Graph Encoder: terug naar de sociale netwerken.
Bij dit onderdeel gaat het ons om het efficiënt omzetten van alle data in de graaf naar een lijst getallen. Door het verschil in vorm is enig informatieverlies onvermijdelijk. Ons doel is dat verlies te minimaliseren.
We zetten een Graph Neural Network (GNN) in. GNN’s kunnen informatie combineren uit de individuele node, zijn buurt en de edge-attributen. Het lijkt op het gezegde dat een mens het best te typeren is aan de hand van zijn naaste vrienden. De uitvoer van de GNN heet node embeddings.
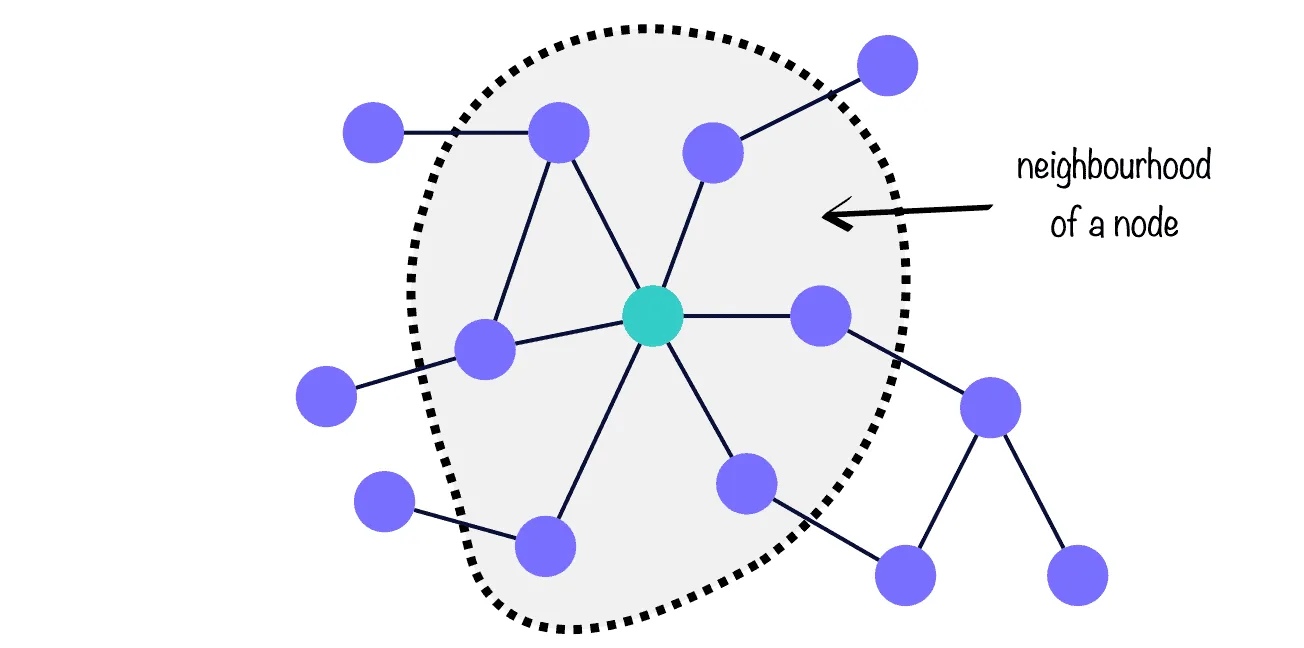
En net als in onze sociale netwerken, waar sommige vrienden meer invloed op ons hebben dan andere, geldt hetzelfde voor nodes in een graaf. In GNN-jargon heet dat attention, en we gebruiken het in ons model om te rangschikken welke handelsroutes het meest zeggen over andere handelsroutes.
Temporal Encoder: geïnspireerd door ChatGPT
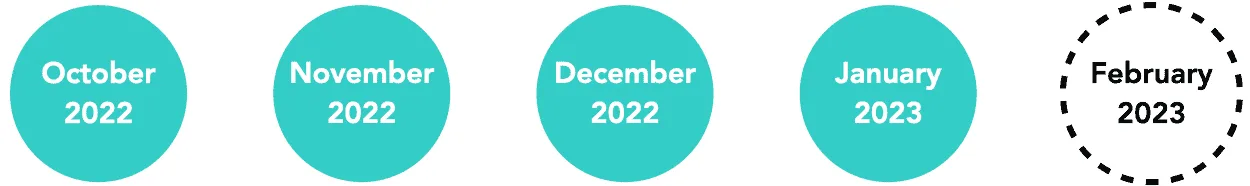
Deze eenheid leert hoe een specifieke maand zich verhoudt tot de voorgaande maanden. Het idee is dat de marktomstandigheden van een maand worden beïnvloed door de marktsituatie van de voorafgaande maanden. We zetten de Transformer in, een geavanceerde architectuur die aan de basis ligt van taalmodellen als ChatGPT, dankzij het vermogen om ‘sequence-to-sequence’-voorspellingen te doen.
Stel je een scenario met typvoorspelling voor. Gegeven een zin (een reeks woorden) begrijpt de Transformer de volgorde van de woorden en hun belang voor de boodschap, steeds in verhouding tot de algemene context van de zin. Vervolgens geeft hij het woord met de hoogste kans om als volgende in de reeks te komen.
Edge Decoder: node embeddings begrijpelijk maken.
Het doel van dit onderdeel kun je zien als het omgekeerde van de Graph Encoder. In plaats van embeddings te maken, ontcijfert het de embeddings die het van de Temporal Encoder krijgt tot voorspellingen voor de doelvariabele. We implementeren twee neurale netwerken met als doel om uit paren embeddings één getal te halen: de prognose voor het handelsvolume tussen twee landen.
Het resultaat is een eenheid die het handelsvolume voor elk landenpaar in de graaf kan reconstrueren voor de maand in kwestie. Hoe beter de Edge Decoder, hoe dichter de voorspellingen dus bij de werkelijke waarden liggen.
De resultaten
Om de prestaties van ons model te evalueren nemen we de drie meest recente maanden (waarvoor handelsvolumedata beschikbaar zijn) en voeren we die in het model in. Daarna vergelijken we de voorspellingen met de werkelijke waarden. Om de test geldig te houden hebben we deze drie maanden nooit aan het model laten zien.
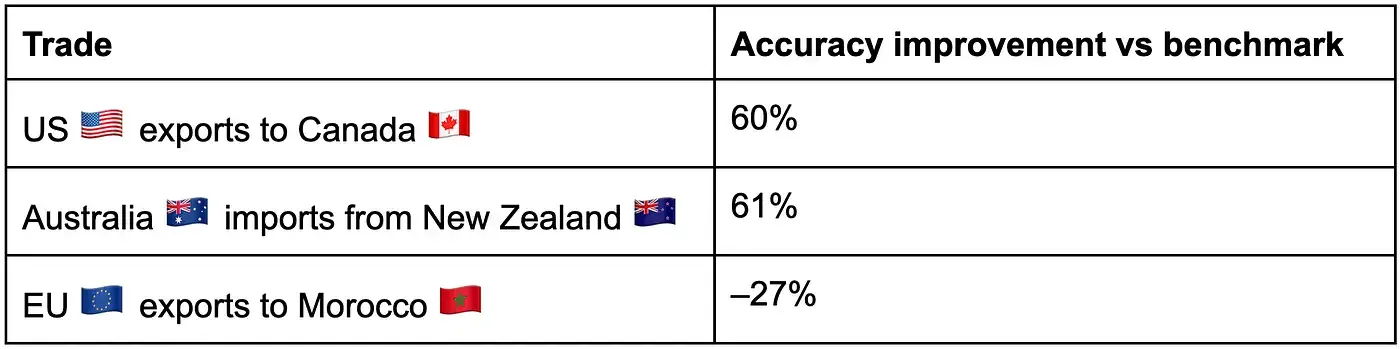
Het model is uitstekend in het voorspellen wanneer er geen handel plaatsvindt tussen twee landen. Het doet het ook goed bij het voorspellen wanneer handelsvolumes uitzonderlijk hoog zijn. Dat komt mogelijk door de enorme omvang van die handelsvolumes, die sterk afwijken van de gemiddelde waarde in de data en daardoor makkelijk herkenbaar zijn voor het model.
Opvallend genoeg heeft het moeite met gemiddelde handelsvolumes. Als we onze voorspellingen afzetten tegen traditionele methoden voor tijdreeksprognoses, wordt duidelijk dat we, om de nauwkeurigheid van ons model te verbeteren, het onderscheid moeten vergemakkelijken tussen gemiddelde handelsroutes die meer op elkaar lijken. Dat kan door meer datafeatures op te nemen die helpen een rijkere marktrepresentatie te maken, en door handelsinformatie uit andere grondstoffen mee te nemen.
Gezien deze overwegingen is de gemiddelde verbetering van ons model over alle handelsroutes verwaarloosbaar, en is het leerzamer om individuele paren te bestuderen. Hieronder vind je de prestaties van ons model op twee routes met zeer hoge verhandelde volumes en één gemiddelde route. Zoals je ziet verschillen de resultaten sterk.