Le reinforcement learning, un domaine du machine learning, est sans doute surtout connu en lien avec les véhicules autonomes : une voiture apprend à conduire par essais et erreurs et, au bout d’un million de fois, elle sait prendre un virage et s’arrêter à un feu rouge. Je sais que c’est très simplifié, mais vous voyez l’idée.
Une application moins connue du reinforcement learning se trouve dans le monde du trading. La plupart d’entre nous connaissent l’application de modèles de machine learning à des données de séries temporelles. Chez Vesper, nous le faisons pour prévoir les prix, la production et les niveaux de stocks de différentes matières premières agricoles pour quelques mois à venir. Si ces modèles peuvent indiquer où va le marché, ils ne peuvent pas vous dire quelle action engager à partir de leur résultat : les agents de reinforcement learning, eux, peuvent vous dire quand vendre, acheter ou conserver vos actifs selon la façon dont le marché se comporte. Si ce type d’applications gagne en popularité sur les marchés boursiers et des changes, aucun cas appliqué aux marchés de matières premières n’a encore été trouvé.
Avec Slimmer.AI, nous (l’équipe Data Science de Vesper) avons passé trois mois à étudier et à développer un agent RL qui apprend à négocier sur le marché des matières premières. Pour en savoir plus sur ces cycles de R&D, c’est ici !
Cet article donne un aperçu de nos conclusions les plus importantes. Nous commencerons par expliquer brièvement le concept de reinforcement learning, puis viendront la définition d’un agent de trading et les avantages à en utiliser un. Enfin, nous aborderons trois méthodes de reinforcement learning différentes ainsi que leurs avantages et inconvénients respectifs.
Un article plus approfondi sur les spécifications de nos agents et leurs résultats, ainsi qu’une introduction à la bibliothèque utilisée, se trouve ici. Le dépôt git correspondant se trouve ici. Mais si le concept vous est relativement nouveau, lisez la suite !
Qu’est-ce que le reinforcement learning ?
Pour le dire simplement, le reinforcement learning est la pratique de l’apprentissage par essais et erreurs. Le modèle apprend en étant récompensé pour les bonnes décisions et pénalisé pour les mauvaises décisions. Cela passe par l’ajustement de la taille d’une récompense, appelée signal de renforcement, qui est soit positive soit négative et toujours la conséquence d’une action prise par l’agent.
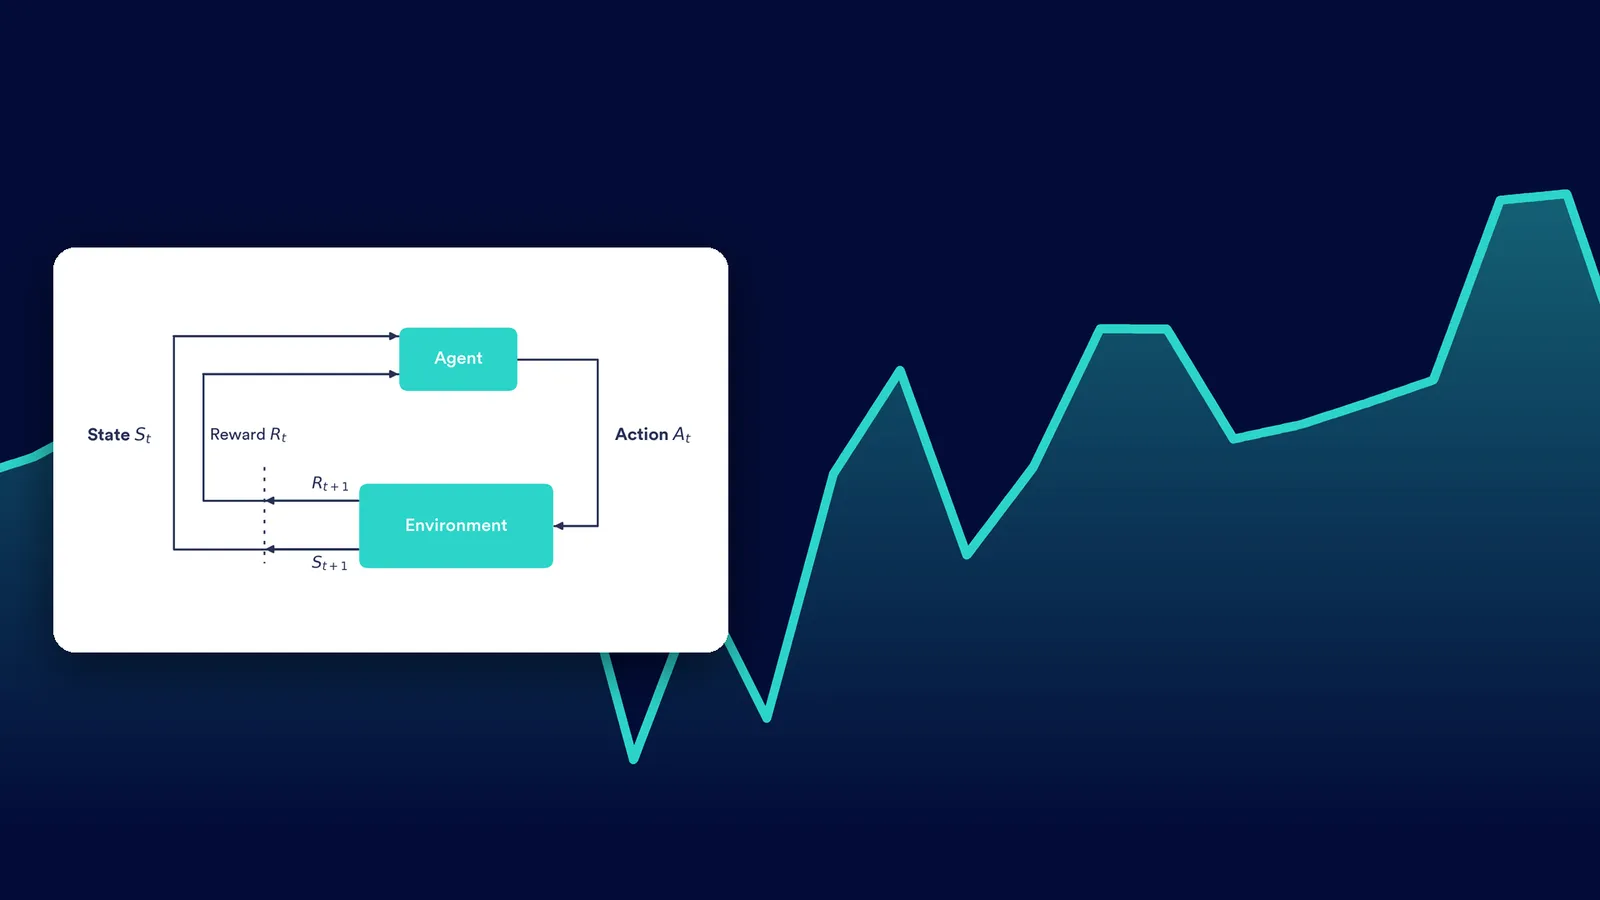
Un modèle de reinforcement learning relie un agent à un environnement par une action. Une visualisation en est présentée dans la figure ci-dessous. L’agent reçoit des informations sur l’état actuel (St,) de l’environnement. Sur la base de ces informations, l’agent décide d’une action (At), ce qui fait passer l’état de l’environnement à St+1. L’action est choisie dans l’espace d’actions.
Espace d’actions : L’ensemble de toutes les actions dont dispose l’agent et qu’il peut utiliser pour interagir avec son environnement et le modifier
La récompense ou la punition liée à la transition d’état est communiquée à l’agent par le signal de récompense (Rt). Le système vise à apprendre une stratégie d’action qui trouve la valeur de récompense cumulée la plus élevée de l’environnement.
Un exemple simplifié de tâche de reinforcement learning dans la vie réelle est celui d’un enfant qui apprend à marcher : l’enfant est l’agent qui tente de se déplacer dans l’environnement en effectuant des actions sous forme de marche ou de quatre pattes. Lorsque quelques pas sont faits, l’enfant reçoit une réaction favorable de ses parents, ce qui est analogue à la récompense. À l’inverse, l’enfant ne reçoit aucune réaction lorsqu’il marche à quatre pattes ou ne bouge pas, ce qui représente une récompense négative ou une punition.

Que sont les agents de trading ?
Dans le contexte du trading, un agent de reinforcement learning est un trader dont l’espace d’actions consiste à acheter, vendre ou conserver un actif. Le marché dont l’actif fait partie joue le rôle d’environnement. L’état peut être présenté sous forme de statistiques sur le marché actuel, comme les moyennes mobiles quotidiennes, les plus hauts et plus bas quotidiens ou les volumes échangés d’un actif. La récompense dans le trading peut s’exprimer en termes de profits, de pertes ou d’autres indicateurs de performance. En fin de compte, l’objectif de l’agent de trading est d’agir de manière à maximiser la récompense future, compte tenu du marché sur lequel il opère. Un bon agent devrait être capable de battre le marché en achetant à des niveaux de prix bas et en vendant à des niveaux de prix plus élevés. Le comportement de l’agent dépendra largement de la méthode RL choisie. Trois méthodes couramment utilisées sont abordées dans la dernière section, mais nous passerons d’abord rapidement en revue les avantages des agents de trading.
Pourquoi utiliser des agents de trading ?
Le trading automatisé, aussi appelé trading algorithmique, suppose l’utilisation d’algorithmes pour l’exécution des ordres, domaine dont relèvent les agents de trading. Cette forme de trading présente de nombreux avantages par rapport au trading humain (manuel). Il faut d’abord distinguer deux types de trading automatisé :
1. Le trading automatisé fondé sur des règles, où la stratégie est prédéfinie et conçue par un humain. 2. Le trading automatisé fondé sur le reinforcement learning, où la stratégie est apprise à l’aide du reinforcement learning.
Les deux méthodes profitent des avantages généraux du trading automatisé. Les avantages sont nombreux, mais les plus importants sont les suivants :
- Les ordinateurs ont des temps d’exécution rapides, ce qui réduit le risque de manquer une opportunité à cause d’une réaction trop lente à l’état du marché. - Avec le trading automatisé, vous n’êtes pas exposé au risque de prendre de mauvaises décisions de trading sous l’effet de facteurs émotionnels et psychologiques, ce dont les humains souffrent massivement. Les ordinateurs exécutent toujours la stratégie pour laquelle ils ont été conçus. - Le trading automatisé profite du fait que les ordinateurs sont nettement plus capables que le cerveau humain d’assimiler des masses de données en temps réel, ce qui permet des stratégies bien plus complexes.
Si l’on regarde les avantages propres aux agents de trading utilisant le reinforcement learning, on peut ajouter l’avantage clé suivant :
- Un agent de trading n’arrête jamais d’apprendre et d’adapter sa stratégie. Une stratégie autrefois rentable peut ne plus fonctionner lorsque la dynamique du marché change. Un agent de trading par reinforcement learning bien conçu devrait pouvoir ajuster sa stratégie en conséquence.
Quelle méthode choisir pour les agents de trading par reinforcement learning ?
Comme indiqué plus haut, il existe différentes méthodes pour construire un agent de reinforcement learning. Trois approches peuvent être utilisées pour le trading financier : critic-only, actor-only et actor-critic. Critic-only, la méthode la plus utilisée dans le domaine du trading automatisé, fonctionne en résolvant un espace d’actions discret sous la forme d’une fonction de valeur Q.
Fonction de valeur Q : mesure de la récompense totale attendue, en supposant que l’agent se trouve dans l’état St et exécute l’action At
Ce faisant, elle apprend la stratégie qui maximise la récompense future compte tenu de l’état actuel. Les exemples les plus connus sont le Q-learning et le Deep Q-learning. Le principal inconvénient de ces méthodes est qu’elles sont conçues pour ne traiter que des problèmes à espace d’actions discret et fini, ce qui signifie que les actions qu’un agent peut prendre doivent être prédéfinies. Des techniques particulières doivent donc être employées pour le convertir en un espace continu, comme dans le cas de l’achat ou de la vente de quantités différentes d’un produit.
La deuxième approche s’appelle actor-only ; ici, le plus grand avantage est que l’espace d’actions peut être continu, puisqu’une politique est apprise directement sous la forme d’une distribution de probabilité fournissant une stratégie pour tout état donné.
Politique : correspondance entre un état St et les probabilités de sélectionner chaque action possible At dans cet état
Cependant, le temps d’entraînement plus long nécessaire pour obtenir les politiques optimales peut être vu comme un inconvénient de cette approche.
Le troisième type, le cadre actor-critic, combine les deux et entraîne simultanément deux modèles : l’acteur, qui apprend à faire se comporter l’agent dans un état donné, et le critique, qui évalue l’efficacité réelle de l’action sélectionnée. Deux algorithmes actor-critic couramment utilisés sont PPO ou A2C. Si les deux méthodes sont très populaires pour le trading d’actions, il existe entre le marché des actions et celui des matières premières des différences à prendre en compte au moment de décider de notre approche.
La plus grande différence entre les deux marchés est la quantité de données disponibles. Une difficulté que les chercheurs rencontrent souvent lorsqu’ils appliquent des technologies d’IA au marché des matières premières est son manque de transparence et la conséquence qui en découle : peu de données de marché disponibles. Heureusement, en tant que plateforme de veille sur les matières premières, collecter ces données est notre quotidien. La base de données de Vesper contient des milliers de séries de données couvrant, entre autres, les prix, les contrats à terme et les données d’offre et de demande de différentes matières premières agricoles. Une autre différence à prendre en compte est la nature des biens négociés. Les matières premières agricoles étant physiques par définition, des contraintes supplémentaires doivent être prises en compte. Pensez aux dates de péremption qui obligent les traders à vendre un produit avant une certaine date.
Dans cet article, nous avons abordé les bases du reinforcement learning, ce que sont les agents de trading et pourquoi il est pertinent de les appliquer au marché des matières premières. Nous avons également abordé les avantages qu’ils apportent et quelles sont les méthodes de reinforcement learning les plus adaptées à notre cas d’usage. Si l’implémentation concrète de cette méthode vous intéresse, jetez un œil ici, où nous montrons que les agents de trading surpassent nettement un modèle de référence.
Si le marché des matières premières et la façon dont nous utilisons l’IA pour le révolutionner vous intéressent, abonnez-vous à notre publication !