Reinforcement Learning, ein Teilgebiet des Machine Learning, ist den meisten wohl im Zusammenhang mit autonomen Fahrzeugen bekannt: Ein Auto lernt durch Versuch und Irrtum zu fahren und weiß nach einer Million Versuchen, wie es abbiegt und an einer roten Ampel hält. Mir ist klar, dass das stark vereinfacht ist, aber Sie verstehen, worauf es hinausläuft.
Eine weniger bekannte Anwendung von Reinforcement Learning findet sich in der Handelswelt. Die meisten von uns kennen die Anwendung von Machine-Learning-Modellen auf Zeitreihendaten. Bei Vesper tun wir das, um Preise, Produktion und Lagerbestände verschiedener Agrarrohstoffe einige Monate im Voraus zu prognostizieren. Diese Modelle können zwar anzeigen, wohin sich der Markt bewegt, sie können Ihnen aber nicht sagen, welche Maßnahme Sie auf Basis ihres Ergebnisses ergreifen sollten: Reinforcement-Learning-Agenten können Ihnen sagen, wann Sie Ihre Assets verkaufen, kaufen oder halten sollten, je nachdem, wie sich der Markt verhält. Während Anwendungen dieser Art an den Aktien- und Devisenmärkten immer beliebter werden, lassen sich bislang keine Fälle finden, die auf Rohstoffmärkte angewendet wurden.
Gemeinsam mit Slimmer.AI haben wir (das Data-Science-Team von Vesper) drei Monate damit verbracht, einen RL-Agenten zu erforschen und zu entwickeln, der lernt, auf dem Rohstoffmarkt zu handeln. Mehr über diese F&E-Zyklen lesen Sie hier!
Dieser Artikel gibt einen Überblick über unsere wichtigsten Erkenntnisse. Wir beginnen mit einer kurzen Erläuterung des Konzepts Reinforcement Learning, gefolgt von der Definition eines Handelsagenten und den Vorteilen seines Einsatzes. Abschließend besprechen wir drei verschiedene Reinforcement-Learning-Methoden und ihre jeweiligen Vor- und Nachteile.
Einen ausführlicheren Artikel zu den Spezifikationen unserer Agenten und ihren Ergebnissen sowie eine Einführung in die verwendete Bibliothek finden Sie hier. Das zugehörige Git-Repository finden Sie hier. Wenn Sie mit dem Konzept aber noch relativ wenig vertraut sind, lesen Sie einfach weiter!
Was ist Reinforcement Learning?
Einfach gesagt ist Reinforcement Learning das Lernen durch Versuch und Irrtum. Das Modell lernt, indem es für gute Entscheidungen belohnt und für schlechte Entscheidungen bestraft wird. Das geschieht über die Anpassung der Höhe einer Belohnung, des sogenannten Verstärkungssignals, das entweder positiv oder negativ ausfällt und immer die Folge einer vom Agenten ausgeführten Aktion ist.
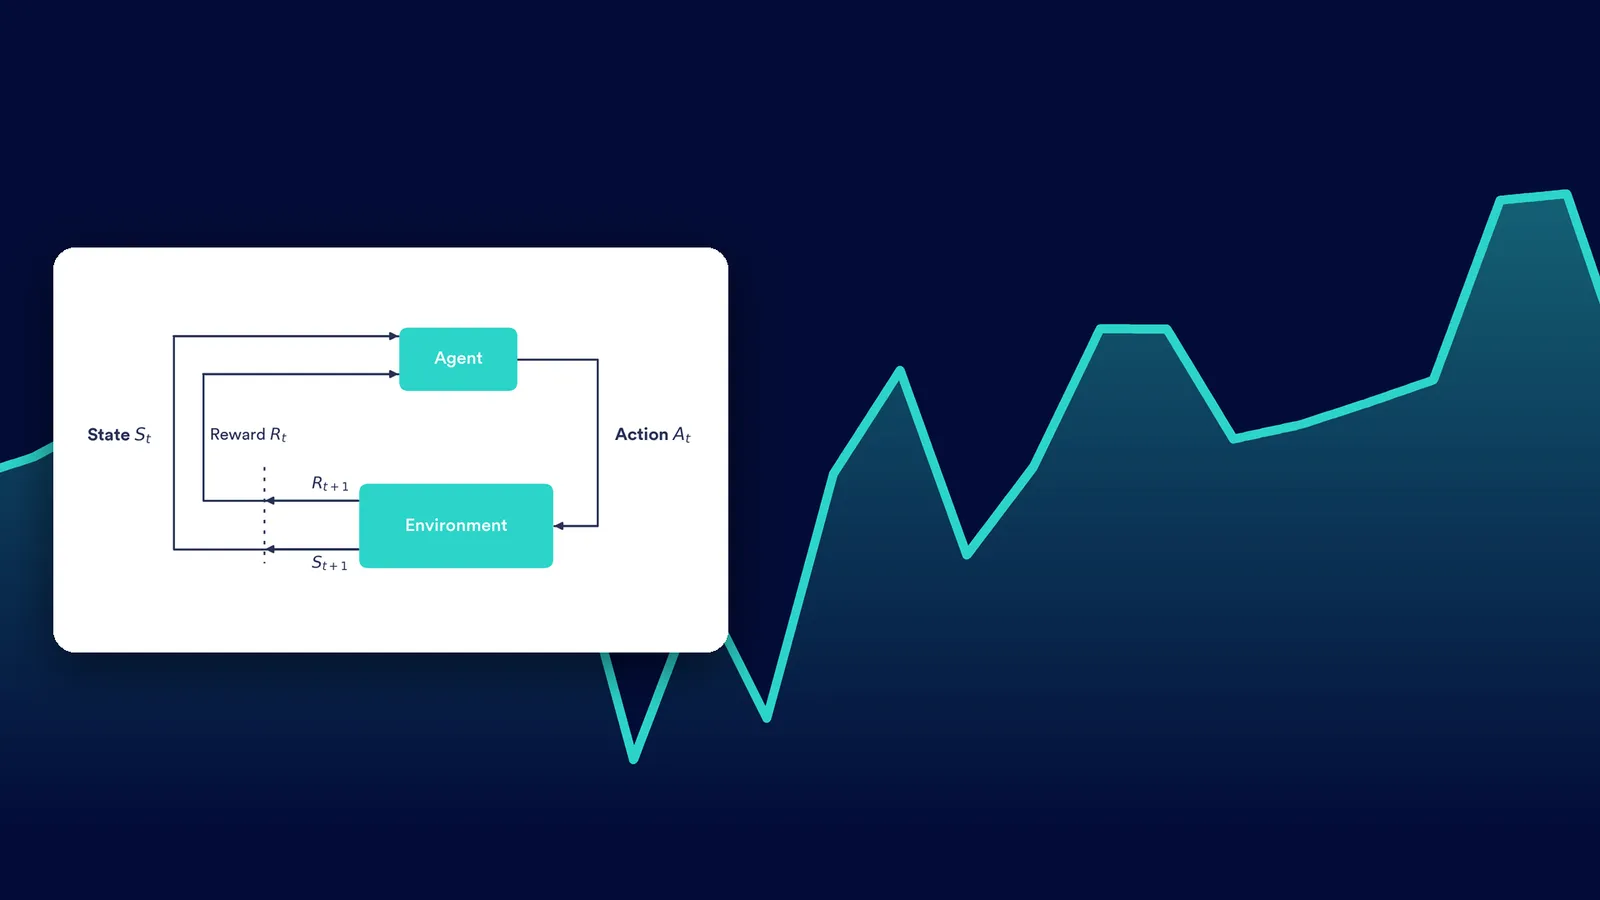
Ein Reinforcement-Learning-Modell verbindet einen Agenten über eine Aktion mit einer Umgebung. Eine Visualisierung davon zeigt die Abbildung unten. Der Agent erhält Informationen über den aktuellen Zustand (St,) der Umgebung. Auf Basis dieser Informationen entscheidet sich der Agent für eine Aktion (At) und verändert damit den Zustand der Umgebung zu St+1. Die Aktion wird aus dem Aktionsraum gewählt.
Aktionsraum: Die Gesamtheit aller Aktionen, die dem Agenten zur Verfügung stehen und mit denen er mit seiner Umgebung interagieren und sie verändern kann
Die Belohnung oder Bestrafung des Zustandsübergangs wird dem Agenten über das Belohnungssignal (Rt) mitgeteilt. Das System hat zum Ziel, eine Handlungsstrategie zu lernen, die den höchsten kumulativen Belohnungswert der Umgebung findet.
Ein vereinfachtes Beispiel für eine Reinforcement-Learning-Aufgabe aus dem echten Leben ist ein Kind, das laufen lernt: Das Kind ist der Agent, der versucht, sich in der Umgebung zurechtzufinden, indem er Aktionen in Form von Laufen oder Krabbeln ausführt. Wenn einige Schritte gelungen sind, erhält das Kind eine positive Reaktion der Eltern, die der Belohnung entspricht. Krabbelt das Kind dagegen oder bewegt es sich nicht, erhält es keinerlei Reaktion, was eine negative Belohnung oder Bestrafung darstellt.

Was sind Handelsagenten?
Im Kontext des Handels ist ein Reinforcement-Learning-Agent ein Händler, dessen Aktionsraum aus dem Kaufen, Verkaufen oder Halten eines Assets besteht. Der Markt, zu dem das Asset gehört, fungiert als Umgebung. Der Zustand lässt sich in Form von Statistiken über den aktuellen Markt darstellen, etwa gleitende Tagesdurchschnitte, Tageshöchst- und -tiefstwerte oder Handelsvolumina von Assets. Die Belohnung im Handel lässt sich über Gewinne, Verluste oder andere Performancekennzahlen ausdrücken. Letztlich besteht das Ziel des Handelsagenten darin, so zu agieren, dass er die künftige Belohnung angesichts des Marktes, in dem er tätig ist, maximiert. Ein guter Agent sollte den Markt schlagen können, indem er auf niedrigen Preisniveaus kauft und auf höheren Preisniveaus verkauft. Das Verhalten des Agenten hängt maßgeblich von der gewählten RL-Methode ab. Drei gängige Methoden besprechen wir im letzten Abschnitt, doch zunächst gehen wir kurz die Vorteile von Handelsagenten durch.
Warum Handelsagenten einsetzen?
Der automatisierte Handel, auch algorithmischer Handel genannt, umfasst den Einsatz von Algorithmen zur Ausführung von Handelsaufträgen, und in diesen Bereich fallen Handelsagenten. Diese Form des Handels hat viele Vorteile gegenüber dem menschlichen (manuellen) Handel. Zunächst sollte zwischen zwei Arten des automatisierten Handels unterschieden werden:
1. Regelbasierter automatisierter Handel, bei dem die Strategie vorgegeben und von einem Menschen entworfen wird. 2. Auf Reinforcement Learning basierender automatisierter Handel, bei dem die Strategie mithilfe von Reinforcement Learning erlernt wird.
Beide Methoden profitieren von den allgemeinen Vorzügen des automatisierten Handels. Es gibt viele Vorteile, die wichtigsten sind die folgenden:
- Computer haben kurze Ausführungszeiten, was das Risiko verringert, eine Gelegenheit wegen einer langsamen Reaktion auf den Zustand des Marktes zu verpassen. - Beim automatisierten Handel sind Sie nicht dem Risiko ausgesetzt, aufgrund emotionaler und psychologischer Einflüsse schlechte Handelsentscheidungen zu treffen, worunter Menschen massiv leiden. Computer führen immer die Strategie aus, für deren Ausführung sie entworfen wurden. - Der automatisierte Handel profitiert davon, dass Computer deutlich besser als menschliche Gehirne darin sind, riesige Datenmengen in Echtzeit zu verarbeiten, was sehr viel komplexere Strategien ermöglicht.
Betrachten wir die Vorteile speziell für Handelsagenten, die Reinforcement Learning nutzen, kommt der folgende zentrale Vorteil hinzu:
- Ein Handelsagent hört nie auf zu lernen und seine Strategie anzupassen. Eine einst profitable Strategie funktioniert möglicherweise nicht mehr, wenn sich die Marktdynamik ändert. Ein gut konzipierter Reinforcement-Learning-Handelsagent sollte seine Strategie entsprechend anpassen können.
Welche Methode für Reinforcement-Learning-Handelsagenten wählen?
Wie bereits erwähnt, gibt es verschiedene Methoden, um einen Reinforcement-Learning-Agenten zu bauen. Für den Finanzhandel kommen drei Ansätze infrage: critic-only, actor-only und actor-critic. Critic-only, die im Bereich des automatisierten Handels am häufigsten genutzte Methode, funktioniert, indem ein diskreter Aktionsraum in Form einer Q-Wert-Funktion gelöst wird.
Q-Wert-Funktion: Maß für die insgesamt erwartete Belohnung, unter der Annahme, dass sich der Agent im Zustand St befindet und die Aktion At ausführt
Auf diese Weise lernt sie die Strategie, die die künftige Belohnung bei gegebenem aktuellem Zustand maximiert. Die bekanntesten Beispiele sind Q-Learning und Deep Q-Learning. Der wesentliche Nachteil dieser Methoden ist, dass sie nur für Probleme mit diskretem und endlichem Aktionsraum ausgelegt sind, was bedeutet, dass die Aktionen, die ein Agent ergreifen kann, vorgegeben sein müssen. Daher müssen besondere Techniken eingesetzt werden, um ihn in einen kontinuierlichen Raum zu überführen, etwa beim Kauf oder Verkauf unterschiedlicher Mengen eines Produkts.
Der zweite Ansatz heißt actor-only; hier besteht der größte Vorteil darin, dass der Aktionsraum kontinuierlich sein darf, da eine Policy direkt in Form einer Wahrscheinlichkeitsverteilung gelernt wird, die für jeden beliebigen Zustand eine Strategie liefert.
Policy: Abbildung von einem Zustand St auf die Wahrscheinlichkeiten, mit denen jede mögliche Aktion At in diesem Zustand gewählt wird
Die längere Trainingszeit, die zum Erreichen der optimalen Policies nötig ist, lässt sich allerdings als Nachteil dieses Ansatzes betrachten.
Der dritte Typ, das Actor-Critic-Framework, kombiniert beide und trainiert gleichzeitig zwei Modelle: den Actor, der lernt, wie der Agent sich in einem bestimmten Zustand verhalten soll, und den Critic, der bewertet, wie wirksam die gewählte Aktion tatsächlich war. Zwei gängige Actor-Critic-Algorithmen sind PPO oder A2C. Beide Methoden sind im Aktienhandel zwar sehr beliebt, doch zwischen Aktien- und Rohstoffmarkt gibt es einige Unterschiede, die bei der Entscheidung über unseren Ansatz zu berücksichtigen sind.
Der größte Unterschied zwischen den beiden Märkten ist die Menge der verfügbaren Daten. Eine Schwierigkeit, auf die Forschende beim Einsatz von KI-Technologien am Rohstoffmarkt häufig stoßen, ist dessen mangelnde Transparenz und die damit verbundene Folge, dass nur wenige Marktdaten verfügbar sind. Zum Glück gehört das Sammeln dieser Daten als Commodity-Intelligence-Plattform zu unserem Tagesgeschäft. Vespers Datenbank enthält Tausende von Datenreihen, die unter anderem Preise, Futures sowie Angebots- und Nachfragedaten verschiedener Agrarrohstoffe abdecken. Ein weiterer Unterschied, den es zu berücksichtigen gilt, ist die Art der gehandelten Güter. Da Agrarrohstoffe per Definition physisch sind, müssen zusätzliche Einschränkungen berücksichtigt werden. Denken Sie an Verfallsdaten, die Händler zwingen, ein Produkt vor einem bestimmten Datum zu verkaufen.
In diesem Artikel haben wir die Grundlagen des Reinforcement Learning besprochen, was Handelsagenten sind und warum ihr Einsatz am Rohstoffmarkt relevant ist. Wir haben außerdem die Vorteile erörtert, die sie mit sich bringen, und welche Reinforcement-Learning-Methoden für unseren Anwendungsfall am besten geeignet sind. Wenn Sie sich für die tatsächliche Umsetzung dieser Methode interessieren, schauen Sie bitte hier, wo wir zeigen, dass Handelsagenten ein Benchmark-Modell deutlich übertreffen.
Wenn Sie sich für den Rohstoffmarkt interessieren und dafür, wie wir ihn mit KI umkrempeln, abonnieren Sie bitte unsere Publikation!