El aprendizaje por refuerzo, un área del aprendizaje automático, quizá sea más conocido por su relación con los vehículos autónomos: un automóvil aprende a conducir por ensayo y error y, tras un millón de veces, sabe cómo tomar una curva y detenerse ante un semáforo en rojo. Sé que esto está muy simplificado, pero se entiende la idea.
Una aplicación menos conocida del aprendizaje por refuerzo se encuentra en el mundo del trading. La mayoría de nosotros estamos familiarizados con la aplicación de modelos de aprendizaje automático a datos de series temporales. En Vesper lo hacemos para predecir los precios, la producción y los niveles de existencias de distintas materias primas agrícolas con algunos meses de antelación. Aunque estos modelos pueden indicar hacia dónde va el mercado, no pueden decirle qué medida tomar a partir de su resultado: los agentes de aprendizaje por refuerzo sí pueden decirle cuándo vender, comprar o mantener sus activos en función de cómo se esté comportando el mercado. Aunque aplicaciones como esta son cada vez más populares en los mercados de acciones y de divisas, todavía no se encuentran casos aplicados a los mercados de materias primas.
Junto con Slimmer.AI, nosotros (el equipo de ciencia de datos de Vesper) dedicamos tres meses a investigar y desarrollar un agente de RL que aprende a operar en el mercado de materias primas. Lea más sobre estos ciclos de I+D ¡aquí!
Este artículo ofrece una visión general de nuestros hallazgos más importantes. Empezaremos explicando brevemente el concepto de aprendizaje por refuerzo, seguido de la definición de agente de trading y de las ventajas de usar uno. Por último, analizaremos tres métodos distintos de aprendizaje por refuerzo y sus correspondientes pros y contras.
Puede encontrar un artículo más detallado sobre las especificaciones de nuestros agentes y sus logros, así como una introducción a la biblioteca utilizada, aquí. El repositorio git correspondiente se encuentra aquí. Pero si el concepto le resulta relativamente nuevo, ¡siga leyendo!
¿Qué es el aprendizaje por refuerzo?
Dicho de forma sencilla, el aprendizaje por refuerzo es la práctica de aprender por ensayo y error. El modelo aprende al ser recompensado por las buenas decisiones y penalizado por las malas decisiones. Esto se consigue ajustando el tamaño de una recompensa, llamada señal de refuerzo, que es positiva o negativa y siempre consecuencia de una acción tomada por el agente.
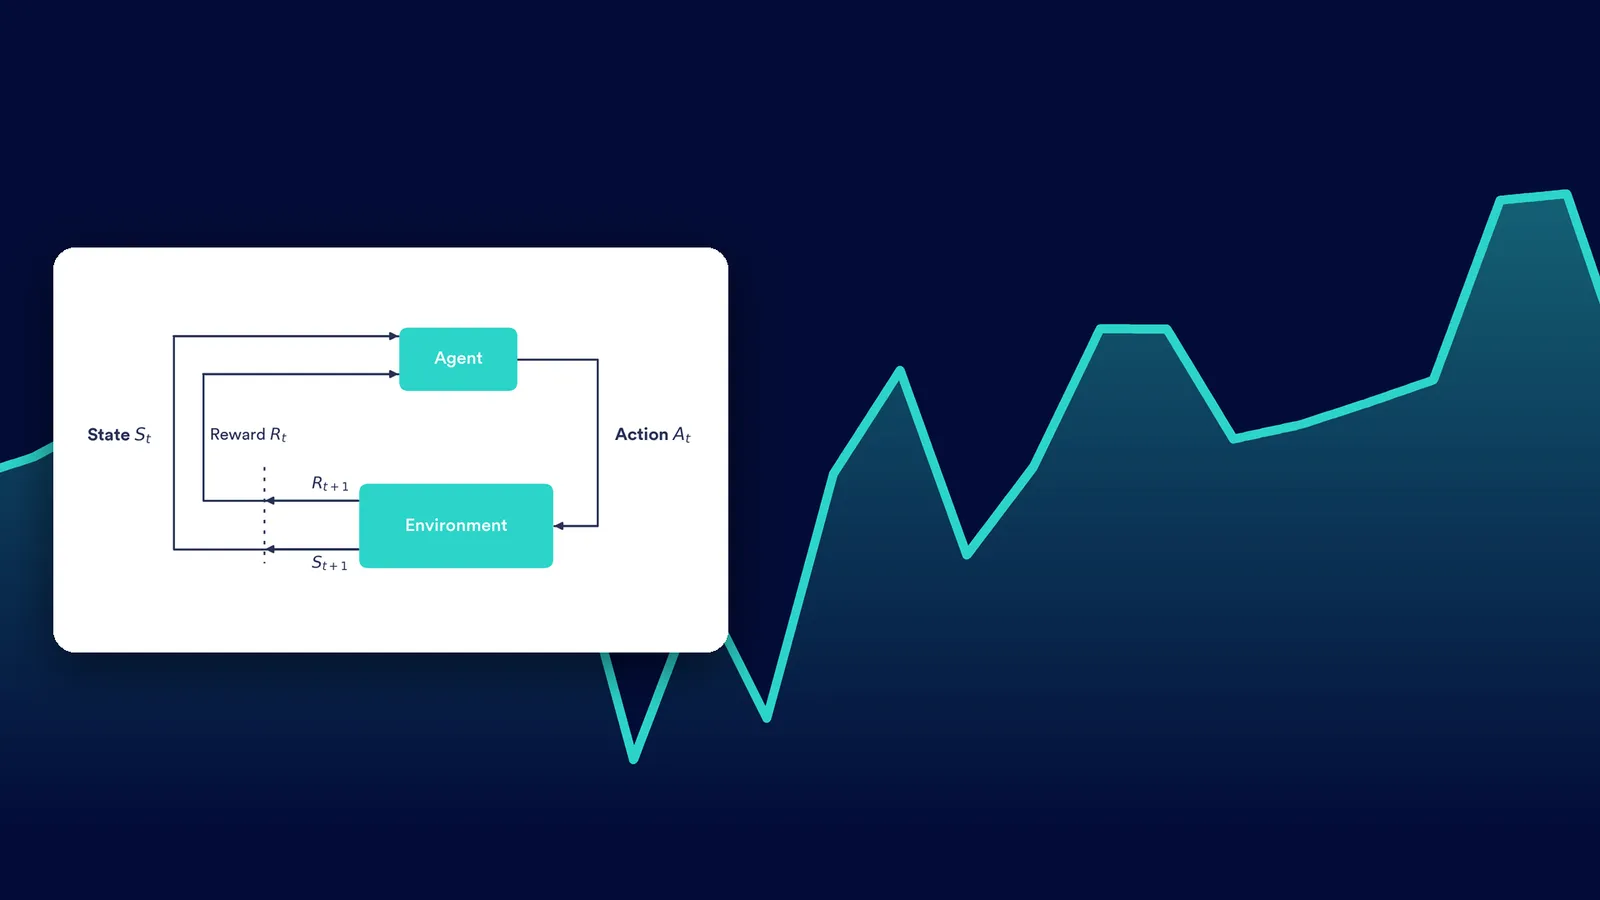
Un modelo de aprendizaje por refuerzo conecta un agente con un entorno a través de una acción. En la figura siguiente se muestra una visualización de esto. Al agente se le da información sobre el estado actual (St,) del entorno. A partir de esta información, el agente decide una acción (At), que cambia el estado del entorno a St+1. La acción se elige del espacio de acciones.
Espacio de acciones: El conjunto de todas las acciones de que dispone el agente y que puede usar para interactuar con su entorno y modificarlo
La recompensa o el castigo de la transición de estado se comunica al agente mediante la señal de recompensa (Rt). El sistema busca aprender una estrategia de acción que encuentre el valor de recompensa acumulada más alto del entorno.
Un ejemplo simplificado de una tarea de aprendizaje por refuerzo de la vida real es un niño que aprende a caminar: el niño es el agente que intenta desplazarse por el entorno realizando acciones en forma de caminar o gatear. Cuando da algunos pasos, el niño recibe una reacción favorable de sus padres, que es análoga a la recompensa. En cambio, el niño no recibe ninguna reacción cuando gatea o no se mueve, lo que representa una recompensa negativa o castigo.

¿Qué son los agentes de trading?
En el contexto del trading, un agente de aprendizaje por refuerzo es un trader cuyo espacio de acciones consiste en comprar, vender o mantener un activo. El mercado del que forma parte el activo actúa como entorno. El estado puede presentarse en forma de estadísticas sobre el mercado actual, como medias móviles diarias, máximos y mínimos diarios o volúmenes de negociación de los activos. La recompensa en el trading puede expresarse en términos de ganancias, pérdidas u otras métricas de rendimiento. En última instancia, el objetivo del agente de trading es actuar de tal modo que maximice la recompensa futura, dado el mercado en el que opera. Un buen agente debería ser capaz de batir al mercado comprando a niveles de precio bajos y vendiendo a niveles de precio más altos. El comportamiento del agente dependerá en gran medida del método de RL elegido. En la última sección se analizan tres métodos de uso habitual, pero primero repasaremos rápidamente las ventajas de usar agentes de trading.
¿Por qué usar agentes de trading?
El trading automatizado, también conocido como trading algorítmico, implica el uso de algoritmos para la ejecución de órdenes de operación, que es el ámbito al que pertenecen los agentes de trading. Esta forma de trading tiene muchas ventajas sobre el trading humano (manual). Primero conviene distinguir entre dos tipos de trading automatizado:
1. Trading automatizado basado en reglas, en el que la estrategia está predefinida y diseñada por una persona. 2. Trading automatizado basado en aprendizaje por refuerzo, en el que la estrategia se aprende mediante aprendizaje por refuerzo.
Ambos métodos se benefician de las ventajas generales del trading automatizado. Aunque hay muchas ventajas, las más importantes son las siguientes:
- Las computadoras tienen tiempos de ejecución rápidos, lo que reduce el riesgo de perder una oportunidad por una reacción lenta al estado del mercado. - Al usar trading automatizado, no se expone al riesgo de tomar malas decisiones de trading por efectos emocionales y psicológicos, algo que las personas sufren de forma masiva. Las computadoras siempre ejecutan la estrategia para la que fueron diseñadas. - El trading automatizado se beneficia de que las computadoras son significativamente más capaces que el cerebro humano a la hora de digerir cantidades enormes de datos en tiempo real, lo que permite estrategias mucho más complejas.
Si observamos las ventajas específicas de los agentes de trading que usan aprendizaje por refuerzo, podemos añadir la siguiente ventaja clave:
- Un agente de trading nunca deja de aprender y de adaptar su estrategia. Una estrategia que en su momento fue rentable puede dejar de funcionar cuando cambia la dinámica del mercado. Un agente de trading con aprendizaje por refuerzo bien diseñado debería poder ajustar su estrategia en consecuencia.
¿Qué método elegir para los agentes de trading con aprendizaje por refuerzo?
Como se ha mencionado antes, hay distintos métodos para construir un agente de aprendizaje por refuerzo. Existen tres enfoques que usar cuando se trata de trading financiero: critic-only, actor-only y actor-critic. Critic-only, el método más usado en el ámbito del trading automatizado, funciona resolviendo un espacio de acciones discreto en forma de una función de valor Q.
Función de valor Q: medida de la recompensa total esperada, suponiendo que el agente está en el estado St y ejecuta la acción At
Al hacerlo, aprende la estrategia que maximiza la recompensa futura dado el estado actual. Los ejemplos más conocidos son Q-learning y Deep Q-learning. El principal inconveniente de estos métodos es que están diseñados para tratar únicamente problemas de espacio de acciones discreto y finito, lo que significa que las acciones que puede tomar un agente deben estar predefinidas. Por eso hay que usar técnicas especiales para convertirlo en un espacio continuo, como en el caso de comprar o vender cantidades distintas de un producto.
El segundo enfoque se llama actor-only; aquí la mayor ventaja es que el espacio de acciones puede ser continuo, ya que se aprende directamente una política en forma de distribución de probabilidad que proporciona una estrategia para cualquier estado dado.
Política: correspondencia entre un estado St y las probabilidades de seleccionar cada posible acción At dado ese estado
Sin embargo, el mayor tiempo de entrenamiento necesario para obtener las políticas óptimas puede verse como un inconveniente de este enfoque.
El tercer tipo, el marco actor-critic, combina los dos y entrena simultáneamente dos modelos: el actor, que aprende cómo hacer que el agente se comporte en un estado determinado, y el crítico, que evalúa cuán eficaz fue realmente la acción seleccionada. Dos algoritmos actor-critic de uso habitual son PPO o A2C. Aunque ambos métodos son muy populares en el trading de acciones, hay algunas diferencias entre el mercado de acciones y el de materias primas que conviene tener en cuenta al decidir nuestro enfoque.
La mayor diferencia entre los dos mercados es la cantidad de datos disponibles. Una dificultad con la que suelen toparse los investigadores al aplicar tecnologías de IA al mercado de materias primas es su falta de transparencia y la consecuencia asociada de que hay pocos datos de mercado disponibles. Por suerte, como plataforma de inteligencia de materias primas, recopilar estos datos es nuestro trabajo del día a día. La base de datos de Vesper contiene miles de series de datos que cubren, entre otras cosas, precios, futuros y datos de oferta y demanda de distintas materias primas agrícolas. Otra diferencia que hay que tener en cuenta es la naturaleza de los bienes negociados. Como las materias primas agrícolas son físicas por definición, hay que tener en cuenta restricciones adicionales. Piense en las fechas de caducidad, que obligan a los traders a vender un producto antes de una fecha determinada.
En este artículo hemos tratado los fundamentos del aprendizaje por refuerzo, qué son los agentes de trading y por qué es relevante aplicarlos al mercado de materias primas. También hemos tratado las ventajas que traen consigo y cuáles son los métodos de aprendizaje por refuerzo más adecuados para nuestro caso de uso. Si le interesa la implementación real de este método, eche un vistazo aquí, donde mostramos que los agentes de trading superan significativamente a un modelo de referencia.
Si le interesa el mercado de materias primas y cómo usamos la IA para revolucionarlo, ¡suscríbase a nuestra publicación!