强化学习是机器学习的一个领域,它最为人熟知的大概是与自动驾驶汽车的关联:汽车通过试错学会驾驶,在经历一百万次之后,知道该如何转弯、如何在红灯前停下。我知道这样讲过于简化,但您明白意思就好。
强化学习还有一个鲜为人知的应用,出现在交易领域。我们大多数人都熟悉把机器学习模型用在时间序列数据上。在 Vesper,我们用它来预测各类农产品未来数月的价格、产量与库存水平。这些模型可以指出市场的走向,却无法根据结果告诉您该采取什么行动:强化学习智能体可以根据市场的表现,告诉您何时卖出、买入或持有资产。这类应用在股市和外汇市场上越来越流行,但在大宗商品市场上还找不到任何案例。
我们(Vesper 数据科学团队)与 Slimmer.AI 一起,用三个月时间研究并开发了一个学习在大宗商品市场上交易的强化学习智能体。关于这些研发周期的更多内容,请看这里!
本文概述我们最重要的发现。我们先简要解释强化学习的概念,接着给出交易智能体的定义以及使用它的好处。最后,我们会讨论三种不同的强化学习方法及其各自的优缺点。
关于我们智能体的规格与成果,以及所用代码库的介绍,还有一篇更深入的文章,可以在这里找到。对应的 git 仓库可以在这里找到。但如果您对这个概念还比较陌生,请接着往下读!
什么是强化学习?
简单说,强化学习就是通过试错来学习的做法。模型的学习方式,是好的决策获得奖励、坏的决策受到惩罚。具体做法是调整奖励的大小,这个奖励称为强化信号,它要么为正、要么为负,并且始终是智能体所采取动作的结果。
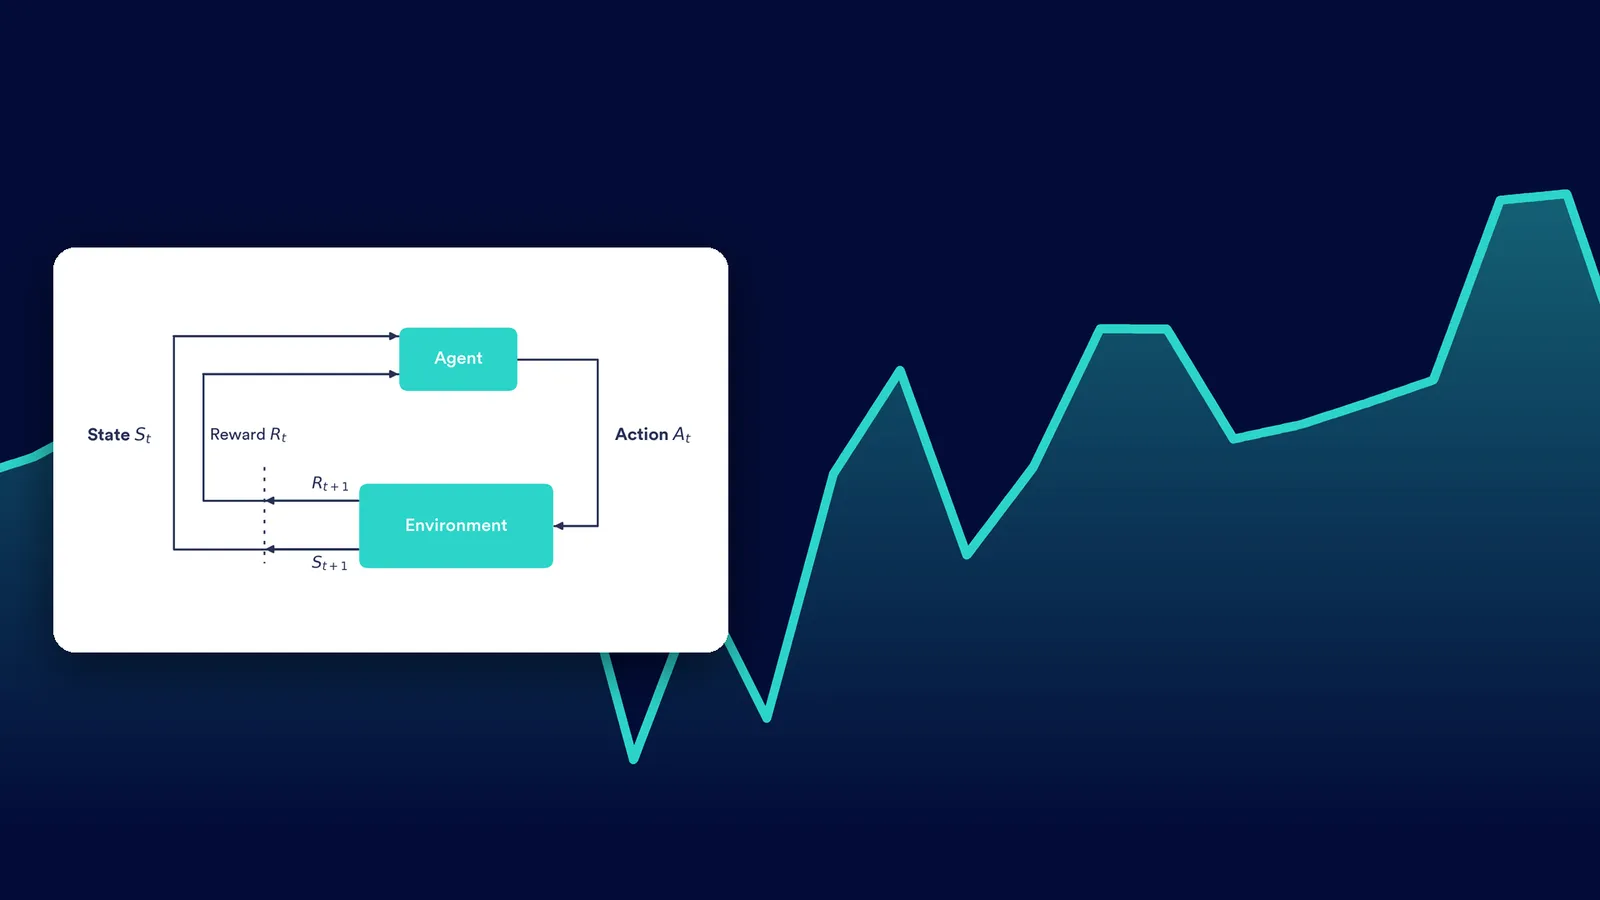
强化学习模型通过动作把智能体与环境连接起来。下图给出了这一过程的可视化。智能体获得关于环境当前状态(St)的信息。基于这些信息,智能体决定采取一个动作(At),把环境的状态改变为 St+1。该动作从动作空间中选出。
动作空间: 智能体可以用来与环境互动并改变环境的全部动作的集合
状态转移的奖励或惩罚,通过奖励信号(Rt)传达给智能体。系统的目标是学会一套动作策略,找到环境中最高的累计奖励值。
现实生活中强化学习任务的一个简化例子,是孩子学走路:孩子就是智能体,他通过走路或爬行这样的动作,尝试在环境中摸索前进。当他迈出几步时,会得到父母的正面反应,这相当于奖励。反过来,当他爬行或不动时,不会得到任何反应,这代表负的奖励或惩罚。

什么是交易智能体?
在交易的语境下,强化学习智能体就是一个交易者,它的动作空间由买入、卖出或持有某项资产构成。该资产所属的市场则充当环境。状态可以用当前市场的统计数据来表示,例如日移动平均线、当日最高价与最低价,或资产的成交量。交易中的奖励可以用利润、亏损或其他绩效指标来表达。归根结底,交易智能体的目标是在它所处的市场中,以能够最大化未来奖励的方式行动。一个好的智能体应当能够在低价位买入、在较高价位卖出,从而跑赢市场。智能体的行为在很大程度上取决于所选的强化学习方法。最后一节会讨论三种常用方法,但我们先快速过一遍使用交易智能体的好处。
为什么要使用交易智能体?
自动化交易,也称算法交易,指的是使用算法来执行交易指令,而交易智能体正属于这一领域。相比人工(手动)交易,这种交易形式有很多优势。首先,应当区分两类自动化交易:
1. 基于规则的自动化交易,其策略由人预先设定并设计。 2. 基于强化学习的自动化交易,其策略通过强化学习习得。
两种方法都享有自动化交易的普遍好处。好处很多,其中最重要的是以下几点:
- 计算机执行速度快,降低了因对市场状态反应迟缓而错失机会的风险。 - 使用自动化交易时,您不会因为情绪和心理影响而冒下糟糕交易决策的风险,而人在这方面吃的亏非常大。计算机总是会执行它们被设计去执行的策略。 - 自动化交易还得益于一个事实:在实时消化海量数据上,计算机远比人脑更有能力,这让复杂得多的策略成为可能。
当我们专门去看使用强化学习的交易智能体的好处时,还可以加上以下这条关键优势:
- 交易智能体永远不会停止学习和调整自己的策略。曾经盈利的策略,在市场动态改变之后可能不再奏效。设计良好的强化学习交易智能体,应当能够相应地调整自己的策略。
强化学习交易智能体该选择哪种方法?
如前所述,构建强化学习智能体有不同的方法。在金融交易中有三种可用的路径:仅评论家(critic-only)、仅行动者(actor-only)与行动者-评论家(actor-critic)。仅评论家是自动化交易领域中使用最多的方法,它的做法是以 Q 值函数的形式求解离散动作空间。
Q 值函数: 在智能体处于状态 St 并执行动作 At 的假设下,对总的预期奖励的度量
这样一来,它学到的就是在当前状态下最大化未来奖励的策略。最知名的例子是 Q-learning 与 Deep Q-learning。这些方法的关键缺点在于,它们被设计成只处理离散且有限的动作空间问题,也就是说智能体可以采取的动作必须预先定义好。因此必须使用特殊技巧把它转换成连续空间,比如买入或卖出不同数量产品的情形。
第二种路径称为仅行动者;在这里,最大的好处是动作空间可以是连续的,因为策略是以概率分布的形式被直接学到的,从而为任意给定的状态提供一套行动策略。
策略: 在给定某个状态 St 时,从该状态到选择每个可能动作 At 的概率的映射
不过,获得最优策略所需的训练时间更长,这可以看作这种路径的一个缺点。
第三种类型是行动者-评论家框架,它把前两者结合起来,同时训练两个模型:行动者学习如何让智能体在某个状态下做出行为,评论家则评估所选动作实际上有多有效。两种常用的行动者-评论家算法是 PPO 和 A2C。虽然这两种方法在股票交易中都很受欢迎,但股市与大宗商品市场之间存在一些差异,在决定我们的路径时应当加以考虑。
两个市场之间最大的差别是可获得数据的数量。研究者在把 AI 技术应用到大宗商品市场时经常遇到的一个困难,是它缺乏透明度,以及随之而来的市场数据稀少。幸运的是,作为一个大宗商品情报平台,采集这些数据正是我们的日常工作。Vesper 的数据库包含数千条数据序列,涵盖各类农产品的价格、期货以及供需数据等。另一个需要考虑的差别是所交易货物的性质。由于农产品按定义就是实物,必须考虑额外的约束条件。想想那些迫使交易者必须在某个日期之前卖出产品的保质期。
在本文中,我们讨论了强化学习的基础、什么是交易智能体,以及为什么它们适合应用到大宗商品市场。我们还讨论了它们带来的好处,以及哪些强化学习方法最适合我们的用例。如果您对这一方法的实际实现感兴趣,请看这里,我们在那里展示了交易智能体显著优于基准模型。
如果您对大宗商品市场以及我们如何用 AI 颠覆它感兴趣,请订阅我们的刊物!