Uczenie ze wzmocnieniem, obszar uczenia maszynowego, najczęściej kojarzone jest chyba z pojazdami autonomicznymi: samochód uczy się jeździć metodą prób i błędów, a po milionie powtórzeń wie, jak pokonać zakręt i zatrzymać się na czerwonym świetle. Wiem, że to duże uproszczenie, ale wiesz, o co chodzi.
Mniej znane zastosowanie uczenia ze wzmocnieniem można znaleźć w świecie handlu. Większość z nas zna stosowanie modeli uczenia maszynowego do danych szeregów czasowych. W Vesper robimy to, żeby przewidywać ceny, produkcję i poziomy zapasów różnych surowców rolnych na kilka miesięcy w przód. Modele te mogą wskazać, dokąd zmierza rynek, ale nie powiedzą Ci, jakie działanie podjąć na podstawie ich wyniku: agenci uczenia ze wzmocnieniem potrafią powiedzieć, kiedy sprzedać, kupić lub zatrzymać swoje aktywa, w zależności od tego, jak zachowuje się rynek. Choć zastosowania tego rodzaju zyskują na popularności na rynkach akcji i forex, nie znaleziono jeszcze żadnych przypadków zastosowania ich na rynkach surowców.
Wspólnie ze Slimmer.AI my (zespół Data Science Vesper) spędziliśmy trzy miesiące na badaniu i budowie agenta RL, który uczy się handlować na rynku surowców. Więcej o tych cyklach badawczo-rozwojowych przeczytasz tutaj!
Ten artykuł daje przegląd naszych najważniejszych ustaleń. Zaczniemy od krótkiego wyjaśnienia koncepcji uczenia ze wzmocnieniem, a potem przejdziemy do definicji agenta tradingowego i korzyści z jego stosowania. Na koniec omówimy trzy różne metody uczenia ze wzmocnieniem oraz odpowiadające im plusy i minusy.
Bardziej szczegółowy artykuł o specyfikacji naszych agentów i ich osiągnięciach, a także wprowadzenie do wykorzystanej biblioteki, znajdziesz tutaj. Odpowiednie repozytorium git znajdziesz tutaj. Ale jeśli dopiero poznajesz tę koncepcję, czytaj dalej!
Czym jest uczenie ze wzmocnieniem?
Mówiąc prosto, uczenie ze wzmocnieniem to praktyka uczenia się metodą prób i błędów. Model uczy się dzięki temu, że za dobre decyzje jest nagradzany, a za złe karany. Odbywa się to przez dostosowywanie wielkości nagrody, nazywanej sygnałem wzmocnienia, która jest albo dodatnia, albo ujemna i zawsze stanowi konsekwencję działania podjętego przez agenta.
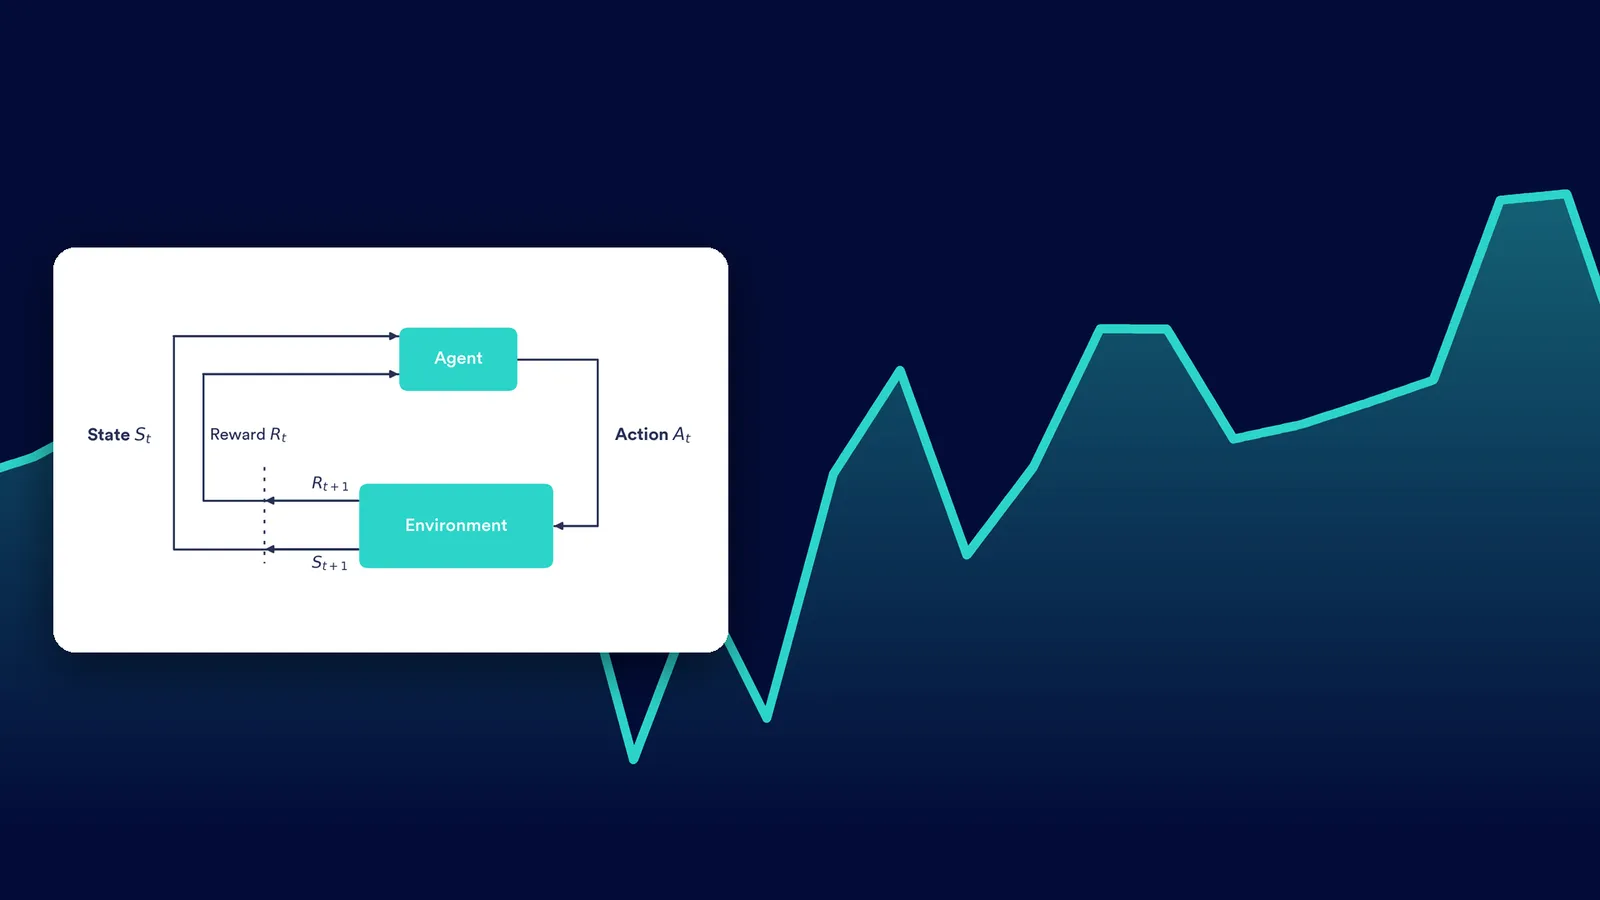
Model uczenia ze wzmocnieniem łączy agenta ze środowiskiem poprzez działanie. Wizualizację tego pokazuje rysunek poniżej. Agent otrzymuje informację o bieżącym stanie (St) środowiska. Na podstawie tej informacji agent decyduje o działaniu (At), zmieniając stan środowiska na St+1. Działanie jest wybierane z przestrzeni działań.
Przestrzeń działań: Zbiór wszystkich działań dostępnych agentowi, których może użyć, żeby wejść w interakcję ze swoim środowiskiem i je zmienić
Nagroda lub kara za przejście między stanami jest przekazywana agentowi przez sygnał nagrody (Rt). System dąży do nauczenia się strategii wyboru działań, która znajduje najwyższą skumulowaną wartość nagrody w środowisku.
Uproszczonym przykładem rzeczywistego zadania uczenia ze wzmocnieniem jest dziecko uczące się chodzić: dziecko jest agentem, który próbuje poruszać się po środowisku, podejmując działania w postaci chodzenia lub raczkowania. Kiedy zrobi kilka kroków, otrzymuje od rodziców przychylną reakcję, która jest odpowiednikiem nagrody. I odwrotnie, kiedy raczkuje albo się nie rusza, nie otrzymuje żadnej reakcji, co stanowi negatywną nagrodę, czyli karę.

Czym są agenci tradingowi?
W kontekście handlu agent uczenia ze wzmocnieniem jest traderem, którego przestrzeń działań obejmuje kupno, sprzedaż lub utrzymanie aktywa. Rynek, którego częścią jest to aktywo, pełni rolę środowiska. Stan może być przedstawiony w postaci statystyk dotyczących bieżącego rynku, takich jak dzienne średnie kroczące, dzienne maksima i minima czy wolumeny obrotu aktywami. Nagrodę w handlu można wyrazić w kategoriach zysków, strat lub innych wskaźników wyników. Ostatecznie celem agenta tradingowego jest działanie w taki sposób, żeby maksymalizował przyszłą nagrodę przy danym rynku, na którym działa. Dobry agent powinien umieć pobić rynek, kupując przy niskich poziomach cen i sprzedając przy wyższych. Zachowanie agenta w dużej mierze zależy od wybranej metody RL. Trzy powszechnie stosowane metody omawiamy w ostatniej sekcji, ale najpierw szybko przejdziemy przez korzyści ze stosowania agentów tradingowych.
Po co używać agentów tradingowych?
Handel zautomatyzowany, znany też jako handel algorytmiczny, polega na wykorzystaniu algorytmów do realizacji zleceń, i to właśnie w tej dziedzinie mieszczą się agenci tradingowi. Ta forma handlu ma wiele przewag nad handlem prowadzonym przez człowieka (ręcznym). Najpierw trzeba rozróżnić dwa rodzaje handlu zautomatyzowanego:
1. Handel zautomatyzowany oparty na regułach, w którym strategia jest z góry zdefiniowana i zaprojektowana przez człowieka. 2. Handel zautomatyzowany oparty na uczeniu ze wzmocnieniem, w którym strategia jest wyuczona za pomocą uczenia ze wzmocnieniem.
Obie metody korzystają z ogólnych zalet handlu zautomatyzowanego. Choć korzyści jest wiele, najważniejsze są następujące:
- Komputery mają krótkie czasy realizacji, co zmniejsza ryzyko przegapienia okazji z powodu wolnej reakcji na stan rynku. - Korzystając z handlu zautomatyzowanego, nie ponosisz ryzyka podejmowania słabych decyzji handlowych pod wpływem emocji i czynników psychologicznych, na co ludzie cierpią w ogromnym stopniu. Komputery zawsze wykonają strategię, do której wykonywania zostały zaprojektowane. - Handel zautomatyzowany korzysta z faktu, że komputery są znacznie sprawniejsze od ludzkich mózgów w przetwarzaniu ogromnych ilości danych w czasie rzeczywistym, co pozwala na znacznie bardziej złożone strategie.
Kiedy spojrzymy na korzyści specyficzne dla agentów tradingowych wykorzystujących uczenie ze wzmocnieniem, możemy dodać następującą kluczową zaletę:
- Agent tradingowy nigdy nie przestaje się uczyć i dostosowywać swojej strategii. Strategia, która kiedyś była zyskowna, może przestać działać, gdy zmieni się dynamika rynku. Dobrze zaprojektowany agent tradingowy uczenia ze wzmocnieniem powinien umieć odpowiednio dostosować swoją strategię.
Jaką metodę wybrać dla agentów tradingowych uczenia ze wzmocnieniem?
Jak wspomnieliśmy wcześniej, istnieją różne metody budowania agenta uczenia ze wzmocnieniem. W handlu finansowym stosuje się trzy podejścia: tylko krytyk (critic-only), tylko aktor (actor-only) oraz aktor-krytyk (actor-critic). Tylko krytyk, najczęściej stosowana metoda w dziedzinie handlu zautomatyzowanego, działa przez rozwiązywanie dyskretnej przestrzeni działań w postaci funkcji wartości Q.
Funkcja wartości Q: miara całkowitej oczekiwanej nagrody przy założeniu, że agent jest w stanie St i wykonuje działanie At
Robiąc to, uczy się strategii, która maksymalizuje przyszłą nagrodę przy danym bieżącym stanie. Najlepiej znane przykłady to Q-learning i Deep Q-learning. Kluczową wadą tych metod jest to, że są zaprojektowane wyłącznie do problemów z dyskretną i skończoną przestrzenią działań, co oznacza, że działania, które agent może podjąć, muszą być z góry zdefiniowane. Dlatego trzeba stosować specjalne techniki, żeby przekształcić ją w przestrzeń ciągłą, jak w przypadku kupna lub sprzedaży różnych ilości produktu.
Drugie podejście nazywa się tylko aktor; tutaj największą zaletą jest to, że przestrzeń działań może być ciągła, ponieważ polityka jest uczona bezpośrednio w postaci rozkładu prawdopodobieństwa, który dostarcza strategię dla dowolnego stanu.
Polityka: odwzorowanie pewnego stanu St na prawdopodobieństwa wyboru każdego możliwego działania At przy tym stanie
Wadą tego podejścia może być jednak dłuższy czas treningu potrzebny do uzyskania optymalnych polityk.
Trzeci typ, framework aktor-krytyk, łączy oba i jednocześnie trenuje dwa modele: aktora, który uczy się, jak doprowadzić agenta do określonego zachowania w danym stanie, oraz krytyka, który ocenia, jak skuteczne faktycznie było wybrane działanie. Dwa powszechnie stosowane algorytmy aktor-krytyk to PPO i A2C. Choć obie metody są bardzo popularne, gdy spojrzeć na handel akcjami, między rynkiem akcji a rynkiem surowców istnieją różnice, które należy wziąć pod uwagę przy decyzji o naszym podejściu.
Największa różnica między tymi dwoma rynkami to ilość dostępnych danych. Trudnością, na którą badacze często natrafiają przy stosowaniu technologii AI na rynku surowców, jest jego brak przejrzystości i wynikająca z tego niewielka ilość dostępnych danych rynkowych. Na szczęście jako platforma analityki surowcowej gromadzimy te dane na co dzień. Baza danych Vesper zawiera tysiące serii danych obejmujących między innymi ceny, kontrakty terminowe oraz dane o podaży i popycie różnych surowców rolnych. Kolejna różnica, którą trzeba wziąć pod uwagę, to charakter sprzedawanych dóbr. Ponieważ surowce rolne są z definicji fizyczne, trzeba uwzględnić dodatkowe ograniczenia. Pomyśl o datach przydatności, które zmuszają traderów do sprzedaży produktu przed określoną datą.
W tym artykule omówiliśmy podstawy uczenia ze wzmocnieniem, to, czym są agenci tradingowi, i dlaczego warto stosować je na rynku surowców. Omówiliśmy też płynące z nich korzyści oraz to, które metody uczenia ze wzmocnieniem są najbardziej odpowiednie dla naszego zastosowania. Jeśli interesuje Cię faktyczne wdrożenie tej metody, zajrzyj tutaj, gdzie pokazujemy, że agenci tradingowi znacząco przewyższają model odniesienia.
Jeśli interesuje Cię rynek surowców i to, jak wykorzystujemy AI, żeby go zmienić, zasubskrybuj naszą publikację!