Pendant des années, les acheteurs, vendeurs, traders et analystes de matières premières ont dû s’appuyer sur des sources de données fragmentées, ce qui rendait difficile de suivre les évolutions du marché et de décider au bon moment. Faute d’un point central d’information fiable, ces professionnels passaient souvent des heures à reconstituer les données pour rester informés et établir des prévisions.
Aujourd’hui, les plateformes de veille sur les matières premières comme Vesper résolvent ce problème en offrant une solution tout-en-un, qui réunit toutes les données de prix essentielles, les rapports de marché et les prévisions en un seul endroit facile d’accès.
Pourtant, aussi utiles soient-elles, ces plateformes regorgent aussi d’outils et d’informations puissants, dans lesquels il peut être écrasant de naviguer. Les utilisateurs rencontrent souvent des difficultés : déterminer le produit exact dont ils ont besoin (par exemple, parcourir 33 types de farine différents) ou comprendre comment interpréter nos outils de prévision pour éclairer leurs décisions budgétaires.
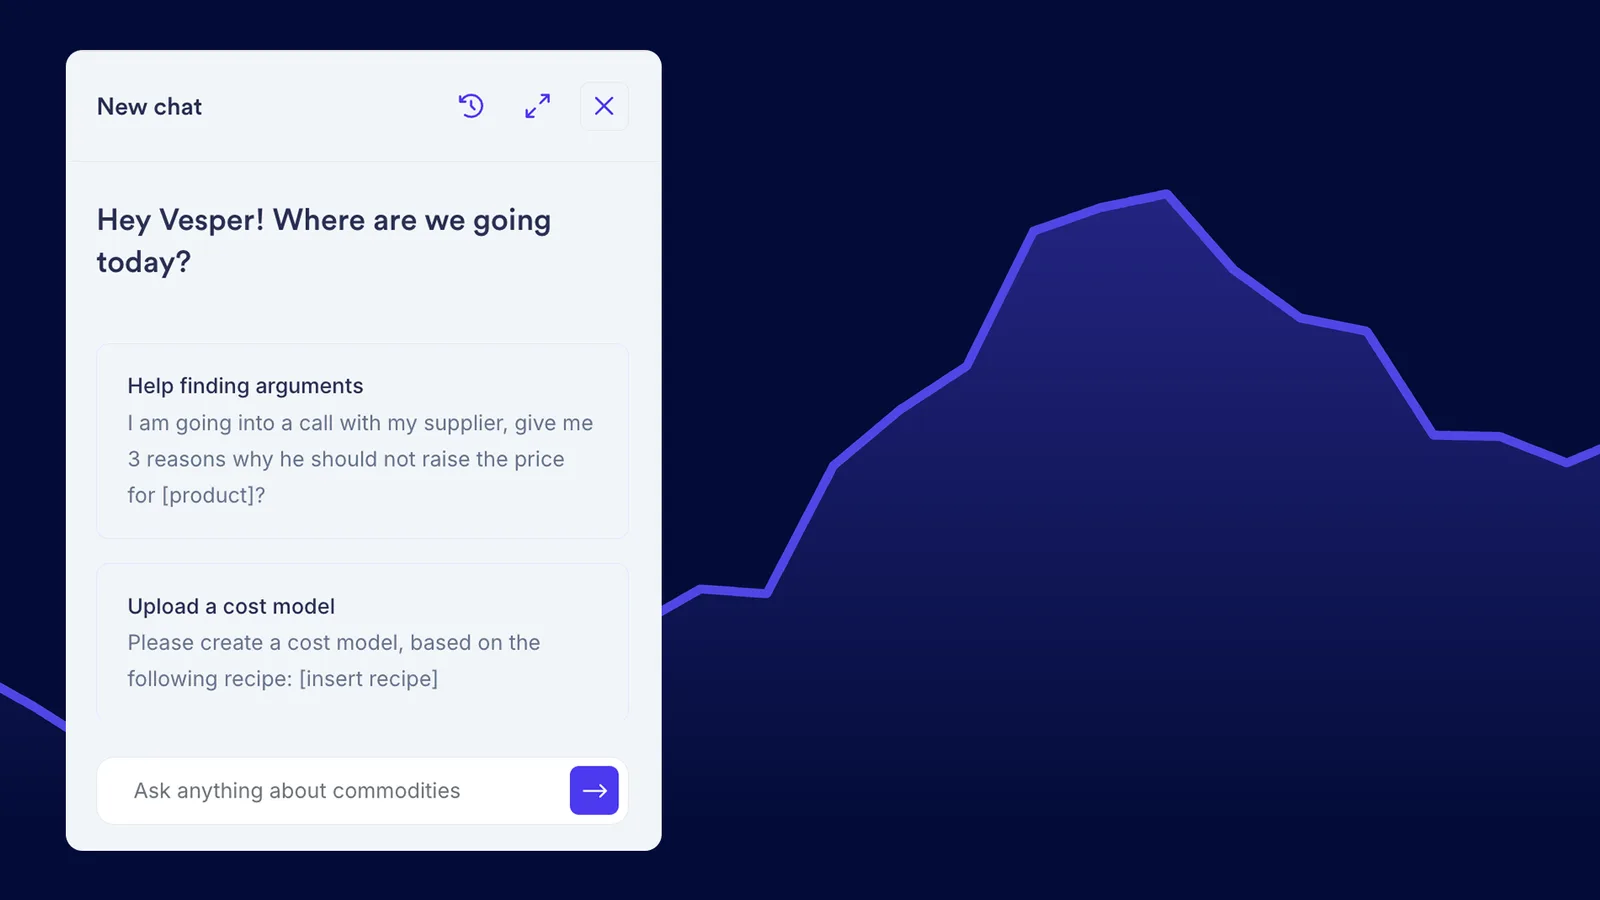
La mission de Vesper est de rester la plateforme de veille sur les matières premières la plus simple d’utilisation du marché, en améliorant sans cesse son accessibilité et sa facilité d’usage. Dans le cadre de cet engagement, nous avons lancé Vesbot : un chatbot propulsé par l’IA qui apporte des réponses et des conseils instantanés sans interrompre le flux de travail. Construit à partir de modèles ChatGPT adaptés spécifiquement aux données et aux cas d’usage de Vesper, Vesbot met rapidement les utilisateurs en relation avec les analyses pertinentes, les guide dans les fonctionnalités de la plateforme et fournit une assistance contextuelle pour les décisions complexes. Vesbot fluidifie l’expérience utilisateur en réduisant le temps passé à chercher des réponses et propose un support 24 h/24, ce qui permet aux utilisateurs de décider plus vite et de façon mieux informée, et d’exploiter pleinement les capacités de Vesper.
Avec Vesbot, les utilisateurs accèdent sans friction à l’ensemble des analyses et des données de Vesper, sans avoir à naviguer dans une grande plateforme ni à attendre un support humain, ce qui porte la veille sur les matières premières à de nouveaux niveaux d’accessibilité et d’efficacité.
Dans cet article, vous découvrirez le parcours qui a mené à la création de Vesbot : l’approche technique retenue, les difficultés rencontrées et les développements à venir. À la fin, vous comprendrez mieux le fonctionnement de Vesbot, les innovations en IA qui l’animent et la façon dont il est conçu pour offrir à nos utilisateurs des analyses plus rapides et plus fines.
Comment avons-nous abordé la création d’un chatbot sur mesure ?
Pourquoi avons-nous lancé ce projet, et comment nous y sommes-nous pris ? Beaucoup d’entre vous connaissent sûrement déjà ChatGPT. Ce chatbot, qui est essentiellement un modèle d’IA associé à une interface utilisateur, est remarquable pour apporter des réponses d’une façon qui semble très humaine. En revanche, traiter des questions propres à votre cas d’usage peut s’avérer difficile. C’est qu’il lui manque les informations nécessaires pour comprendre pleinement votre question. Pour y parvenir, le modèle devrait connaître les données liées à ce cas d’usage précis.
Il existe plusieurs méthodes pour personnaliser un chatbot afin de traiter des cas d’usage spécifiques. Nous avons exploré diverses options, notamment entraîner le chatbot avec un jeu prédéfini de questions-réponses ou utiliser des systèmes à base de règles pour des scénarios précis. Nous avons finalement retenu l’approche Retrieval-Augmented Generation (RAG).
Le RAG se distingue parce qu’il permet au chatbot d’accéder à une vaste base de données et d’y récupérer des informations en temps réel, ce qui garantit des réponses toujours à jour. Cette approche permet au chatbot d’aller chercher les données les plus pertinentes pour répondre avec exactitude. Le RAG renforce par ailleurs sa capacité à fournir des réponses adaptées au contexte, tout en nous laissant la souplesse de l’ajuster avec des données et des analyses propres à vos besoins.
Les grands modèles de langage et leur adaptation
Dans ce chapitre, je vais présenter quelques concepts techniques clés, indispensables pour comprendre les systèmes RAG. Si vous les connaissez déjà, n’hésitez pas à passer directement à la section « Comment fonctionne le RAG ? ».
Les grands modèles de langage (LLM)
Les LLM reposent souvent sur des architectures de type transformeur : ils prennent une entrée, l’encodent, puis la décodent pour produire une sortie, comme les autres modèles fondés sur des transformeurs. La différence clé entre les LLM et les transformeurs ordinaires tient à leur entraînement sur des jeux de données extrêmement volumineux, qui incluent des sources comme des sites web, des livres, des articles de recherche, et bien d’autres. Cet entraînement massif permet aux LLM de développer une compréhension profonde du langage.
Voyez un LLM comme un apprenant hors norme qui lit des milliards de phrases pour comprendre le langage comme le font les humains, contexte et indices culturels compris. Il apprend seul à partir de quantités considérables de textes, sans que personne ait à le lui enseigner explicitement. C’est cette capacité d’auto-apprentissage qui rend les LLM si utiles dans des contextes variés, par exemple pour faire fonctionner des chatbots.
Les LLM sont extrêmement polyvalents et peuvent s’appliquer à tout projet impliquant du texte. Ils peuvent par exemple analyser le ton d’un article de presse pour déterminer s’il est positif ou négatif. Nous les utilisons pour créer des chatbots capables de converser naturellement, avec des réponses plus intuitives et plus humaines.
Le prompting
On peut décrire le prompting comme une façon de communiquer avec un LLM. En lui donnant un ensemble d’instructions, vous pouvez adapter le LLM à vos cas d’usage. La qualité du prompt est déterminante, car plus l’instruction est efficace, meilleure est la réponse obtenue. Imaginez que vous posiez une question à ChatGPT, mais que la réponse ne soit pas tout à fait celle que vous espériez. Vous allez peut-être reformuler la question, ajouter du contexte ou préciser certains détails. Ce travail d’affinage de votre entrée, c’est essentiellement le prompt engineering.
Le fine-tuning
Le fine-tuning consiste à apprendre à un modèle pré-entraîné à mieux accomplir une tâche précise. Pour les LLM, cela passe par une méthode d’apprentissage supervisé : le modèle est entraîné avec un jeu de données étiqueté. Par exemple, si vous faites du fine-tuning sur un LLM pour de l’analyse de sentiment, vous utiliserez un jeu de données où chaque texte est marqué « positif » ou « négatif ». Pendant le fine-tuning, le modèle ajuste ses réglages internes pour mieux prédire les étiquettes. Ce processus personnalise le LLM et améliore sa précision pour votre projet. Le fine-tuning rend le modèle plus performant pour votre application que dans sa forme d’origine.
RAG
Maintenant que vous comprenez les notions de LLM, de prompting et de fine-tuning, parlons de la méthode que nous avons retenue pour notre application : le RAG.
En termes simples, le RAG est une technique qui permet d’ajouter vos propres données à un LLM pour qu’il génère des réponses plus exactes et plus pertinentes. Cette méthode répond à deux difficultés majeures que rencontrent couramment les LLM : les hallucinations et l’information obsolète.
Les hallucinations se produisent lorsqu’un LLM génère des informations fausses, souvent parce qu’il ne connaît pas la réponse mais tente quand même d’en fournir une. L’information obsolète pose problème parce que les LLM sont entraînés sur les données disponibles jusqu’à la date de leur entraînement, et qu’ils n’ont donc pas les informations les plus récentes.
Comme nous construisons un chatbot, fournir aux utilisateurs des informations à jour et exactes est essentiel. Des réponses obsolètes ou fausses peuvent éroder la confiance et réduire l’efficacité de l’application.
Le RAG nous permet d’atténuer ces problèmes. Le modèle récupère les informations pertinentes dans un jeu de données spécifique et à jour, et les combine à ses capacités de génération de langage, ce qui garantit des réponses à la fois exactes et actuelles.
Je vais maintenant expliquer un peu plus en détail comment fonctionne le RAG et les étapes nécessaires pour le mettre en œuvre efficacement.
Comment fonctionne le RAG ?

Pour bien saisir comment le RAG permet aux LLM de produire des réponses plus exactes et plus pertinentes sur le plan contextuel, il faut explorer trois composantes essentielles : la documentation externe, le processus de récupération et la phase d’augmentation. L’image ci-dessus illustre ces notions en détail.
La documentation externe
Les LLM sont entraînés sur de vastes jeux de données, mais ceux-ci ne contiennent pas d’informations spécifiques ou à jour au-delà de leurs données d’entraînement d’origine. Les données externes, qui peuvent se présenter sous divers formats comme des bases de données structurées, des PDF ou de simples documents texte, doivent être intégrées à la base de connaissances du modèle. Pour cela, elles sont converties en format numérique et stockées dans des bases de données vectorielles, ce qui les rend accessibles et interprétables par le LLM.
La récupération
Une fois nos données externes stockées dans une base de données vectorielle, l’étape suivante est le processus de récupération. Nos données externes contiennent de nombreux documents différents, et l’objectif de la récupération est de ne renvoyer que les parties de ces documents liées à la requête de l’utilisateur. Les documents les plus pertinents sont renvoyés à l’aide d’un score de pertinence, fondé sur le degré de correspondance entre la requête et le contenu des documents.
Par exemple, si un utilisateur pose une question du type « je veux modifier mon compte » au chatbot de la FAQ, le système de récupération parcourt les données pour trouver les documents liés à la gestion de compte. L’algorithme peut en outre donner la priorité aux documents qui traitent spécifiquement des modifications ou des procédures de compte les plus courantes, afin que l’utilisateur obtienne l’information la plus pertinente et la plus utile.
L’augmentation
Une fois les documents pertinents récupérés, le LLM utilise ces données, ainsi que le prompt fourni, pour générer une réponse. À cette étape, le prompt joue un rôle crucial. Comme indiqué plus haut, un prompt bien conçu peut influencer sensiblement le LLM pour qu’il produise une réponse conforme à vos attentes. En combinant des données externes exactes et un prompt soigneusement conçu, le RAG garantit que le LLM peut fournir une réponse précise et pertinente sur le plan contextuel.
L’importance d’une documentation de qualité
L’efficacité de notre chatbot d’aide et de support repose sur la qualité et l’organisation des informations que nous fournissons au système RAG. En sélectionnant et en structurant soigneusement ces documents, nous faisons en sorte que le chatbot puisse apporter des réponses précises et utiles aux demandes des utilisateurs.
Pour maximiser l’utilité du chatbot, nous avons organisé les données en sections distinctes. Comme il s’agit d’un chatbot conçu pour la plateforme Vesper, il est essentiel d’y inclure une documentation complète sur ses différentes fonctionnalités et fonctions. Nous avons intégré les types de documents suivants :
Navigation et structure de la plateforme :
- Objectif : aider les utilisateurs à naviguer facilement dans la plateforme Vesper.
- Contenu : des descriptions détaillées de la structure de la plateforme, dont la façon d’accéder aux différentes sections et d’utiliser les diverses fonctionnalités. Cela inclut aussi des guides produits qui donnent des instructions pas à pas pour utiliser des parties précises de l’outil.
Documentation des fonctionnalités :
- Objectif : fournir des réponses rapides et exactes sur les fonctionnalités spécifiques de la plateforme.
- Contenu : des informations sur les fonctionnalités avancées comme le téléchargement de données et les intégrations API.
Rapports de marché et analyses régionales :
- Objectif : éclairer les types d’analyses que nous couvrons pour les différentes matières premières.
- Contenu : des explications sur les rapports consacrés aux différentes matières premières, avec leur intérêt et leur usage dans la plateforme.
Disponibilité des données :
- Objectif : informer les utilisateurs des séries de données disponibles sur la plateforme Vesper.
- Contenu : une liste exhaustive des données disponibles sur la plateforme.
À partir de ces données, les exemples suivants montrent comment le chatbot est désormais capable d’aider nos utilisateurs sur des questions très précises liées à la plateforme :

L’importance de la qualité des données externes
Tout au long du développement du chatbot, nous avons rencontré des difficultés liées à la qualité et à la structure des documents. Des documents de qualité et bien organisés sont déterminants, car ils influent directement sur la capacité du chatbot à récupérer et à restituer des informations exactes. Des documents mal structurés ou obsolètes peuvent conduire à des réponses hors sujet ou fausses, ce qui pourrait réduire la confiance des utilisateurs dans le système et, dans le pire des cas, faire plus de mal que de bien.
Pour y remédier, nous avons veillé à ce que tous les documents soient bien organisés et régulièrement mis à jour. Cela améliore non seulement le processus de récupération, mais garantit aussi que les utilisateurs reçoivent les informations les plus actuelles et les plus exactes possible. À mesure que nous élargissons les capacités du chatbot, maintenir la qualité et la pertinence de ces documents reste une priorité absolue.
Développements à venir
Notre chatbot actuel fonctionne très bien et aidera nos utilisateurs de bien des façons, mais nous visons une performance encore meilleure. Nous nous efforçons d’améliorer continuellement le service en analysant les interactions des utilisateurs. Nous pouvons ainsi voir quels types de demandes sont formulés et orienter nos développements futurs en conséquence. Par exemple, si les questions sur l’état actuel du marché sont nombreuses, nous pouvons explorer des moyens de mieux fournir cette information à nos utilisateurs.
L’un de nos plus grands défis à venir sera de garantir que le chatbot fournisse systématiquement des informations à jour. Cela suppose d’actualiser régulièrement sa base de connaissances avec les données les plus récentes, en particulier dans des domaines qui évoluent vite. Notre objectif n’est pas seulement de faire du chatbot un véritable partenaire de conversation, mais aussi de garantir qu’il délivre toujours l’information la plus actuelle et la plus pertinente. En nous concentrant sur ces aspects, nous entendons offrir une assistance au bon moment sur des sujets variés, afin que nos utilisateurs reçoivent des réponses exactes et utiles.
Nous avons hâte de voir ce chatbot devenir un assistant véritablement complet, qui ne se contente pas de répondre aux questions mais apporte aussi des analyses du marché, des recommandations personnalisées, et aide même à des décisions complexes.
Suivez les publications de Tuğçe Güneş, Machine Learning Engineer chez Vesper, pour rester informé de la suite de ce parcours de développement !