Για χρόνια, αγοραστές, πωλητές, traders και αναλυτές εμπορευμάτων έπρεπε να στηρίζονται σε κατακερματισμένες πηγές δεδομένων, κάτι που δυσκόλευε την παρακολούθηση των αλλαγών της αγοράς και τη λήψη έγκαιρων αποφάσεων. Χωρίς έναν κεντρικό κόμβο αξιόπιστης πληροφόρησης, οι επαγγελματίες συχνά περνούσαν ώρες συναρμολογώντας δεδομένα για να μένουν ενημερωμένοι και να κάνουν προβλέψεις.
Σήμερα, πλατφόρμες πληροφόρησης εμπορευμάτων όπως η Vesper λύνουν αυτό το πρόβλημα προσφέροντας μια ενιαία λύση, που συγκεντρώνει όλα τα βασικά δεδομένα τιμών, τις εκθέσεις αγοράς και τις προβλέψεις σε ένα μόνο, εύκολα προσβάσιμο σημείο.
Ωστόσο, όσο χρήσιμες κι αν είναι αυτές οι πλατφόρμες, είναι επίσης γεμάτες ισχυρά εργαλεία και πληροφορίες, κάτι που μπορεί να κάνει την πλοήγηση συντριπτική. Οι χρήστες συχνά αντιμετωπίζουν προκλήσεις όπως ο εντοπισμός του ακριβούς προϊόντος που χρειάζονται (για παράδειγμα, η πλοήγηση ανάμεσα σε 33 διαφορετικούς τύπους αλευριού) ή η κατανόηση του πώς να ερμηνεύσουν τα εργαλεία πρόβλεψης για να στηρίξουν τις αποφάσεις προϋπολογισμού τους.
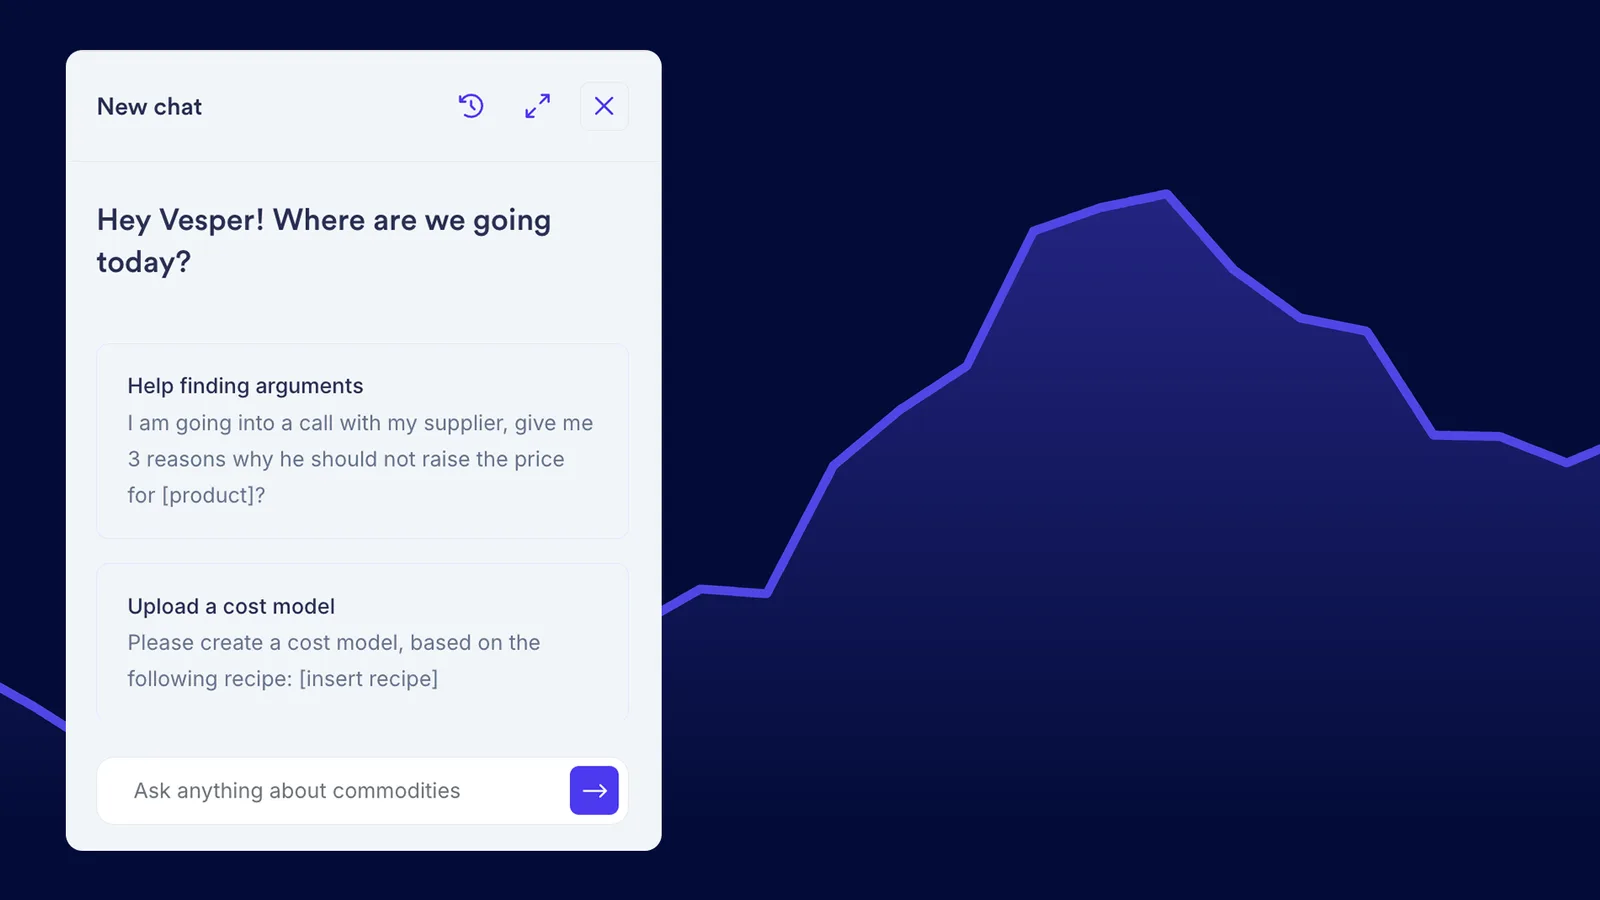
Η αποστολή της Vesper είναι να παραμείνει η πιο φιλική προς τον χρήστη πλατφόρμα πληροφόρησης εμπορευμάτων στην αγορά, βελτιώνοντας διαρκώς την προσβασιμότητα και την ευκολία χρήσης. Στο πλαίσιο αυτής της δέσμευσης, παρουσιάσαμε το Vesbot: ένα chatbot με τεχνητή νοημοσύνη που δίνει άμεσες απαντήσεις και καθοδήγηση χωρίς να διακόπτει τη ροή εργασίας. Χτισμένο με μοντέλα ChatGPT προσαρμοσμένα ειδικά στα δεδομένα και στις περιπτώσεις χρήσης της Vesper, το Vesbot συνδέει γρήγορα τους χρήστες με τις σχετικές γνώσεις, τους καθοδηγεί στις λειτουργίες της πλατφόρμας και προσφέρει βοήθεια με βάση το εκάστοτε πλαίσιο για σύνθετες αποφάσεις. Το Vesbot απλοποιεί την εμπειρία χρήσης μειώνοντας τον χρόνο αναζήτησης απαντήσεων και προσφέρει υποστήριξη όλο το εικοσιτετράωρο, επιτρέποντας στους χρήστες να παίρνουν ταχύτερες και πιο τεκμηριωμένες αποφάσεις και να αξιοποιούν πλήρως τις δυνατότητες της Vesper.
Με το Vesbot, οι χρήστες μπορούν να αποκτήσουν απρόσκοπτη πρόσβαση σε όλο το φάσμα γνώσεων και δεδομένων της Vesper, χωρίς την τριβή της πλοήγησης σε μια μεγάλη πλατφόρμα ή της αναμονής για ανθρώπινη υποστήριξη, φέρνοντας την πληροφόρηση των εμπορευμάτων σε νέα επίπεδα προσβασιμότητας και αποτελεσματικότητας.
Σε αυτό το άρθρο θα ανακαλύψετε τη διαδρομή πίσω από τη δημιουργία του Vesbot, την τεχνική προσέγγιση που επιλέξαμε, τις προκλήσεις που συναντήσαμε και τις μελλοντικές εξελίξεις που σχεδιάζουμε. Στο τέλος θα έχετε βαθύτερη κατανόηση του πώς λειτουργεί το Vesbot, των καινοτομιών τεχνητής νοημοσύνης που το τροφοδοτούν και του πώς είναι σχεδιασμένο να προσφέρει ταχύτερες και εξυπνότερες γνώσεις στους χρήστες μας.
Πώς προσεγγίσαμε τη δημιουργία ενός εξατομικευμένου chatbot;
Γιατί λοιπόν ξεκινήσαμε αυτό το έργο και πώς το αντιμετωπίσαμε; Είμαι σίγουρη ότι πολλοί από εσάς γνωρίζετε ήδη το ChatGPT. Αυτό το chatbot, που στην ουσία είναι ένα μοντέλο τεχνητής νοημοσύνης σε συνδυασμό με μια διεπαφή χρήστη, είναι εκπληκτικό στο να δίνει απαντήσεις με τρόπο που μοιάζει πολύ ανθρώπινος. Η αντιμετώπιση όμως ερωτήσεων ειδικά για τη δική σας περίπτωση χρήσης μπορεί να είναι δύσκολη. Αυτό συμβαίνει επειδή του λείπει η απαραίτητη πληροφορία για να κατανοήσει πλήρως την ερώτησή σας. Για να αποκτήσει αυτή τη δυνατότητα, το μοντέλο θα έπρεπε να γνωρίζει δεδομένα που σχετίζονται με τη συγκεκριμένη περίπτωση χρήσης.
Υπάρχουν αρκετές μέθοδοι για την προσαρμογή ενός chatbot σε συγκεκριμένες περιπτώσεις χρήσης. Εξετάσαμε διάφορες επιλογές, όπως η εκπαίδευση του chatbot με ένα προκαθορισμένο σύνολο ερωτήσεων και απαντήσεων ή η χρήση συστημάτων βασισμένων σε κανόνες για συγκεκριμένα σενάρια. Τελικά επιλέξαμε την προσέγγιση Retrieval-Augmented Generation (RAG).
Το RAG ξεχωρίζει επειδή επιτρέπει στο chatbot να προσπελαύνει και να ανακτά πληροφορίες από μια τεράστια βάση δεδομένων σε πραγματικό χρόνο, εξασφαλίζοντας ότι οι απαντήσεις είναι πάντα επίκαιρες. Η προσέγγιση αυτή επιτρέπει στο chatbot να αντλεί τα πιο σχετικά δεδομένα ώστε να απαντά με ακρίβεια. Επιπλέον, το RAG ενισχύει την ικανότητα του chatbot να δίνει απαντήσεις κατάλληλες για το εκάστοτε πλαίσιο, δίνοντάς μας παράλληλα την ευελιξία να το προσαρμόσουμε με δεδομένα και γνώσεις ειδικά για τις δικές σας ανάγκες.
Τα μεγάλα γλωσσικά μοντέλα και η προσαρμογή τους
Σε αυτό το κεφάλαιο θα παρουσιάσω ορισμένες βασικές τεχνικές έννοιες που είναι θεμελιώδεις για την κατανόηση των συστημάτων RAG. Αν τις γνωρίζετε ήδη, μπορείτε να προχωρήσετε απευθείας στην ενότητα «Πώς λειτουργεί το RAG;».
Μεγάλα γλωσσικά μοντέλα (LLM)
Τα LLM βασίζονται συχνά σε αρχιτεκτονικές transformer, δηλαδή δέχονται μια είσοδο, την κωδικοποιούν και στη συνέχεια την αποκωδικοποιούν για να παραγάγουν έξοδο, όπως και άλλα μοντέλα τύπου transformer. Η βασική διαφορά ανάμεσα στα LLM και στους συνηθισμένους transformers είναι η εκπαίδευσή τους σε εξαιρετικά μεγάλα σύνολα δεδομένων, που περιλαμβάνουν πηγές όπως ιστότοπους, βιβλία, ερευνητικές εργασίες και άλλα. Αυτή η εκτεταμένη εκπαίδευση επιτρέπει στα LLM να αναπτύξουν βαθιά κατανόηση της γλώσσας.
Σκεφτείτε ένα LLM σαν έναν υπερ-μαθητή που διαβάζει δισεκατομμύρια προτάσεις για να κατανοήσει τη γλώσσα όπως οι άνθρωποι, μαζί με το πλαίσιο και τις πολιτισμικές νύξεις. Μαθαίνει μόνο του από τεράστιες ποσότητες γραπτού υλικού, χωρίς να χρειάζεται κάποιος να του τα διδάξει ρητά. Αυτή η ικανότητα αυτομάθησης είναι που κάνει τα LLM τόσο χρήσιμα σε διάφορα περιβάλλοντα, όπως η τροφοδότηση chatbot.
Τα LLM είναι εξαιρετικά ευέλικτα και μπορούν να εφαρμοστούν σε οποιοδήποτε έργο αφορά κείμενο. Για παράδειγμα, μπορούν να αναλύσουν τον τόνο ενός άρθρου για να προσδιορίσουν αν είναι θετικός ή αρνητικός. Εμείς χρησιμοποιούμε LLM για να δημιουργήσουμε chatbot που συνομιλούν φυσικά, προσφέροντας πιο διαισθητικές και πιο ανθρώπινες απαντήσεις.
Prompting
Μπορούμε να περιγράψουμε το prompting ως έναν τρόπο επικοινωνίας με ένα LLM. Δίνοντάς του ένα σύνολο οδηγιών, μπορείτε να προσαρμόσετε το LLM στις δικές σας περιπτώσεις χρήσης. Η ποιότητα του prompt είναι καθοριστική, γιατί όσο πιο αποτελεσματική είναι η οδηγία, τόσο καλύτερη είναι η απάντηση. Φανταστείτε ότι ρωτάτε κάτι στο ChatGPT, αλλά η απάντηση που παίρνετε δεν είναι ακριβώς αυτή που ελπίζατε. Μπορεί να αναδιατυπώσετε την ερώτηση, να προσθέσετε περισσότερο πλαίσιο ή να προσδιορίσετε συγκεκριμένες λεπτομέρειες. Αυτή η διαδικασία βελτίωσης της εισόδου σας είναι στην ουσία το prompt engineering.
Fine-tuning
Fine-tuning είναι όταν διδάσκουμε σε ένα προεκπαιδευμένο μοντέλο να αποδίδει καλύτερα σε μια συγκεκριμένη εργασία. Για τα LLM αυτό περιλαμβάνει μια μέθοδο επιβλεπόμενης μάθησης, όπου το μοντέλο εκπαιδεύεται με ένα επισημασμένο σύνολο δεδομένων. Για παράδειγμα, αν κάνετε fine-tuning ενός LLM για ανάλυση συναισθήματος, θα χρησιμοποιούσατε ένα σύνολο δεδομένων όπου κάθε κείμενο είναι σημειωμένο ως «θετικό» ή «αρνητικό». Κατά το fine-tuning, το μοντέλο προσαρμόζει τις εσωτερικές του ρυθμίσεις ώστε να προβλέπει σωστότερα τις ετικέτες. Αυτή η διαδικασία εξατομικεύει το LLM, ενισχύοντας την ακρίβειά του για το δικό σας έργο. Το fine-tuning κάνει το μοντέλο να αποδίδει καλύτερα για τη συγκεκριμένη εφαρμογή απ’ ό,τι στην αρχική του μορφή.
RAG
Τώρα που κατανοείτε τις έννοιες των LLM, του prompting και του fine-tuning, ας μιλήσουμε για τη μέθοδο που επιλέξαμε για την εφαρμογή μας: το RAG.
Με απλά λόγια, το RAG είναι μια τεχνική που σας επιτρέπει να προσθέσετε τα δικά σας δεδομένα σε ένα LLM, ώστε να παράγει πιο ακριβείς και πιο σχετικές απαντήσεις. Η μέθοδος αυτή αντιμετωπίζει δύο μεγάλες προκλήσεις που συναντούν συχνά τα LLM: τις παραισθήσεις και την παρωχημένη πληροφορία.
Οι παραισθήσεις συμβαίνουν όταν ένα LLM παράγει λανθασμένη πληροφορία, συχνά επειδή δεν γνωρίζει την απάντηση αλλά προσπαθεί ούτως ή άλλως να δώσει μία. Η παρωχημένη πληροφορία είναι πρόβλημα επειδή τα LLM εκπαιδεύονται σε δεδομένα που είναι διαθέσιμα μέχρι την ημερομηνία της εκπαίδευσης, οπότε τους λείπει η πιο πρόσφατη πληροφορία.
Καθώς χτίζουμε ένα chatbot, η παροχή επίκαιρης και σωστής πληροφορίας στους χρήστες είναι απαραίτητη. Παρωχημένες ή λανθασμένες απαντήσεις μπορούν να διαβρώσουν την εμπιστοσύνη και να μειώσουν την αποτελεσματικότητα της εφαρμογής.
Με τη χρήση του RAG μπορούμε να περιορίσουμε αυτά τα προβλήματα. Το μοντέλο ανακτά σχετική πληροφορία από ένα συγκεκριμένο, επίκαιρο σύνολο δεδομένων και τη συνδυάζει με τις γλωσσικές του δυνατότητες παραγωγής, εξασφαλίζοντας ότι οι απαντήσεις είναι ταυτόχρονα ακριβείς και επίκαιρες.
Στη συνέχεια θα εξηγήσω λίγο περισσότερα για το πώς λειτουργεί το RAG και ποια βήματα χρειάζονται για την αποτελεσματική υλοποίησή του.
Πώς λειτουργεί το RAG;

Για να κατανοήσουμε πλήρως πώς το RAG επιτρέπει στα LLM να παράγουν πιο ακριβείς και πιο σχετικές με το πλαίσιο απαντήσεις, πρέπει να εξετάσουμε τρία βασικά συστατικά: την εξωτερική τεκμηρίωση, τη διαδικασία ανάκτησης και τη φάση της επαύξησης. Η παραπάνω εικόνα αποτυπώνει αναλυτικά αυτές τις έννοιες.
Εξωτερική τεκμηρίωση
Τα LLM εκπαιδεύονται σε μεγάλα σύνολα δεδομένων, αλλά δεν περιλαμβάνουν εξειδικευμένη ή επίκαιρη πληροφορία πέρα από τα αρχικά δεδομένα εκπαίδευσής τους. Τα εξωτερικά δεδομένα, που μπορεί να έχουν διάφορες μορφές όπως δομημένες βάσεις δεδομένων, αρχεία PDF ή απλά κείμενα, πρέπει να ενσωματωθούν στη βάση γνώσης του μοντέλου. Για να γίνει αυτό, τα εξωτερικά δεδομένα μετατρέπονται σε αριθμητική μορφή και αποθηκεύονται σε διανυσματικές βάσεις δεδομένων, ώστε να είναι προσβάσιμα και ερμηνεύσιμα από το LLM.
Ανάκτηση
Αφού αποθηκεύσουμε τα εξωτερικά μας δεδομένα σε μια διανυσματική βάση δεδομένων, το επόμενο βήμα είναι η διαδικασία ανάκτησης. Τα εξωτερικά μας δεδομένα περιέχουν πολλά διαφορετικά έγγραφα, και στόχος της ανάκτησης είναι να επιστρέψει μόνο τα σημεία που σχετίζονται με το ερώτημα του χρήστη. Στη διαδικασία αυτή, τα πιο σχετικά έγγραφα επιστρέφονται με βάση ένα σκορ συνάφειας, που προκύπτει από το πόσο στενά ταιριάζει το ερώτημα με το περιεχόμενο των εγγράφων.
Για παράδειγμα, αν ένας χρήστης κάνει μια ερώτηση όπως «θέλω να κάνω αλλαγές στον λογαριασμό μου» στο chatbot των συχνών ερωτήσεων, το σύστημα ανάκτησης ψάχνει μέσα στα δεδομένα για να βρει έγγραφα σχετικά με τη διαχείριση λογαριασμού. Επιπλέον, ο αλγόριθμος μπορεί να δώσει προτεραιότητα σε έγγραφα που αφορούν ειδικά τις συνηθισμένες αλλαγές ή διαδικασίες λογαριασμού, ώστε ο χρήστης να λάβει την πιο σχετική και χρήσιμη πληροφορία.
Επαύξηση
Μόλις ανακτηθούν τα σχετικά έγγραφα, το LLM χρησιμοποιεί αυτά τα δεδομένα μαζί με το prompt που του δόθηκε για να παραγάγει μια απάντηση. Σε αυτό το βήμα, το prompt παίζει καθοριστικό ρόλο. Όπως αναφέρθηκε προηγουμένως, ένα καλοφτιαγμένο prompt μπορεί να επηρεάσει σημαντικά το LLM ώστε να παραγάγει μια απάντηση που ανταποκρίνεται στις προσδοκίες σας. Με τον συνδυασμό ακριβών εξωτερικών δεδομένων και ενός προσεκτικά σχεδιασμένου prompt, το RAG εξασφαλίζει ότι το LLM μπορεί να δώσει μια ακριβή και σχετική με το πλαίσιο απάντηση.
Η σημασία της υψηλής ποιότητας τεκμηρίωσης
Η αποτελεσματικότητα του chatbot βοήθειας και υποστήριξής μας στηρίζεται στην ποιότητα και στην οργάνωση των πληροφοριών που δίνουμε στο σύστημα RAG. Επιμελούμενοι και δομώντας προσεκτικά αυτά τα έγγραφα, εξασφαλίζουμε ότι το chatbot μπορεί να δίνει ακριβείς και χρήσιμες απαντήσεις στα ερωτήματα των χρηστών.
Για να μεγιστοποιήσουμε τη χρησιμότητα του chatbot, οργανώσαμε τα δεδομένα σε διακριτές ενότητες. Δεδομένου ότι πρόκειται για chatbot προσαρμοσμένο στην πλατφόρμα της Vesper, είναι απαραίτητο να περιλαμβάνεται ολοκληρωμένη τεκμηρίωση για τις διάφορες λειτουργίες της. Συμπεριλάβαμε τους εξής τύπους εγγράφων:
Πλοήγηση και δομή της πλατφόρμας:
- Σκοπός: να βοηθήσει τους χρήστες να πλοηγούνται εύκολα στην πλατφόρμα της Vesper.
- Περιεχόμενο: αναλυτικές περιγραφές της δομής της πλατφόρμας, όπως η πρόσβαση σε διαφορετικές ενότητες και η χρήση των διαφόρων λειτουργιών. Περιλαμβάνονται επίσης οδηγοί προϊόντος με βήμα προς βήμα οδηγίες για τη χρήση συγκεκριμένων τμημάτων του εργαλείου.
Τεκμηρίωση λειτουργικότητας:
- Σκοπός: να δίνει γρήγορες και ακριβείς απαντήσεις για τις συγκεκριμένες λειτουργίες της πλατφόρμας.
- Περιεχόμενο: πληροφορίες για προηγμένες λειτουργίες όπως η λήψη δεδομένων και οι ενσωματώσεις API.
Εκθέσεις αγοράς και περιφερειακές γνώσεις:
- Σκοπός: να δίνει εικόνα για τους τύπους ανάλυσης που καλύπτουμε στα διάφορα εμπορεύματα.
- Περιεχόμενο: επεξηγήσεις των εκθέσεων για τα διάφορα εμπορεύματα, με τη σημασία και τη χρήση τους μέσα στην πλατφόρμα.
Διαθεσιμότητα δεδομένων:
- Σκοπός: να ενημερώνει τους χρήστες για τις διαθέσιμες σειρές δεδομένων στην πλατφόρμα της Vesper.
- Περιεχόμενο: ένας ολοκληρωμένος κατάλογος των διαθέσιμων δεδομένων στην πλατφόρμα.
Με βάση αυτά τα δεδομένα, τα παρακάτω παραδείγματα δείχνουν πώς το chatbot μπορεί πλέον να υποστηρίξει τους χρήστες μας σε πολύ συγκεκριμένες ερωτήσεις σχετικά με την πλατφόρμα:

Η σημασία της ποιότητας των εξωτερικών δεδομένων
Σε όλη την ανάπτυξη του chatbot συναντήσαμε προκλήσεις σχετικές με την ποιότητα και τη δομή των εγγράφων. Τα καλοοργανωμένα έγγραφα υψηλής ποιότητας είναι καθοριστικά, γιατί επηρεάζουν άμεσα την ικανότητα του chatbot να ανακτά και να παραδίδει ακριβή πληροφορία. Κακοδομημένα ή παρωχημένα έγγραφα μπορούν να οδηγήσουν σε άσχετες ή λανθασμένες απαντήσεις, που θα μείωναν την εμπιστοσύνη των χρηστών στο σύστημα και, στη χειρότερη περίπτωση, θα έκαναν περισσότερο κακό παρά καλό.
Για να το αντιμετωπίσουμε, φροντίσαμε όλα τα έγγραφα να είναι καλά οργανωμένα και να ενημερώνονται τακτικά. Αυτό όχι μόνο βελτιώνει τη διαδικασία ανάκτησης, αλλά εξασφαλίζει και ότι οι χρήστες λαμβάνουν την πιο επίκαιρη και ακριβή πληροφορία. Καθώς συνεχίζουμε να επεκτείνουμε τις δυνατότητες του chatbot, η διατήρηση της ποιότητας και της συνάφειας αυτών των εγγράφων παραμένει βασική προτεραιότητα.
Μελλοντικές εξελίξεις
Το σημερινό μας chatbot λειτουργεί εξαιρετικά και θα βοηθήσει τους χρήστες μας με πολλούς τρόπους, στοχεύουμε όμως σε ακόμη καλύτερη απόδοση. Προσπαθούμε να βελτιώνουμε διαρκώς την υπηρεσία για τους χρήστες μας αναλύοντας τις αλληλεπιδράσεις τους. Έτσι μπορούμε να δούμε τι είδους αιτήματα γίνονται και να κατευθύνουμε ανάλογα τις μελλοντικές μας εξελίξεις. Για παράδειγμα, αν υπάρχουν πολλά ερωτήματα για την τρέχουσα κατάσταση της αγοράς, μπορούμε να εξετάσουμε τρόπους να παρέχουμε καλύτερη πληροφόρηση αγοράς στους χρήστες μας.
Μία από τις μεγαλύτερες προκλήσεις μας στο μέλλον θα είναι να εξασφαλίσουμε ότι το chatbot δίνει με συνέπεια επίκαιρη πληροφορία. Αυτό απαιτεί τακτική ενημέρωση της βάσης γνώσης του με τα πιο πρόσφατα δεδομένα, ιδίως σε πεδία που αλλάζουν γρήγορα. Στόχος μας δεν είναι μόνο να κάνουμε το chatbot να μοιάζει με πραγματικό συνομιλητή, αλλά και να εξασφαλίσουμε ότι παραδίδει πάντα την πιο επίκαιρη και σχετική πληροφορία. Εστιάζοντας σε αυτά, στοχεύουμε να προσφέρουμε έγκαιρη βοήθεια σε ποικίλα θέματα, ώστε οι χρήστες μας να λαμβάνουν ακριβείς και χρήσιμες απαντήσεις.
Ανυπομονούμε να δούμε αυτό το chatbot να εξελίσσεται σε έναν πραγματικά ολοκληρωμένο βοηθό, που δεν θα απαντά μόνο σε ερωτήσεις αλλά θα δίνει και γνώσεις για την αγορά, εξατομικευμένες προτάσεις και ακόμη και βοήθεια σε σύνθετες αποφάσεις.
Ακολουθήστε τις δημοσιεύσεις της Tuğçe Güneş, Machine Learning Engineer στη Vesper, για να μένετε ενημερωμένοι καθώς συνεχίζουμε αυτό το ταξίδι ανάπτυξης!