Jahrelang mussten Einkäufer, Verkäufer, Händler und Analysten im Rohstoffbereich auf fragmentierte Datenquellen zurückgreifen, was es schwer machte, mit Marktveränderungen Schritt zu halten und rechtzeitig zu entscheiden. Ohne einen zentralen Knotenpunkt verlässlicher Informationen verbrachten Fachleute oft Stunden damit, Daten zusammenzusetzen, um informiert zu bleiben und Prognosen zu erstellen.
Heute lösen Commodity-Intelligence-Plattformen wie Vesper dieses Problem mit einer Komplettlösung, die alle wesentlichen Preisdaten, Marktberichte und Prognosen an einem einzigen, leicht zugänglichen Ort zusammenführt.
So hilfreich diese Plattformen auch sind, sie sind zugleich voll mit leistungsfähigen Werkzeugen und Informationen, in denen man sich leicht verliert. Nutzer stehen oft vor Herausforderungen wie der Frage, welches Produkt genau sie brauchen (etwa beim Durchsehen von 33 verschiedenen Mehlsorten), oder dem Verständnis, wie unsere Prognosewerkzeuge zu deuten sind, um Budgetentscheidungen zu stützen.
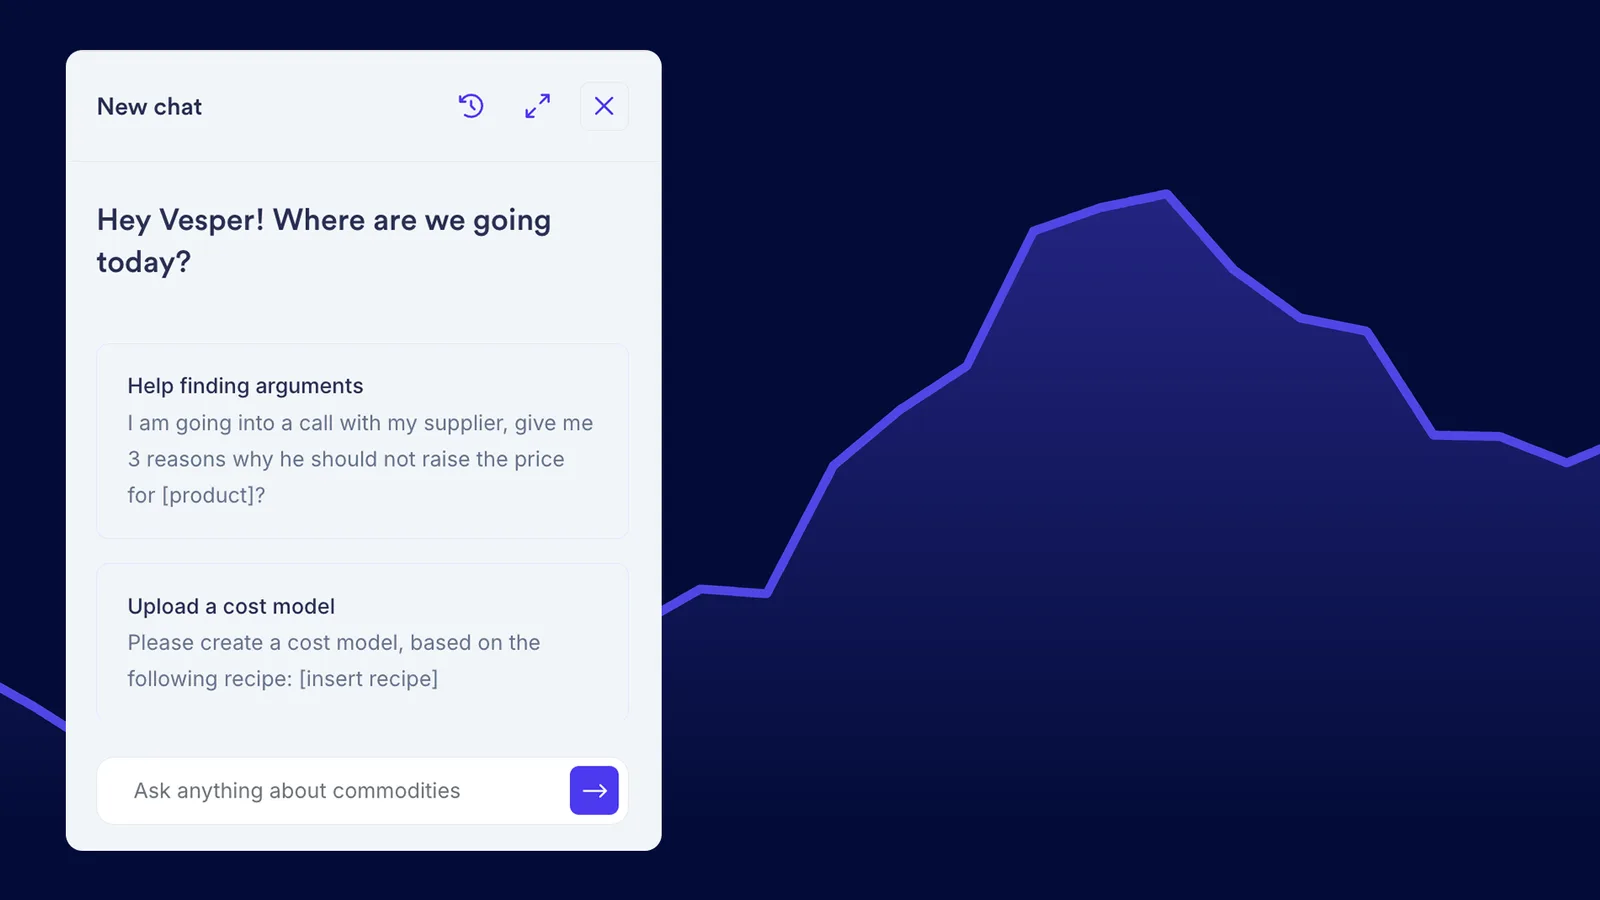
Vespers Mission ist es, die benutzerfreundlichste Commodity-Intelligence-Plattform am Markt zu bleiben und Zugänglichkeit und Bedienkomfort laufend zu verbessern. Als Teil dieses Versprechens haben wir Vesbot eingeführt: einen KI-gestützten Chatbot, der sofort Antworten und Orientierung gibt, ohne den Arbeitsablauf zu unterbrechen. Vesbot basiert auf ChatGPT-Modellen, die eigens auf Vespers Daten und Anwendungsfälle zugeschnitten sind, verbindet Nutzer rasch mit relevanten Erkenntnissen, führt sie durch die Funktionen der Plattform und bietet kontextbezogene Unterstützung bei komplexen Entscheidungen. Vesbot strafft das Nutzererlebnis, indem er die Zeit für die Suche nach Antworten verringert, und bietet rund um die Uhr Unterstützung, sodass Nutzer schneller und fundierter entscheiden und Vespers Möglichkeiten voll ausschöpfen können.
Mit Vesbot können Nutzer nahtlos auf Vespers gesamtes Spektrum an Erkenntnissen und Daten zugreifen, ohne die Reibung, sich durch eine große Plattform zu bewegen oder auf menschliche Unterstützung zu warten, was Rohstoff-Marktintelligenz auf ein neues Niveau an Zugänglichkeit und Effizienz bringt.
In diesem Artikel erfahren Sie, wie der Weg zu Vesbot verlief, einschließlich des technischen Ansatzes, für den wir uns entschieden haben, der Herausforderungen, auf die wir gestoßen sind, und der künftigen Entwicklungen, die wir planen. Am Ende werden Sie besser verstehen, wie Vesbot funktioniert, welche KI-Innovationen ihn antreiben und wie er darauf ausgelegt ist, unseren Nutzern schnellere und klügere Erkenntnisse zu liefern.
Wie sind wir den Bau eines eigenen Chatbots angegangen?
Warum also haben wir dieses Projekt begonnen, und wie sind wir es angegangen? Sicher kennen viele von Ihnen ChatGPT bereits. Dieser Chatbot, der im Kern ein KI-Modell mit einer Benutzeroberfläche ist, ist unglaublich gut darin, Antworten so zu geben, dass sie sich sehr menschlich anfühlen. Fragen zu beantworten, die für Ihren Anwendungsfall spezifisch sind, kann allerdings schwierig sein. Das liegt daran, dass ihm die nötigen Informationen fehlen, um Ihre Frage vollständig zu verstehen. Um das zu können, müsste das Modell mit Daten zu genau diesem Anwendungsfall vertraut sein.
Es gibt mehrere Methoden, einen Chatbot für bestimmte Anwendungsfälle anzupassen. Wir haben verschiedene Optionen geprüft, darunter das Training des Chatbots mit einem vordefinierten Satz von Fragen und Antworten oder den Einsatz regelbasierter Systeme für bestimmte Szenarien. Letztlich haben wir uns für den Ansatz Retrieval-Augmented Generation (RAG) entschieden.
RAG sticht heraus, weil es dem Chatbot ermöglicht, in Echtzeit auf Informationen aus einer riesigen Datenbank zuzugreifen und sie abzurufen, sodass Antworten immer aktuell sind. Dieser Ansatz erlaubt es dem Chatbot, die relevantesten Daten heranzuziehen, um Fragen genau zu beantworten. Zusätzlich verbessert RAG die Fähigkeit des Chatbots, kontextuell passende Antworten zu geben, und gibt uns zugleich die Flexibilität, ihn mit Daten und Erkenntnissen auf Ihre besonderen Anforderungen zuzuschneiden.
Large Language Models und ihre Anpassung
In diesem Kapitel stelle ich einige zentrale technische Konzepte vor, die für das Verständnis von RAG-Systemen grundlegend sind. Wenn Ihnen diese Konzepte bereits vertraut sind, springen Sie gern direkt zum Abschnitt „Wie funktioniert RAG?“.
Large Language Models (LLMs)
LLMs basieren häufig auf Transformer-Architekturen, das heißt, sie nehmen eine Eingabe auf, kodieren sie und dekodieren sie dann, um eine Ausgabe zu erzeugen, genau wie andere transformerbasierte Modelle. Der wesentliche Unterschied zwischen LLMs und gewöhnlichen Transformern liegt in ihrem Training auf extrem großen Datensätzen, darunter Quellen wie Websites, Bücher, Forschungsarbeiten und mehr. Dieses umfangreiche Training erlaubt es LLMs, ein tiefes Sprachverständnis zu entwickeln.
Stellen Sie sich ein LLM als einen Superlerner vor, der Milliarden von Sätzen liest, um Sprache auf dieselbe Weise zu verstehen wie Menschen, einschließlich Kontext und kultureller Andeutungen. Es lernt von selbst aus riesigen Mengen an geschriebenem Material, ohne dass es jemand ausdrücklich unterrichten müsste. Diese Fähigkeit zum Selbstlernen macht LLMs in ganz unterschiedlichen Zusammenhängen so nützlich, etwa als Antrieb für Chatbots.
LLMs sind unglaublich vielseitig und lassen sich auf jedes Projekt anwenden, in dem Text vorkommt. Sie können zum Beispiel den Ton eines Nachrichtenartikels analysieren, um zu bestimmen, ob er positiv oder negativ ist. Wir nutzen LLMs, um Chatbots zu bauen, die natürlich plaudern können und im Gespräch intuitivere, menschlichere Antworten geben.
Prompting
Prompting lässt sich als eine Art beschreiben, mit einem LLM zu kommunizieren. Indem Sie ihm eine Reihe von Anweisungen geben, können Sie das LLM auf Ihre konkreten Anwendungsfälle zuschneiden. Die Qualität des Prompts ist entscheidend, denn je wirksamer die Anweisung, desto besser die Antwort, die Sie erhalten. Stellen Sie sich vor, Sie stellen ChatGPT eine Frage, aber die Antwort ist nicht ganz das, was Sie sich erhofft hatten. Vielleicht formulieren Sie die Frage um, geben mehr Kontext oder nennen bestimmte Details. Dieses Verfeinern Ihrer Eingabe ist im Kern Prompt Engineering.
Fine-tuning
Fine-Tuning bedeutet, dass wir einem vortrainierten Modell beibringen, eine bestimmte Aufgabe besser zu erfüllen. Bei LLMs geschieht das mit einem überwachten Lernverfahren, bei dem das Modell mit einem gelabelten Datensatz trainiert wird. Wenn Sie zum Beispiel ein LLM für die Stimmungsanalyse feinabstimmen, würden Sie einen Datensatz verwenden, in dem jeder Text als „positiv“ oder „negativ“ markiert ist. Beim Fine-Tuning passt das Modell seine internen Einstellungen an, um die Labels zuverlässiger vorherzusagen. Dieser Vorgang individualisiert das LLM und erhöht seine Genauigkeit für Ihr konkretes Projekt. Durch Fine-Tuning schneidet das Modell bei Ihrer speziellen Anwendung besser ab, als es in seiner ursprünglichen Form täte.
RAG
Jetzt, da Sie die Konzepte LLMs, Prompting und Fine-Tuning verstehen, sprechen wir über die Methode, die wir für unsere Anwendung gewählt haben: RAG.
Einfach gesagt ist RAG eine Technik, mit der Sie einem LLM eigene Daten hinzufügen können, damit es genauere und relevantere Antworten erzeugt. Diese Methode adressiert zwei große Herausforderungen, mit denen LLMs häufig konfrontiert sind: Halluzinationen und veraltete Informationen.
Halluzinationen treten auf, wenn ein LLM falsche Informationen erzeugt, oft weil es die Antwort nicht kennt, aber trotzdem eine liefern will. Veraltete Informationen sind ein Problem, da LLMs auf Daten trainiert werden, die bis zum Zeitpunkt des Trainings verfügbar sind, und ihnen damit die aktuellsten Informationen fehlen.
Da wir einen Chatbot bauen, ist es unerlässlich, Nutzern aktuelle und korrekte Informationen zu geben. Veraltete oder falsche Antworten können Vertrauen untergraben und die Wirksamkeit der Anwendung mindern.
Mit RAG können wir diese Probleme abmildern. Das Modell ruft relevante Informationen aus einem bestimmten, aktuellen Datensatz ab und kombiniert sie mit seinen Fähigkeiten zur Sprachgenerierung, sodass die Antworten sowohl genau als auch aktuell sind.
Als Nächstes erkläre ich etwas genauer, wie RAG funktioniert und welche Schritte für eine wirksame Umsetzung nötig sind.
Wie funktioniert RAG?

Um vollständig zu erfassen, wie RAG es LLMs ermöglicht, genauere und kontextuell relevantere Antworten zu erzeugen, müssen wir drei wesentliche Bestandteile betrachten: die externe Dokumentation, den Retrieval-Prozess und die Augmentationsphase. Die Abbildung oben veranschaulicht diese Konzepte im Detail.
Externe Dokumentation
LLMs werden auf großen Datensätzen trainiert, enthalten aber keine spezifischen oder aktuellen Informationen jenseits ihrer ursprünglichen Trainingsdaten. Externe Daten, die in verschiedenen Formaten vorliegen können, etwa als strukturierte Datenbanken, PDFs oder reine Textdokumente, müssen in die Wissensbasis des Modells aufgenommen werden. Dazu werden externe Daten in ein numerisches Format umgewandelt und in Vektordatenbanken gespeichert, sodass das LLM auf sie zugreifen und sie interpretieren kann.
Retrieval
Sobald wir unsere externen Daten in einer Vektordatenbank gespeichert haben, ist der nächste Schritt der Retrieval-Prozess. Unsere externen Daten enthalten viele verschiedene Dokumente, und das Ziel des Retrievals ist es, aus diesen Dokumenten nur die Teile zurückzugeben, die mit der Anfrage des Nutzers zusammenhängen. Dabei werden die relevantesten Dokumente anhand eines Relevanzwerts zurückgegeben, der darauf beruht, wie genau die Anfrage zum Inhalt der Dokumente passt.
Stellt ein Nutzer dem FAQ-Chatbot zum Beispiel eine Frage wie „Ich möchte Änderungen an meinem Konto vornehmen“, durchsucht das Retrieval-System die Daten nach Dokumenten zur Kontoverwaltung. Zusätzlich kann der Algorithmus Dokumente bevorzugen, die gezielt häufige Kontoänderungen oder Abläufe behandeln, damit der Nutzer die relevantesten und hilfreichsten Informationen erhält.
Augmentation
Sobald die relevanten Dokumente abgerufen sind, nutzt das LLM diese Daten zusammen mit dem jeweiligen Prompt, um eine Antwort zu erzeugen. In diesem Schritt spielt der Prompt eine entscheidende Rolle. Wie zuvor erwähnt, kann ein gut gestalteter Prompt das LLM erheblich dazu bewegen, eine Antwort zu erzeugen, die Ihren Erwartungen entspricht. Durch die Kombination aus genauen externen Daten und einem sorgfältig entworfenen Prompt stellt RAG sicher, dass das LLM eine präzise und kontextuell relevante Antwort geben kann.
Die Bedeutung hochwertiger Dokumentation
Die Wirksamkeit unseres Hilfe- und Support-Chatbots wurzelt in der Qualität und Organisation der Informationen, die wir dem RAG-System bereitstellen. Indem wir diese Dokumente sorgfältig kuratieren und strukturieren, stellen wir sicher, dass der Chatbot präzise und hilfreiche Antworten auf Nutzeranfragen geben kann.
Um den Nutzen des Chatbots zu maximieren, haben wir die Daten in klar getrennte Abschnitte gegliedert. Da es sich um einen Chatbot handelt, der auf die Vesper-Plattform zugeschnitten ist, ist es unerlässlich, umfassende Dokumentation zu den verschiedenen Funktionen und Features der Plattform aufzunehmen. Wir haben die folgenden Arten von Dokumenten einbezogen:
Navigation und Struktur der Plattform:
- Zweck: Nutzer dabei unterstützen, sich mühelos auf der Vesper-Plattform zurechtzufinden.
- Inhalt: Detaillierte Beschreibungen der Struktur der Plattform, einschließlich des Zugangs zu verschiedenen Bereichen und der Nutzung verschiedener Funktionen. Dazu gehören auch Produktleitfäden mit Schritt-für-Schritt-Anleitungen für die Nutzung bestimmter Teile des Tools.
Dokumentation der Funktionalität:
- Zweck: Schnelle und genaue Antworten zu den konkreten Funktionalitäten der Plattform geben.
- Inhalt: Informationen zu fortgeschrittenen Funktionen wie Datendownload und API-Integrationen.
Marktberichte und regionale Erkenntnisse:
- Zweck: Erkenntnisse dazu geben, welche Arten von Analysen wir über verschiedene Rohstoffe hinweg abdecken.
- Inhalt: Erläuterungen zu Berichten über verschiedene Rohstoffe, mit ihrer Relevanz und Verwendung innerhalb der Plattform.
Datenverfügbarkeit:
- Zweck: Nutzer über die verfügbaren Datenreihen auf der Vesper-Plattform informieren.
- Inhalt: Eine umfassende Liste der auf der Plattform verfügbaren Daten.
Anhand dieser Daten zeigen die folgenden Beispiele, wie der Chatbot unsere Nutzer nun bei sehr spezifischen Fragen rund um die Plattform unterstützen kann:

Die Bedeutung der Qualität externer Daten
Während der gesamten Entwicklung des Chatbots sind wir auf Herausforderungen gestoßen, die mit der Qualität und Struktur der Dokumente zusammenhängen. Hochwertige, gut organisierte Dokumente sind entscheidend, weil sie sich unmittelbar darauf auswirken, wie gut der Chatbot genaue Informationen abrufen und liefern kann. Schlecht strukturierte oder veraltete Dokumente können zu irrelevanten oder falschen Antworten führen, was das Vertrauen der Nutzer in das System mindern und im schlimmsten Fall mehr schaden als nützen könnte.
Um dem zu begegnen, haben wir dafür gesorgt, dass alle Dokumente gut organisiert und regelmäßig aktualisiert sind. Das verbessert nicht nur den Retrieval-Prozess, sondern stellt auch sicher, dass Nutzer die aktuellsten und genauesten Informationen erhalten, die möglich sind. Während wir die Fähigkeiten des Chatbots weiter ausbauen, bleibt es oberste Priorität, die Qualität und Relevanz dieser Dokumente zu erhalten.
Künftige Entwicklungen
Unser aktueller Chatbot funktioniert hervorragend und wird unseren Nutzern auf vielfältige Weise helfen, aber wir streben eine noch bessere Leistung an. Wir bemühen uns, den Service für unsere Nutzer laufend zu verbessern, indem wir ihre Interaktionen auswerten. So sehen wir, welche Arten von Anfragen gestellt werden, und können unsere künftigen Entwicklungen danach ausrichten. Wenn es zum Beispiel viele Anfragen zur aktuellen Marktlage gibt, können wir Wege prüfen, unseren Nutzern Marktinformationen besser bereitzustellen.
Eine unserer größten Herausforderungen auf dem weiteren Weg wird sein, dafür zu sorgen, dass der Chatbot durchgängig aktuelle Informationen liefert. Dazu muss seine Wissensbasis regelmäßig mit den neuesten Daten aktualisiert werden, besonders in sich schnell verändernden Feldern. Unser Ziel ist es, den Chatbot nicht nur wie einen echten Gesprächspartner wirken zu lassen, sondern auch sicherzustellen, dass er stets die aktuellsten und relevantesten Informationen liefert. Indem wir uns auf diese Aspekte konzentrieren, wollen wir zu verschiedenen Themen zeitnah Unterstützung bieten, damit unsere Nutzer genaue und hilfreiche Antworten erhalten.
Wir freuen uns darauf, diesen Chatbot zu einem wirklich umfassenden Assistenten heranwachsen zu sehen, der nicht nur Fragen beantwortet, sondern auch Markterkenntnisse liefert, personalisierte Empfehlungen gibt und sogar bei komplexen Entscheidungen hilft.
Folgen Sie den Veröffentlichungen von Tuğçe Güneş, Machine Learning Engineer bei Vesper, um auf dem Laufenden zu bleiben, während wir diesen Entwicklungsweg fortsetzen!