Durante años, los compradores, vendedores, traders y analistas de materias primas tuvieron que apoyarse en fuentes de datos fragmentadas, lo que dificultaba seguir el ritmo de los cambios del mercado y tomar decisiones a tiempo. Sin un centro único de información fiable, los profesionales dedicaban a menudo horas a encajar datos para mantenerse informados y elaborar previsiones.
Hoy, las plataformas de inteligencia de materias primas como Vesper resuelven este problema ofreciendo una solución integral que reúne todos los datos de precios esenciales, los informes de mercado y las previsiones en un único lugar de fácil acceso.
Aun así, por útiles que sean estas plataformas, también están repletas de herramientas e información potentes, lo que puede resultar abrumador a la hora de navegar. Los usuarios se enfrentan a menudo a retos como determinar el producto exacto que necesitan (p. ej., navegar por 33 tipos distintos de harina) o entender cómo interpretar nuestras herramientas de previsión para apoyar sus decisiones presupuestarias.
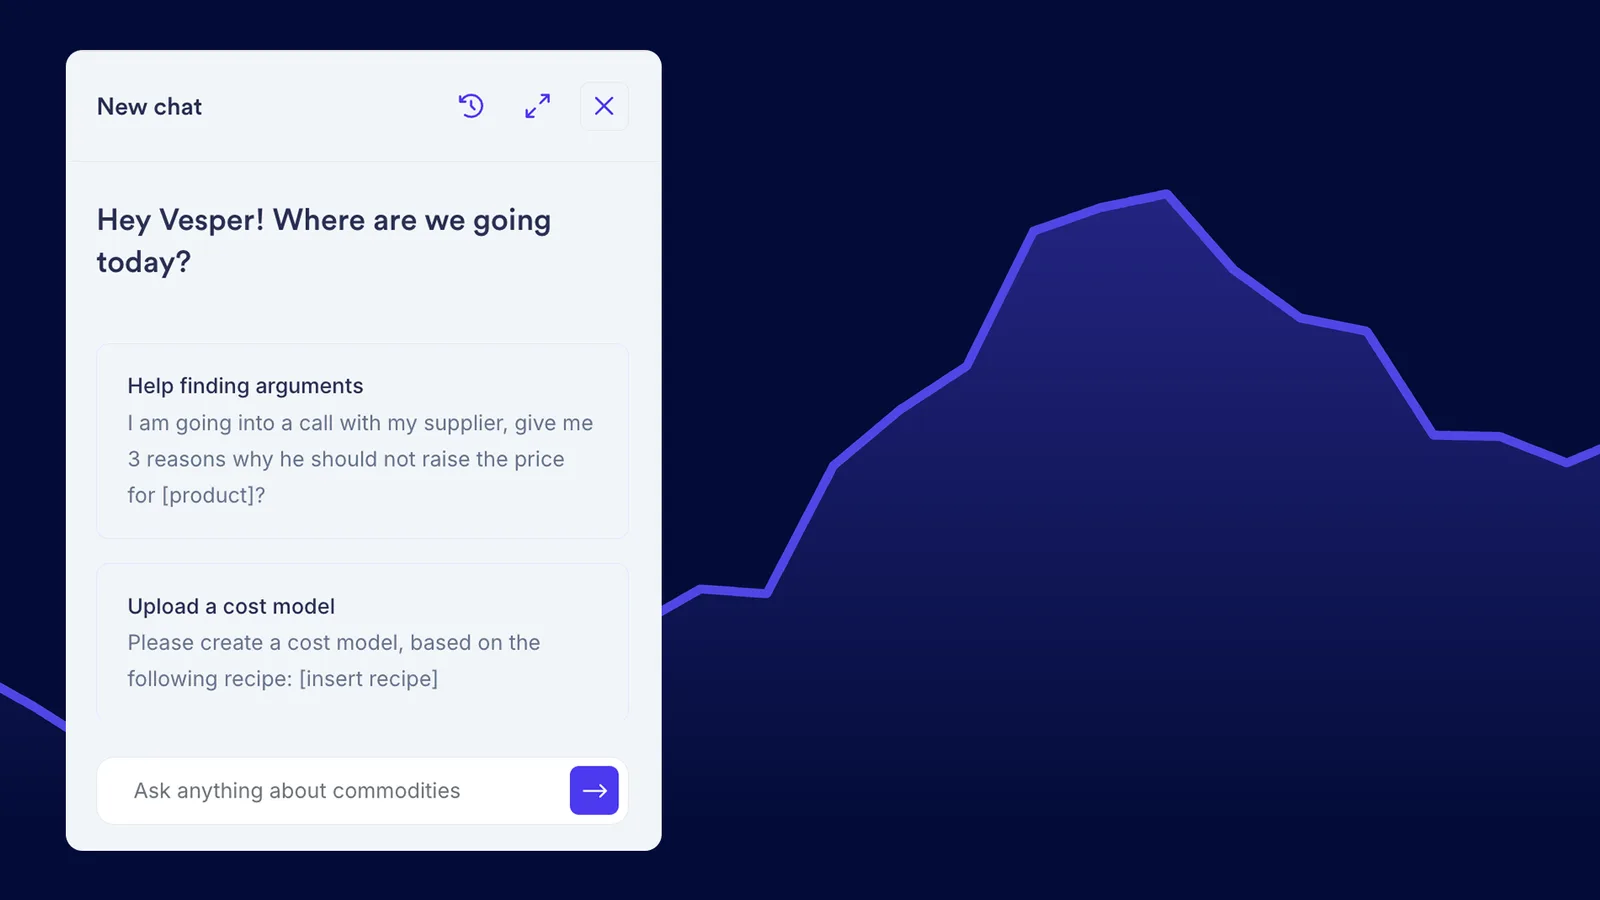
La misión de Vesper es seguir siendo la plataforma de inteligencia de materias primas más fácil de usar del mercado, mejorando continuamente la accesibilidad y la facilidad de uso. Como parte de este compromiso, hemos presentado Vesbot: un chatbot impulsado por IA que ofrece respuestas y orientación al instante sin interrumpir el flujo de trabajo. Construido con modelos de ChatGPT adaptados específicamente a los datos y los casos de uso de Vesper, Vesbot conecta rápidamente a los usuarios con el análisis pertinente, los guía a través de las funciones de la plataforma y ofrece asistencia contextual para decisiones complejas. Vesbot agiliza la experiencia de usuario al reducir el tiempo dedicado a buscar respuestas y presta soporte las 24 horas, lo que permite a los usuarios tomar decisiones más rápidas y mejor fundadas y aprovechar al máximo las capacidades de Vesper.
Con Vesbot, los usuarios pueden acceder con fluidez a toda la gama de análisis y datos de Vesper sin la fricción de navegar por una plataforma grande ni esperar a que les atienda una persona, lo que lleva la inteligencia de materias primas a nuevos niveles de accesibilidad y eficiencia.
En este artículo descubrirá el recorrido que hay detrás de la construcción de Vesbot, incluido el enfoque técnico que elegimos, los retos que encontramos y los desarrollos futuros que estamos planeando. Al final entenderá mejor cómo funciona Vesbot, las innovaciones de IA que lo impulsan y cómo está diseñado para ofrecer a nuestros usuarios análisis más rápidos e inteligentes.
Cómo abordamos la construcción de un chatbot a medida
Entonces, ¿por qué empezamos este proyecto y cómo lo abordamos? Seguro que muchos de ustedes ya conocen ChatGPT. Este chatbot, que es esencialmente un modelo de IA unido a una interfaz de usuario, resulta increíble a la hora de dar respuestas de una forma que se siente muy humana. Sin embargo, responder a preguntas específicas de su caso de uso puede ser complicado. Esto se debe a que le falta la información necesaria para entender del todo su pregunta. Para lograr esa capacidad, el modelo tendría que estar familiarizado con los datos relacionados con ese caso de uso concreto.
Existen varios métodos para personalizar un chatbot y que atienda casos de uso específicos. Exploramos distintas opciones, entre ellas entrenar el chatbot con un conjunto predefinido de preguntas y respuestas o utilizar sistemas basados en reglas para escenarios concretos. Finalmente seleccionamos el enfoque Retrieval-Augmented Generation (RAG).
RAG destaca porque permite al chatbot acceder a información de una base de datos enorme y recuperarla en tiempo real, lo que garantiza que las respuestas estén siempre actualizadas. Este enfoque permite al chatbot extraer los datos más pertinentes para responder con precisión. Además, RAG mejora la capacidad del chatbot de dar respuestas contextualmente apropiadas y nos da la flexibilidad de adaptarlo con datos y análisis específicos de sus necesidades particulares.
Los modelos de lenguaje de gran tamaño y su adaptación
En este capítulo presentaré algunos conceptos técnicos clave que son fundamentales para entender los sistemas RAG. Si ya conoce estos conceptos, puede saltar directamente a la sección «¿Cómo funciona RAG?».
Modelos de lenguaje de gran tamaño (LLM)
Los LLM suelen basarse en arquitecturas transformer, es decir, toman una entrada, la codifican y luego la decodifican para generar una salida, igual que otros modelos basados en transformers. La diferencia clave entre los LLM y los transformers corrientes es su entrenamiento con conjuntos de datos extremadamente grandes, que incluyen fuentes como páginas web, libros, artículos de investigación y más. Este entrenamiento tan extenso permite a los LLM desarrollar una comprensión profunda del lenguaje.
Piense en un LLM como en un superaprendiz que lee miles de millones de frases para entender el lenguaje del mismo modo que lo hacen las personas, incluidos el contexto y los matices culturales. Aprende por sí solo a partir de cantidades enormes de material escrito sin que nadie tenga que enseñárselo de forma explícita. Esta capacidad de autoaprendizaje es lo que hace a los LLM tan útiles en contextos muy diversos, como el de dar vida a chatbots.
Los LLM son increíblemente versátiles y pueden aplicarse a cualquier proyecto que implique texto. Por ejemplo, pueden analizar el tono de un artículo de noticias para determinar si es positivo o negativo. Nosotros usamos LLM para crear chatbots capaces de conversar con naturalidad, que ofrecen respuestas más intuitivas y humanas en las conversaciones.
Prompting
Podemos describir el prompting como una forma de comunicarse con un LLM. Dándole un conjunto de instrucciones, puede adaptar el LLM a sus casos de uso concretos. La calidad del prompt es crucial, porque cuanto más eficaz sea la instrucción, mejor será la respuesta que obtenga. Imagine que le hace una pregunta a ChatGPT, pero la respuesta que recibe no es del todo la que esperaba. Puede que reformule la pregunta, añada más contexto o precise ciertos detalles. Ese proceso de refinar lo que introduce es, en esencia, ingeniería de prompts.
Ajuste fino
El ajuste fino consiste en enseñar a un modelo preentrenado a rendir mejor en una tarea concreta. En el caso de los LLM, esto implica usar un método de aprendizaje supervisado, en el que el modelo se entrena con un conjunto de datos etiquetado. Por ejemplo, si está ajustando un LLM para análisis de sentimiento, usaría un conjunto de datos en el que cada texto esté marcado como «positivo» o «negativo». Durante el ajuste fino, el modelo reajusta sus parámetros internos para mejorar en la predicción correcta de las etiquetas. Este proceso personaliza el LLM y mejora su precisión para su proyecto concreto. El ajuste fino hace que el modelo rinda mejor en su aplicación particular de lo que lo haría en su forma original.
RAG
Ahora que entiende los conceptos de LLM, prompting y ajuste fino, hablemos del método que hemos elegido para nuestra aplicación: RAG.
En pocas palabras, RAG es una técnica que permite añadir sus propios datos a un LLM para que genere respuestas más precisas y pertinentes. Este método aborda dos grandes retos a los que se enfrentan habitualmente los LLM: las alucinaciones y la información desactualizada.
Las alucinaciones se producen cuando un LLM genera información incorrecta, a menudo porque no sabe la respuesta pero intenta dar una de todos modos. La información desactualizada es un problema porque los LLM se entrenan con datos disponibles hasta la fecha de entrenamiento y, por lo tanto, carecen de la información más reciente.
Dado que estamos construyendo un chatbot, ofrecer a los usuarios información actual y correcta es esencial. Las respuestas desactualizadas o incorrectas pueden erosionar la confianza y reducir la eficacia de la aplicación.
Con RAG podemos mitigar estos problemas. El modelo recupera información pertinente de un conjunto de datos específico y actualizado y la combina con sus capacidades de generación de lenguaje, lo que garantiza que las respuestas sean a la vez precisas y actuales.
A continuación explicaré un poco más cómo funciona RAG y los pasos necesarios para implementarlo con eficacia.
¿Cómo funciona RAG?

Para entender del todo cómo RAG permite a los LLM producir respuestas más precisas y contextualmente pertinentes, necesitamos explorar tres componentes esenciales: la documentación externa, el proceso de recuperación y la fase de aumento. La imagen anterior ilustra estos conceptos en detalle.
Documentación externa
Los LLM se entrenan con grandes conjuntos de datos, pero no incluyen información específica ni actualizada más allá de sus datos de entrenamiento originales. Los datos externos, que pueden presentarse en formatos muy diversos como bases de datos estructuradas, PDF o documentos de texto plano, deben incorporarse a la base de conocimiento del modelo. Para ello, los datos externos se convierten a un formato numérico y se almacenan en bases de datos vectoriales, lo que los hace accesibles e interpretables para el LLM.
Recuperación
Una vez almacenados nuestros datos externos en una base de datos vectorial, el siguiente paso es el proceso de recuperación. Nuestros datos externos contienen muchos documentos distintos, y el objetivo de la recuperación es devolver solo las partes de esos documentos relacionadas con la consulta del usuario. En este proceso, los documentos más pertinentes se devuelven mediante una puntuación de relevancia, que se basa en hasta qué punto la consulta coincide con el contenido de los documentos.
Por ejemplo, si un usuario le hace al chatbot de preguntas frecuentes una pregunta como «quiero hacer cambios en mi cuenta», el sistema de recuperación busca en los datos documentos relacionados con la gestión de cuentas. Además, el algoritmo puede priorizar documentos que aborden específicamente los cambios o procedimientos de cuenta más habituales, de modo que el usuario obtenga la información más pertinente y útil.
Aumento
Una vez recuperados los documentos pertinentes, el LLM usa esos datos junto con el prompt que se le haya dado para generar una respuesta. En este paso, el prompt desempeña un papel crucial. Como se ha mencionado antes, un prompt bien elaborado puede influir notablemente en que el LLM produzca una respuesta acorde con sus expectativas. Con la combinación de datos externos precisos y un prompt cuidadosamente diseñado, RAG garantiza que el LLM pueda ofrecer una respuesta precisa y contextualmente pertinente.
La importancia de una documentación de calidad
La eficacia de nuestro chatbot de ayuda y soporte se asienta en la calidad y la organización de la información que aportamos al sistema RAG. Al seleccionar y estructurar con cuidado estos documentos, nos aseguramos de que el chatbot pueda ofrecer respuestas precisas y útiles a las consultas de los usuarios.
Para maximizar la utilidad del chatbot, hemos organizado los datos en secciones diferenciadas. Dado que se trata de un chatbot pensado para la plataforma de Vesper, es esencial incluir documentación completa sobre las distintas funciones y funcionalidades de la plataforma. Hemos incluido los siguientes tipos de documentos:
Navegación y estructura de la plataforma:
- Objetivo: ayudar a los usuarios a moverse por la plataforma de Vesper con facilidad.
- Contenido: descripciones detalladas de la estructura de la plataforma, incluido cómo acceder a las distintas secciones y utilizar las diversas funciones. También incluye guías de producto con instrucciones paso a paso para usar partes concretas de la herramienta.
Documentación de funcionalidades:
- Objetivo: dar respuestas rápidas y precisas sobre las funcionalidades específicas de la plataforma.
- Contenido: información sobre funciones avanzadas como la descarga de datos y las integraciones por API.
Informes de mercado y análisis regionales:
- Objetivo: explicar qué tipos de análisis cubrimos en las distintas materias primas.
- Contenido: explicaciones de los informes sobre las distintas materias primas, con su pertinencia y su uso dentro de la plataforma.
Disponibilidad de datos:
- Objetivo: informar a los usuarios sobre las series de datos disponibles en la plataforma de Vesper.
- Contenido: una lista completa de los datos disponibles en la plataforma.
Con estos datos, los siguientes ejemplos muestran cómo el chatbot ya es capaz de ayudar a nuestros usuarios con preguntas muy específicas sobre la plataforma:

La importancia de la calidad de los datos externos
A lo largo del desarrollo del chatbot nos encontramos con retos relacionados con la calidad y la estructura de los documentos. Los documentos de alta calidad y bien organizados son cruciales porque influyen directamente en la capacidad del chatbot de recuperar y entregar información precisa. Los documentos mal estructurados o desactualizados pueden dar lugar a respuestas irrelevantes o incorrectas, lo que podría reducir la confianza del usuario en el sistema y, en el peor de los casos, hacer más mal que bien.
Para abordarlo, nos aseguramos de que todos los documentos estuvieran bien organizados y se actualizaran con regularidad. Esto no solo mejora el proceso de recuperación, sino que también garantiza que los usuarios reciban la información más actual y precisa posible. A medida que sigamos ampliando las capacidades del chatbot, mantener la calidad y la pertinencia de estos documentos seguirá siendo una prioridad máxima.
Desarrollos futuros
Nuestro chatbot actual funciona muy bien y ayudará a nuestros usuarios de muchas maneras, pero aspiramos a un rendimiento aún mejor. Nos esforzamos por mejorar continuamente el servicio para nuestros usuarios analizando sus interacciones. Así podemos ver qué tipos de peticiones se hacen y orientar nuestros desarrollos futuros en consecuencia. Por ejemplo, si hay muchas consultas sobre la situación actual del mercado, podemos explorar formas de ofrecer mejor información de mercado a nuestros usuarios.
Uno de nuestros mayores retos de aquí en adelante será garantizar que el chatbot ofrezca información actualizada de forma constante. Esto exige actualizar con regularidad su base de conocimiento con los datos más recientes, sobre todo en ámbitos que cambian rápido. Nuestro objetivo no es solo que el chatbot se sienta como un interlocutor real, sino también asegurar que siempre entregue la información más actual y pertinente. Centrándonos en estos aspectos, aspiramos a ofrecer ayuda oportuna sobre temas muy diversos, de modo que nuestros usuarios reciban respuestas precisas y útiles.
Nos entusiasma ver cómo este chatbot crece hasta convertirse en un asistente verdaderamente completo que no solo responde preguntas, sino que también ofrece análisis de mercado, recomendaciones personalizadas e incluso ayuda en la toma de decisiones complejas.
¡Siga las publicaciones de Tuğçe Güneş, Machine Learning Engineer en Vesper, para estar al día a medida que continuamos este recorrido de desarrollo!