Durante anos, compradores, vendedores, traders e analistas de commodities tiveram de se apoiar em fontes de dados fragmentadas, o que dificultava acompanhar as mudanças de mercado e decidir na hora certa. Sem um ponto central de informação confiável, os profissionais muitas vezes passavam horas juntando dados para se manter informados e fazer previsões.
Hoje, plataformas de inteligência em commodities como a Vesper resolvem esse problema ao oferecer uma solução única, reunindo todos os dados essenciais de preço, relatórios de mercado e previsões em um só lugar, de acesso fácil.
Ainda assim, por mais úteis que sejam, essas plataformas também são cheias de ferramentas e informações poderosas, o que pode tornar a navegação avassaladora. Os usuários enfrentam desafios como determinar exatamente qual produto precisam (por exemplo, navegar por 33 tipos diferentes de farinha) ou entender como interpretar as nossas ferramentas de previsão para apoiar decisões de orçamento.
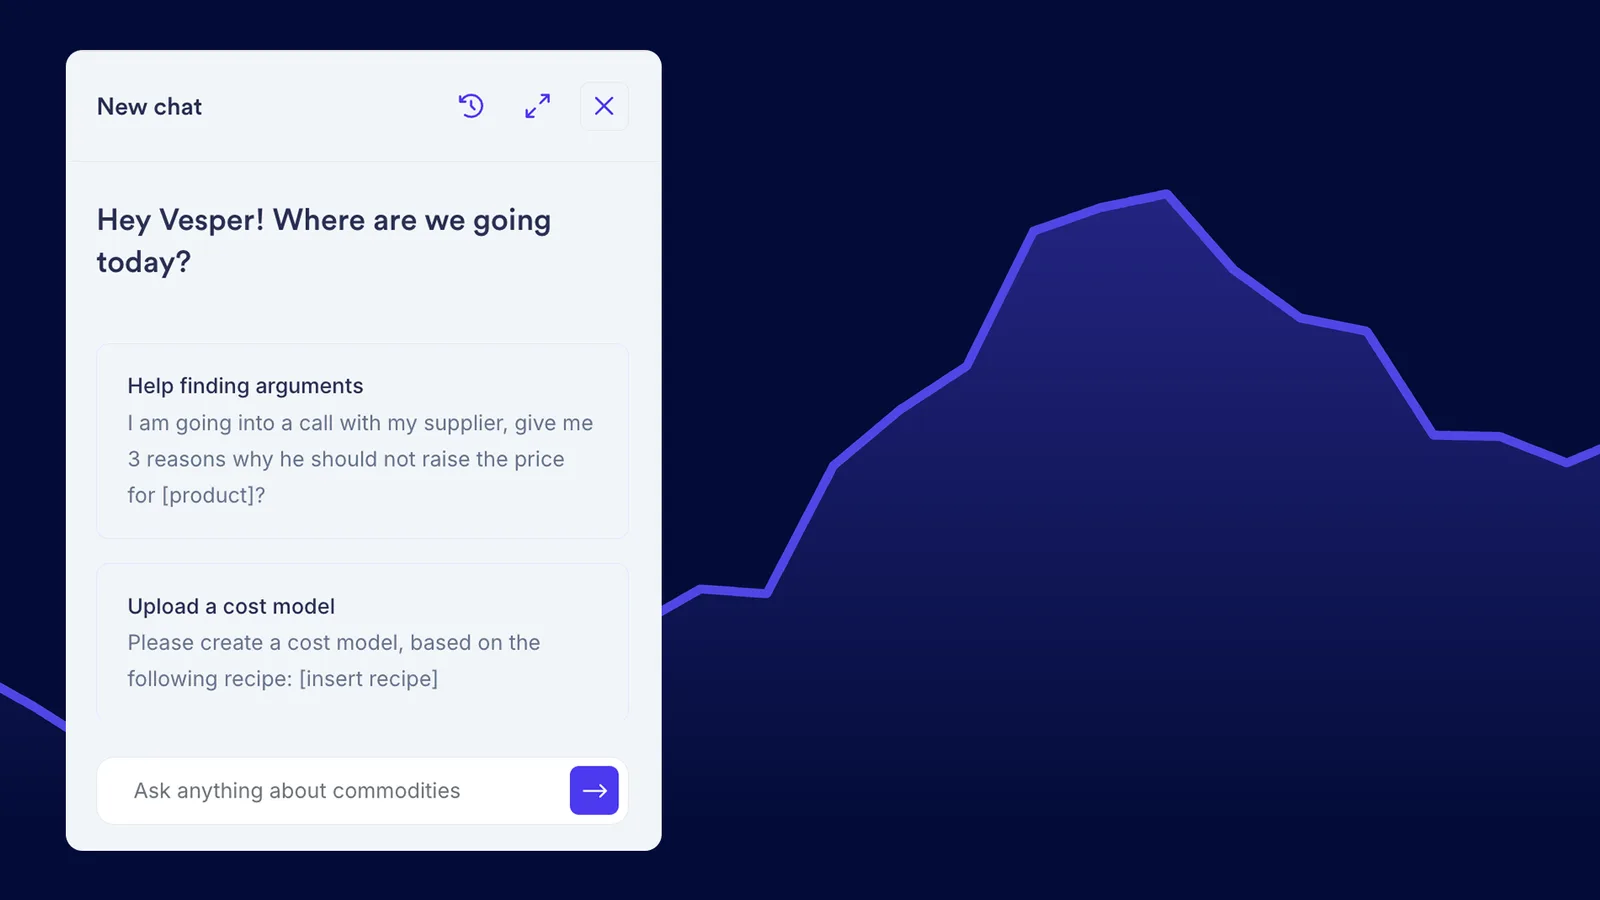
A missão da Vesper é continuar sendo a plataforma de inteligência em commodities mais fácil de usar do mercado, aprimorando sempre a acessibilidade e a facilidade de uso. Como parte desse compromisso, lançamos o Vesbot: um chatbot movido a IA que dá respostas e orientação instantâneas sem interromper o fluxo de trabalho. Construído com modelos ChatGPT ajustados especificamente aos dados e aos casos de uso da Vesper, o Vesbot conecta rapidamente os usuários às leituras relevantes, guia-os pelos recursos da plataforma e oferece ajuda contextual para decisões complexas. O Vesbot simplifica a experiência do usuário ao reduzir o tempo gasto procurando respostas e oferece suporte ininterrupto, o que permite decidir mais rápido, com mais informação, e aproveitar plenamente o que a Vesper oferece.
Com o Vesbot, os usuários acessam de forma fluida toda a gama de leituras e dados da Vesper, sem a fricção de navegar por uma plataforma grande ou de esperar por atendimento humano, o que leva a inteligência em commodities a novos níveis de acessibilidade e eficiência.
Neste artigo, você vai conhecer a jornada por trás da construção do Vesbot, incluindo a abordagem técnica que escolhemos, os desafios que encontramos e os desenvolvimentos futuros que estamos planejando. No fim, você vai entender melhor como o Vesbot funciona, quais inovações de IA o movem e como ele foi desenhado para entregar leituras mais rápidas e mais inteligentes aos nossos usuários.
Como encaramos a construção de um chatbot próprio?
Então, por que começamos este projeto e como o enfrentamos? Tenho certeza de que muitos de vocês já conhecem o ChatGPT. Esse chatbot, que é essencialmente um modelo de IA somado a uma interface de usuário, é incrível em dar respostas de um jeito que soa muito humano. Mas responder a perguntas específicas do seu caso de uso pode ser difícil, porque falta a ele a informação necessária para entender a sua pergunta por completo. Para ter essa capacidade, o modelo precisaria conhecer dados relacionados àquele caso de uso específico.
Existem vários métodos para customizar um chatbot para casos de uso específicos. Exploramos diferentes opções, como treinar o chatbot com um conjunto predefinido de perguntas e respostas ou usar sistemas baseados em regras para cenários específicos. No fim, escolhemos a abordagem de Retrieval-Augmented Generation (RAG).
O RAG se destaca porque permite que o chatbot acesse e recupere informação de uma base de dados enorme em tempo real, o que garante respostas sempre atualizadas. Essa abordagem permite ao chatbot puxar os dados mais relevantes para responder com precisão. Além disso, o RAG melhora a capacidade do chatbot de dar respostas apropriadas ao contexto e nos dá flexibilidade para ajustá-lo com dados e leituras específicos das suas necessidades.
Modelos de linguagem de grande porte e a sua adaptação
Neste capítulo, vou apresentar alguns conceitos técnicos fundamentais para entender os sistemas RAG. Se você já conhece esses conceitos, pule direto para a seção “Como funciona o RAG?”.
Modelos de linguagem de grande porte (LLMs)
Os LLMs costumam se basear em arquiteturas transformer, ou seja, recebem uma entrada, a codificam e depois a decodificam para gerar uma saída, como os outros modelos baseados em transformer. A diferença principal entre os LLMs e os transformers comuns é o treinamento em conjuntos de dados extremamente grandes, com fontes como sites, livros, artigos de pesquisa e mais. Esse treinamento extenso permite aos LLMs desenvolver um entendimento profundo da linguagem.
Pense em um LLM como um superaprendiz que lê bilhões de frases para entender a linguagem do mesmo jeito que os humanos, incluindo contexto e pistas culturais. Ele aprende sozinho a partir de volumes enormes de material escrito, sem que ninguém precise ensiná-lo explicitamente. É essa capacidade de autoaprendizado que torna os LLMs tão úteis em contextos diversos, como mover chatbots.
Os LLMs são incrivelmente versáteis e podem ser aplicados a qualquer projeto que envolva texto. Por exemplo, podem analisar o tom de uma notícia para determinar se ela é positiva ou negativa. Usamos LLMs para criar chatbots que conversam com naturalidade, com respostas mais intuitivas e humanas.
Prompting
Podemos descrever o prompting como uma forma de se comunicar com um LLM. Ao dar a ele um conjunto de instruções, você ajusta o LLM aos seus casos de uso específicos. A qualidade do prompt é crucial, porque quanto mais eficaz a instrução, melhor a resposta. Imagine que você faz uma pergunta ao ChatGPT, mas a resposta não é bem o que você esperava. Você pode reformular a pergunta, acrescentar contexto ou especificar certos detalhes. Esse processo de refinar a sua entrada é, em essência, engenharia de prompt.
Fine-tuning
Fine-tuning é quando ensinamos um modelo pré-treinado a ter desempenho melhor em uma tarefa específica. No caso dos LLMs, isso envolve um método de aprendizado supervisionado, em que o modelo é treinado com um conjunto de dados rotulado. Por exemplo, se você faz fine-tuning de um LLM para análise de sentimento, usaria um conjunto de dados em que cada texto é marcado como “positivo” ou “negativo”. Durante o fine-tuning, o modelo ajusta as suas configurações internas para melhorar na previsão correta dos rótulos. Esse processo customiza o LLM e aumenta a sua precisão no seu projeto específico. O fine-tuning faz o modelo ter desempenho melhor na sua aplicação específica do que teria na forma original.
RAG
Agora que você entende os conceitos de LLMs, prompting e fine-tuning, vamos falar do método que escolhemos para a nossa aplicação: o RAG.
Em resumo, o RAG é uma técnica que permite adicionar os seus próprios dados a um LLM para que ele gere respostas mais precisas e relevantes. O método endereça dois grandes desafios comuns aos LLMs: alucinações e informação desatualizada.
As alucinações acontecem quando um LLM gera informação incorreta, muitas vezes porque não sabe a resposta mas tenta dar uma mesmo assim. A informação desatualizada é um problema porque os LLMs são treinados com dados disponíveis até a data do treinamento e, portanto, não têm a informação mais recente.
Como estamos construindo um chatbot, entregar aos usuários informação atual e correta é essencial. Respostas desatualizadas ou incorretas podem corroer a confiança e reduzir a eficácia da aplicação.
Com o RAG, conseguimos mitigar esses problemas. O modelo recupera informação relevante de um conjunto de dados específico e atualizado e a combina com a sua capacidade de geração de linguagem, o que garante respostas ao mesmo tempo precisas e atuais.
A seguir, vou explicar um pouco mais sobre como o RAG funciona e quais passos são necessários para implementá-lo de forma eficaz.
Como funciona o RAG?

Para entender por completo como o RAG permite aos LLMs produzir respostas mais precisas e relevantes ao contexto, precisamos explorar três componentes essenciais: a documentação externa, o processo de recuperação e a fase de aumento. A imagem acima ilustra esses conceitos em detalhe.
Documentação externa
Os LLMs são treinados com grandes conjuntos de dados, mas não incluem informação específica ou atualizada além dos dados originais de treinamento. Dados externos, que podem vir em formatos variados como bancos de dados estruturados, PDFs ou documentos de texto simples, precisam ser incorporados à base de conhecimento do modelo. Para isso, os dados externos são convertidos em formato numérico e armazenados em bancos de dados vetoriais, o que os torna acessíveis e interpretáveis pelo LLM.
Recuperação
Depois de armazenar os nossos dados externos em um banco de dados vetorial, o passo seguinte é o processo de recuperação. Os nossos dados externos contêm muitos documentos diferentes, e o objetivo da recuperação é devolver apenas as partes desses documentos relacionadas à consulta do usuário. Nesse processo, os documentos mais relevantes são devolvidos usando uma pontuação de relevância, baseada em quanto a consulta se aproxima do conteúdo dos documentos.
Por exemplo, se um usuário faz ao chatbot de FAQ uma pergunta como “quero fazer alterações na minha conta”, o sistema de recuperação busca nos dados os documentos relacionados a gestão de conta. Além disso, o algoritmo pode priorizar documentos que tratem especificamente das alterações ou dos procedimentos de conta mais comuns, o que garante ao usuário a informação mais relevante e útil.
Aumento
Uma vez recuperados os documentos relevantes, o LLM usa esses dados junto com o prompt fornecido para gerar uma resposta. Nesse passo, o prompt tem um papel crucial. Como dito antes, um prompt bem construído pode influenciar bastante o LLM a produzir uma resposta alinhada às suas expectativas. Com a combinação de dados externos precisos e um prompt cuidadosamente desenhado, o RAG garante que o LLM consiga dar uma resposta precisa e relevante ao contexto.
A importância de uma documentação de alta qualidade
A eficácia do nosso chatbot de ajuda e suporte está enraizada na qualidade e na organização da informação que fornecemos ao sistema RAG. Ao curar e estruturar esses documentos com cuidado, garantimos que o chatbot entregue respostas precisas e úteis às perguntas dos usuários.
Para maximizar a utilidade do chatbot, organizamos os dados em seções distintas. Como este é um chatbot feito sob medida para a plataforma Vesper, é essencial incluir documentação completa sobre os diversos recursos e funções da plataforma. Incluímos os seguintes tipos de documento:
Navegação e estrutura da plataforma:
- Objetivo: ajudar os usuários a navegar pela plataforma Vesper com facilidade.
- Conteúdo: descrições detalhadas da estrutura da plataforma, incluindo como acessar diferentes seções e usar os vários recursos. Isso inclui também guias de produto com instruções passo a passo para usar partes específicas da ferramenta.
Documentação de funcionalidades:
- Objetivo: dar respostas rápidas e precisas sobre as funcionalidades específicas da plataforma.
- Conteúdo: informações sobre recursos avançados, como download de dados e integrações de API.
Relatórios de mercado e leituras regionais:
- Objetivo: mostrar que tipos de análise cobrimos nas diversas commodities.
- Conteúdo: explicações dos relatórios sobre as diversas commodities, com a sua relevância e o seu uso dentro da plataforma.
Disponibilidade de dados:
- Objetivo: informar os usuários sobre as séries de dados disponíveis na plataforma Vesper.
- Conteúdo: uma lista completa dos dados disponíveis na plataforma.
Com esses dados, os exemplos a seguir mostram como o chatbot agora consegue apoiar os nossos usuários em perguntas muito específicas sobre a plataforma:

A importância da qualidade dos dados externos
Ao longo do desenvolvimento do chatbot, encontramos desafios ligados à qualidade e à estrutura dos documentos. Documentos de alta qualidade e bem organizados são cruciais porque afetam diretamente a capacidade do chatbot de recuperar e entregar informação precisa. Documentos mal estruturados ou desatualizados podem levar a respostas irrelevantes ou incorretas, o que reduziria a confiança do usuário no sistema e, no pior cenário, faria mais mal do que bem.
Para resolver isso, garantimos que todos os documentos estivessem bem organizados e atualizados com regularidade. Isso não só melhora o processo de recuperação como garante que os usuários recebam a informação mais atual e precisa possível. À medida que seguimos ampliando as capacidades do chatbot, manter a qualidade e a relevância desses documentos continua sendo prioridade máxima.
Desenvolvimentos futuros
O nosso chatbot atual funciona muito bem e vai ajudar os usuários de várias formas, mas queremos um desempenho ainda melhor. Buscamos melhorar continuamente o serviço analisando as interações dos usuários. Assim conseguimos ver que tipos de pedido são feitos e guiar os nossos desenvolvimentos futuros de acordo. Por exemplo, se há muitas perguntas sobre o estado atual do mercado, podemos explorar formas de entregar melhor a informação de mercado aos nossos usuários.
Um dos nossos maiores desafios daqui para a frente vai ser garantir que o chatbot entregue informação atualizada de forma consistente. Isso exige atualizar com regularidade a sua base de conhecimento com os dados mais recentes, sobretudo em áreas que mudam rápido. O nosso objetivo não é só fazer o chatbot parecer um interlocutor de verdade, mas também garantir que ele sempre entregue a informação mais atual e relevante. Ao focar nesses aspectos, queremos oferecer ajuda na hora certa sobre temas variados, o que garante aos nossos usuários respostas precisas e úteis.
Estamos animados para ver este chatbot crescer e virar um assistente de fato completo, que não só responde perguntas como entrega leituras de mercado, recomendações personalizadas e até ajuda em decisões complexas.
Acompanhe as publicações de Tuğçe Güneş, Machine Learning Engineer na Vesper, para ficar por dentro enquanto seguimos nessa jornada de desenvolvimento!