Per anni acquirenti, venditori, trader e analisti di materie prime hanno dovuto affidarsi a fonti di dati frammentate, e questo rendeva difficile stare al passo con i cambiamenti di mercato e decidere per tempo. Senza un punto di riferimento unico e affidabile, i professionisti passavano spesso ore a mettere insieme dati per restare informati e formulare previsioni.
Oggi le piattaforme di intelligence sulle materie prime come Vesper risolvono questo problema offrendo una soluzione unica, che porta tutti i dati di prezzo essenziali, i report di mercato e le previsioni in un solo posto, facile da raggiungere.
Per quanto utili, però, queste piattaforme sono anche ricche di strumenti e informazioni potenti, e questo può renderle impegnative da esplorare. Gli utenti si trovano spesso davanti a difficoltà come individuare il prodotto esatto che serve loro (per esempio muoversi fra 33 diversi tipi di farina) o capire come interpretare i nostri strumenti di previsione per supportare le decisioni di budget.
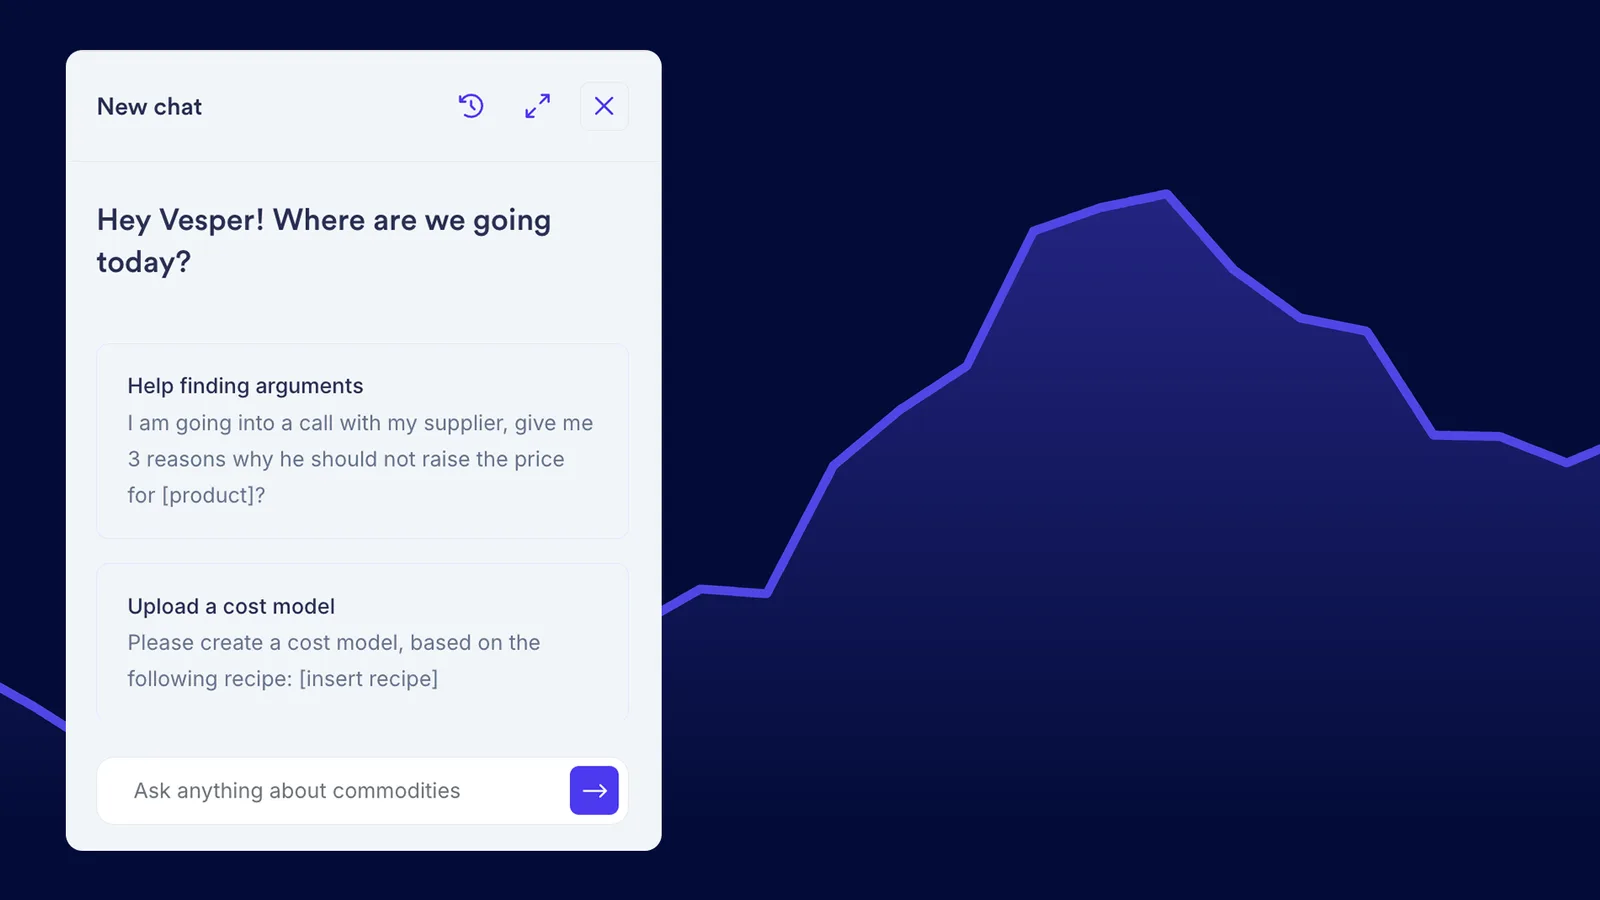
La missione di Vesper è restare la piattaforma di intelligence sulle materie prime più semplice da usare sul mercato, migliorando di continuo accessibilità e facilità d’uso. Nell’ambito di questo impegno abbiamo introdotto Vesbot: un chatbot basato sull’IA che offre risposte e indicazioni immediate senza interrompere il flusso di lavoro. Costruito con modelli ChatGPT adattati specificamente ai dati e ai casi d’uso di Vesper, Vesbot mette in fretta in contatto gli utenti con le informazioni rilevanti, li guida fra le funzioni della piattaforma e offre assistenza contestuale per le decisioni complesse. Vesbot snellisce l’esperienza d’uso riducendo il tempo speso a cercare risposte e offre supporto in qualsiasi momento del giorno e della notte, permettendo agli utenti di decidere più in fretta e meglio e di sfruttare appieno le capacità di Vesper.
Con Vesbot gli utenti accedono senza attriti a tutta la gamma di letture e dati di Vesper, senza la frizione di esplorare una piattaforma ampia o di attendere il supporto umano, e questo porta l’intelligence sulle materie prime a nuovi livelli di accessibilità ed efficienza.
In questo articolo scoprirete il percorso dietro la costruzione di Vesbot, compresi l’approccio tecnico che abbiamo scelto, le difficoltà incontrate e gli sviluppi futuri che stiamo pianificando. Alla fine avrete una comprensione più profonda di come funziona Vesbot, delle innovazioni di IA che lo alimentano e di come è stato pensato per offrire letture più rapide e intelligenti ai nostri utenti.
Come abbiamo affrontato la costruzione di un chatbot su misura?
Perché abbiamo avviato questo progetto e come lo abbiamo affrontato? Sono certa che molti di voi conoscano già ChatGPT. Questo chatbot, che è in sostanza un modello di IA abbinato a un’interfaccia utente, è straordinario nel fornire risposte in un modo che suona molto umano. Rispondere a domande specifiche del vostro caso d’uso, però, può essere difficile, perché gli mancano le informazioni necessarie per capire a fondo la domanda. Per riuscirci, il modello dovrebbe conoscere i dati relativi a quello specifico caso d’uso.
Esistono diversi metodi per adattare un chatbot a casi d’uso specifici. Abbiamo esplorato varie opzioni, fra cui addestrare il chatbot con un insieme predefinito di domande e risposte oppure usare sistemi basati su regole per scenari specifici. Alla fine abbiamo scelto l’approccio Retrieval-Augmented Generation (RAG).
Il RAG si distingue perché permette al chatbot di accedere e recuperare informazioni da un vasto database in tempo reale, assicurando che le risposte siano sempre aggiornate. Questo approccio consente al chatbot di attingere ai dati più rilevanti per rispondere con precisione. Il RAG migliora inoltre la capacità del chatbot di dare risposte contestualmente appropriate, lasciandoci la flessibilità di adattarlo con dati e letture specifiche per le vostre esigenze.
I modelli linguistici di grandi dimensioni e il loro adattamento
In questo capitolo introdurrò alcuni concetti tecnici fondamentali per capire i sistemi RAG. Se li conoscete già, saltate pure alla sezione «Come funziona il RAG?».
Modelli linguistici di grandi dimensioni (LLM)
Gli LLM si basano spesso su architetture transformer: prendono un input, lo codificano e poi lo decodificano per generare un output, esattamente come gli altri modelli basati su transformer. La differenza chiave fra gli LLM e i transformer ordinari è l’addestramento su insiemi di dati enormi, che comprendono fonti come siti web, libri, articoli di ricerca e altro. Questo addestramento esteso permette agli LLM di sviluppare una comprensione profonda del linguaggio.
Pensate a un LLM come a un super studente che legge miliardi di frasi per capire il linguaggio come lo capiscono gli esseri umani, contesto e riferimenti culturali compresi. Impara da solo da enormi quantità di materiale scritto, senza che nessuno glielo insegni esplicitamente. È questa capacità di autoapprendimento a rendere gli LLM così utili in contesti diversi, per esempio per alimentare i chatbot.
Gli LLM sono estremamente versatili e si possono applicare a qualunque progetto che riguardi il testo. Per esempio, possono analizzare il tono di un articolo di cronaca per capire se è positivo o negativo. Noi usiamo gli LLM per creare chatbot capaci di conversare in modo naturale, offrendo risposte più intuitive e simili a quelle umane.
Prompting
Possiamo descrivere il prompting come un modo di comunicare con un LLM. Dandogli una serie di istruzioni, potete adattare l’LLM ai vostri casi d’uso specifici. La qualità del prompt è fondamentale, perché più l’istruzione è efficace, migliore è la risposta che ottenete. Immaginate di fare una domanda a ChatGPT e che la risposta non sia esattamente quella che speravate. Potreste riformulare la domanda, aggiungere contesto o specificare certi dettagli. Questo processo di affinamento dell’input è in sostanza prompt engineering.
Fine-tuning
Il fine-tuning consiste nell’insegnare a un modello pre-addestrato a comportarsi meglio su un compito specifico. Per gli LLM questo comporta un metodo di apprendimento supervisionato, in cui il modello viene addestrato con un insieme di dati etichettati. Per esempio, se state facendo il fine-tuning di un LLM per l’analisi del sentiment, userete un insieme di dati in cui ogni testo è contrassegnato come «positivo» o «negativo». Durante il fine-tuning il modello regola le proprie impostazioni interne per migliorare nella previsione corretta delle etichette. Questo processo personalizza l’LLM e ne aumenta l’accuratezza per il vostro progetto specifico. Il fine-tuning fa sì che il modello funzioni meglio per la vostra applicazione particolare di quanto farebbe nella sua forma originale.
RAG
Ora che conoscete i concetti di LLM, prompting e fine-tuning, parliamo del metodo che abbiamo scelto per la nostra applicazione: il RAG.
In parole semplici, il RAG è una tecnica che permette di aggiungere i propri dati a un LLM in modo che generi risposte più accurate e pertinenti. Questo metodo affronta due sfide importanti che gli LLM incontrano di frequente: le allucinazioni e le informazioni obsolete.
Le allucinazioni si verificano quando un LLM genera informazioni sbagliate, spesso perché non conosce la risposta ma prova comunque a darne una. Le informazioni obsolete sono un problema perché gli LLM sono addestrati su dati disponibili fino alla data di addestramento, e quindi non hanno le informazioni più recenti.
Dato che stiamo costruendo un chatbot, fornire agli utenti informazioni attuali e corrette è essenziale. Risposte obsolete o errate possono erodere la fiducia e ridurre l’efficacia dell’applicazione.
Usando il RAG possiamo mitigare questi problemi. Il modello recupera le informazioni rilevanti da un insieme di dati specifico e aggiornato e le combina con le proprie capacità di generazione linguistica, assicurando che le risposte siano sia accurate sia attuali.
Qui di seguito spiegherò un po’ meglio come funziona il RAG e quali passaggi servono per implementarlo in modo efficace.
Come funziona il RAG?

Per capire a fondo come il RAG permetta agli LLM di produrre risposte più accurate e contestualmente pertinenti, dobbiamo esplorare tre componenti essenziali: la documentazione esterna, il processo di recupero e la fase di arricchimento. L’immagine qui sopra illustra questi concetti nel dettaglio.
Documentazione esterna
Gli LLM sono addestrati su insiemi di dati molto ampi, ma non comprendono informazioni specifiche o aggiornate oltre i dati di addestramento originali. I dati esterni, che possono presentarsi in formati diversi come database strutturati, PDF o documenti di testo semplice, devono essere incorporati nella base di conoscenza del modello. Per farlo, i dati esterni vengono convertiti in formato numerico e memorizzati in database vettoriali, così da essere accessibili e interpretabili dall’LLM.
Recupero
Una volta memorizzati i dati esterni in un database vettoriale, il passo successivo è il processo di recupero. I nostri dati esterni contengono molti documenti diversi, e l’obiettivo del recupero è restituire da questi documenti solo le parti collegate alla richiesta dell’utente. In questo processo i documenti più rilevanti vengono restituiti sulla base di un punteggio di pertinenza, che dipende da quanto la richiesta corrisponde al contenuto dei documenti.
Per esempio, se un utente pone al chatbot delle FAQ una domanda come «Voglio modificare il mio account», il sistema di recupero cerca nei dati i documenti relativi alla gestione dell’account. L’algoritmo può inoltre dare priorità ai documenti che trattano nello specifico le modifiche o le procedure più comuni, assicurando all’utente le informazioni più rilevanti e utili.
Arricchimento
Una volta recuperati i documenti rilevanti, l’LLM usa questi dati insieme al prompt fornito per generare una risposta. In questo passaggio il prompt ha un ruolo decisivo. Come detto, un prompt ben costruito può influenzare in modo significativo l’LLM e portarlo a produrre una risposta in linea con le vostre aspettative. Con la combinazione di dati esterni accurati e di un prompt progettato con cura, il RAG assicura che l’LLM sappia dare una risposta precisa e contestualmente pertinente.
L’importanza di una documentazione di qualità
L’efficacia del nostro chatbot di aiuto e supporto si fonda sulla qualità e sull’organizzazione delle informazioni che forniamo al sistema RAG. Curando e strutturando con attenzione questi documenti, ci assicuriamo che il chatbot possa dare risposte precise e utili alle domande degli utenti.
Per massimizzare l’utilità del chatbot abbiamo organizzato i dati in sezioni distinte. Dato che si tratta di un chatbot pensato per la piattaforma Vesper, è essenziale includere documentazione completa sulle varie funzioni e caratteristiche della piattaforma. Abbiamo incluso i seguenti tipi di documenti:
Navigazione e struttura della piattaforma:
- Scopo: aiutare gli utenti a muoversi con facilità nella piattaforma Vesper.
- Contenuto: descrizioni dettagliate della struttura della piattaforma, compreso come raggiungere le diverse sezioni e usare le varie funzioni. Comprende anche guide di prodotto con istruzioni passo passo per usare parti specifiche dello strumento.
Documentazione sulle funzionalità:
- Scopo: fornire risposte rapide e accurate sulle funzionalità specifiche della piattaforma.
- Contenuto: informazioni su funzioni avanzate come lo scarico dei dati e le integrazioni via API.
Report di mercato e letture regionali:
- Scopo: spiegare quali tipi di analisi copriamo sulle varie materie prime.
- Contenuto: spiegazioni dei report sulle varie materie prime, con la loro rilevanza e il loro uso all’interno della piattaforma.
Disponibilità dei dati:
- Scopo: informare gli utenti sulle serie di dati disponibili nella piattaforma Vesper.
- Contenuto: un elenco completo dei dati disponibili sulla piattaforma.
Usando questi dati, gli esempi seguenti mostrano come il chatbot sia ora in grado di supportare i nostri utenti su domande molto specifiche legate alla piattaforma:

L’importanza della qualità dei dati esterni
Durante lo sviluppo del chatbot abbiamo incontrato difficoltà legate alla qualità e alla struttura dei documenti. Documenti di alta qualità e ben organizzati sono fondamentali, perché incidono direttamente sulla capacità del chatbot di recuperare e fornire informazioni accurate. Documenti mal strutturati o obsoleti possono portare a risposte irrilevanti o sbagliate, che rischiano di ridurre la fiducia degli utenti nel sistema e, nello scenario peggiore, di fare più danno che bene.
Per affrontare questo problema ci siamo assicurati che tutti i documenti fossero ben organizzati e aggiornati con regolarità. Questo non solo migliora il processo di recupero, ma fa anche sì che gli utenti ricevano le informazioni più attuali e accurate possibili. Mentre continuiamo ad ampliare le capacità del chatbot, mantenere la qualità e la pertinenza di questi documenti resta una priorità assoluta.
Sviluppi futuri
Il nostro chatbot attuale funziona benissimo e aiuterà i nostri utenti in molti modi, ma puntiamo a prestazioni ancora migliori. Ci impegniamo a migliorare di continuo il servizio per i nostri utenti analizzando le loro interazioni. Così possiamo vedere quali tipi di richieste vengono fatte e orientare di conseguenza i nostri sviluppi futuri. Per esempio, se ci sono molte domande sullo stato attuale del mercato, possiamo esplorare modi migliori per offrire ai nostri utenti informazioni di mercato.
Una delle sfide maggiori che ci attendono sarà fare in modo che il chatbot fornisca sempre informazioni aggiornate. Questo richiede di aggiornare regolarmente la sua base di conoscenza con i dati più recenti, soprattutto in ambiti che cambiano in fretta. Il nostro obiettivo non è solo far sì che il chatbot sembri un vero interlocutore, ma anche garantire che offra sempre le informazioni più attuali e pertinenti. Concentrandoci su questi aspetti puntiamo a offrire assistenza tempestiva su vari argomenti, assicurando ai nostri utenti risposte accurate e utili.
Siamo entusiasti di vedere questo chatbot crescere fino a diventare un assistente davvero completo, capace non solo di rispondere a domande ma anche di offrire letture di mercato, suggerimenti personalizzati e perfino aiuto nelle decisioni complesse.
Seguite le pubblicazioni di Tuğçe Güneş, Machine Learning Engineer di Vesper, per restare aggiornati mentre proseguiamo questo percorso di sviluppo!