Przez lata kupujący, sprzedający, traderzy i analitycy surowcowi musieli polegać na rozproszonych źródłach danych, co utrudniało nadążanie za zmianami rynkowymi i podejmowanie decyzji na czas. Bez centralnego miejsca z wiarygodnymi informacjami profesjonaliści spędzali często godziny na składaniu danych w całość, żeby być na bieżąco i tworzyć prognozy.
Dziś platformy analityki surowcowej takie jak Vesper rozwiązują ten problem, oferując rozwiązanie kompleksowe i zbierając wszystkie kluczowe dane cenowe, raporty rynkowe i prognozy w jednym, łatwo dostępnym miejscu.
A jednak, przy całej swojej użyteczności, platformy te są też naładowane potężnymi narzędziami i informacjami, po których poruszanie się bywa przytłaczające. Użytkownicy często mierzą się z wyzwaniami takimi jak ustalenie, którego dokładnie produktu potrzebują (np. przejście przez 33 różne rodzaje mąki) albo zrozumienie, jak interpretować nasze narzędzia prognostyczne przy decyzjach budżetowych.
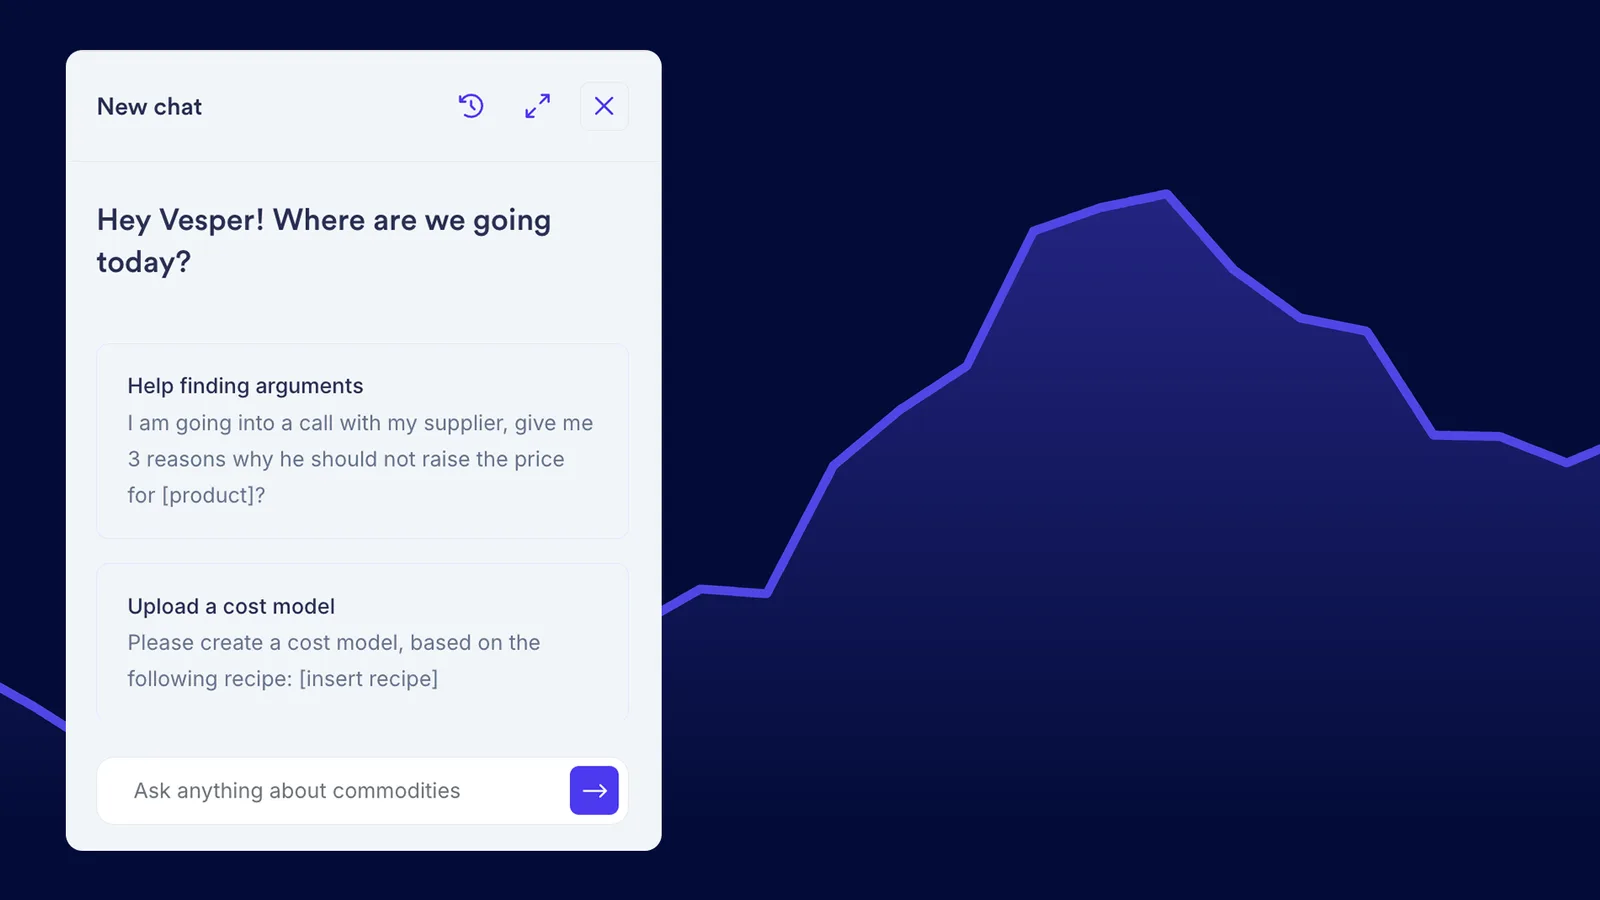
Misją Vesper jest pozostanie najbardziej przyjazną użytkownikowi platformą analityki surowcowej na rynku i ciągłe zwiększanie jej dostępności oraz łatwości obsługi. W ramach tego zobowiązania wprowadziliśmy Vesbot: chatbota opartego na AI, który udziela natychmiastowych odpowiedzi i wskazówek, nie przerywając procesu pracy. Zbudowany na modelach ChatGPT dostosowanych specjalnie do danych i zastosowań Vesper, Vesbot szybko łączy użytkowników z trafnymi spostrzeżeniami, prowadzi ich przez funkcje platformy i zapewnia kontekstowe wsparcie przy złożonych decyzjach. Vesbot usprawnia doświadczenie użytkownika, skracając czas poświęcany na szukanie odpowiedzi, i oferuje wsparcie przez całą dobę, dzięki czemu użytkownicy podejmują szybsze, lepiej poinformowane decyzje i w pełni wykorzystują możliwości Vesper.
Z asystentem Vesbot użytkownicy mają płynny dostęp do pełnego zakresu spostrzeżeń i danych Vesper, bez tarcia związanego z poruszaniem się po dużej platformie czy czekaniem na wsparcie człowieka, co podnosi analitykę surowcową na nowy poziom dostępności i wydajności.
W tym artykule poznasz drogę, jaka doprowadziła do powstania Vesbot, w tym podejście techniczne, które wybraliśmy, wyzwania, na jakie natrafiliśmy, oraz przyszłe prace, które planujemy. Na koniec będziesz lepiej rozumieć, jak działa Vesbot, jakie innowacje AI go napędzają i jak został zaprojektowany, żeby dostarczać naszym użytkownikom szybsze i mądrzejsze spostrzeżenia.
Jak podeszliśmy do budowy własnego chatbota?
Dlaczego więc zaczęliśmy ten projekt i jak się do niego zabraliśmy? Z pewnością wielu z Was zna już ChatGPT. Ten chatbot, który jest w gruncie rzeczy modelem AI połączonym z interfejsem użytkownika, niesamowicie radzi sobie z udzielaniem odpowiedzi w sposób, który sprawia wrażenie bardzo ludzkiego. Odpowiadanie na pytania charakterystyczne dla Twojego zastosowania bywa jednak trudne. Dzieje się tak dlatego, że brakuje mu informacji potrzebnych, żeby w pełni zrozumieć Twoje pytanie. Żeby to osiągnąć, model musiałby znać dane związane z tym konkretnym zastosowaniem.
Istnieje kilka metod dostosowywania chatbota do konkretnych zastosowań. Przyjrzeliśmy się różnym opcjom, w tym trenowaniu chatbota na z góry zdefiniowanym zestawie pytań i odpowiedzi albo wykorzystaniu systemów regułowych dla określonych scenariuszy. Ostatecznie wybraliśmy podejście Retrieval-Augmented Generation (RAG).
RAG wyróżnia się tym, że pozwala chatbotowi sięgać po informacje z ogromnej bazy danych i pobierać je w czasie rzeczywistym, dzięki czemu odpowiedzi są zawsze aktualne. To podejście pozwala chatbotowi wciągnąć najbardziej odpowiednie dane, żeby trafnie odpowiedzieć na pytania. Dodatkowo RAG wzmacnia zdolność chatbota do udzielania odpowiedzi dopasowanych do kontekstu, a nam daje elastyczność w dostosowywaniu go danymi i spostrzeżeniami odpowiadającymi Twoim unikalnym potrzebom.
Duże modele językowe i ich adaptacja
W tym rozdziale przedstawię kilka kluczowych pojęć technicznych, które są fundamentem zrozumienia systemów RAG. Jeśli znasz już te pojęcia, możesz spokojnie przejść od razu do sekcji „Jak działa RAG?”.
Duże modele językowe (LLM)
Modele LLM często opierają się na architekturach transformerowych, co oznacza, że przyjmują dane wejściowe, kodują je, a potem dekodują, żeby wygenerować wynik, dokładnie tak jak inne modele oparte na transformerach. Kluczowa różnica między modelami LLM a zwykłymi transformerami polega na tym, że są trenowane na ekstremalnie dużych zbiorach danych, obejmujących źródła takie jak strony internetowe, książki, prace naukowe i wiele innych. To rozległe trenowanie pozwala modelom LLM wykształcić głębokie rozumienie języka.
Pomyśl o modelu LLM jak o superuczniu, który czyta miliardy zdań, żeby rozumieć język tak jak ludzie, łącznie z kontekstem i kulturowymi podpowiedziami. Uczy się sam z ogromnych ilości materiału pisanego, bez konieczności jawnego nauczania go przez kogokolwiek. To właśnie ta zdolność do samodzielnego uczenia się sprawia, że modele LLM są tak przydatne w różnych zastosowaniach, na przykład jako napęd chatbotów.
Modele LLM są niewiarygodnie wszechstronne i można je zastosować w każdym projekcie, w którym pojawia się tekst. Mogą na przykład analizować wydźwięk artykułu prasowego, żeby określić, czy jest pozytywny, czy negatywny. My wykorzystujemy modele LLM do tworzenia chatbotów, które potrafią rozmawiać naturalnie i udzielają w rozmowie bardziej intuicyjnych, bardziej ludzkich odpowiedzi.
Prompting
Prompting można opisać jako sposób komunikowania się z modelem LLM. Podając mu zestaw instrukcji, możesz dostosować model LLM do swoich konkretnych zastosowań. Jakość promptu jest kluczowa, bo im skuteczniejsza instrukcja, tym lepszą odpowiedź dostajesz. Wyobraź sobie, że zadajesz ChatGPT pytanie, ale odpowiedź, którą otrzymujesz, nie jest do końca tym, na co liczysz. Możesz przeformułować pytanie, dodać więcej kontekstu albo doprecyzować pewne szczegóły. Ten proces dopracowywania tego, co wpisujesz, to w istocie inżynieria promptów.
Dostrajanie (fine-tuning)
Dostrajanie polega na tym, że uczymy wstępnie wytrenowany model lepiej radzić sobie z konkretnym zadaniem. W przypadku modeli LLM wykorzystuje się do tego metodę uczenia nadzorowanego, w której model trenuje się na oznaczonym zbiorze danych. Jeśli na przykład dostrajasz model LLM do analizy wydźwięku, użyjesz zbioru, w którym każdy tekst jest oznaczony jako „pozytywny” albo „negatywny”. W trakcie dostrajania model koryguje swoje wewnętrzne ustawienia, żeby trafniej przewidywać etykiety. Ten proces dopasowuje model LLM i zwiększa jego dokładność w Twoim konkretnym projekcie. Dzięki dostrajaniu model działa lepiej w Twoim konkretnym zastosowaniu niż w swojej pierwotnej postaci.
RAG
Skoro rozumiesz już pojęcia modeli LLM, promptingu i dostrajania, porozmawiajmy o metodzie, którą wybraliśmy do naszego zastosowania: RAG.
Mówiąc prosto, RAG to technika, która pozwala dodać własne dane do modelu LLM, żeby generował trafniejsze i bardziej adekwatne odpowiedzi. Ta metoda odpowiada na dwa poważne wyzwania, z którymi modele LLM mierzą się najczęściej: konfabulacje i nieaktualne informacje.
Konfabulacje pojawiają się wtedy, gdy model LLM generuje nieprawdziwe informacje, często dlatego, że nie zna odpowiedzi, a mimo to próbuje jej udzielić. Nieaktualne informacje są problemem, bo modele LLM trenuje się na danych dostępnych do dnia treningu, przez co brakuje im najświeższych informacji.
Ponieważ budujemy chatbota, dostarczanie użytkownikom aktualnych i poprawnych informacji jest kluczowe. Nieaktualne albo nieprawidłowe odpowiedzi mogą nadszarpnąć zaufanie i obniżyć skuteczność aplikacji.
Dzięki RAG możemy ograniczyć te problemy. Model pobiera odpowiednie informacje z określonego, aktualnego zbioru danych i łączy je ze swoimi zdolnościami generowania języka, dzięki czemu odpowiedzi są zarówno trafne, jak i aktualne.
Dalej wyjaśnię nieco więcej o tym, jak działa RAG i jakie kroki są potrzebne, żeby skutecznie go wdrożyć.
Jak działa RAG?

Żeby w pełni pojąć, jak RAG pozwala modelom LLM tworzyć trafniejsze i lepiej dopasowane do kontekstu odpowiedzi, musimy przyjrzeć się trzem kluczowym elementom: dokumentacji zewnętrznej, procesowi wyszukiwania i fazie augmentacji. Powyższy obraz szczegółowo ilustruje te pojęcia.
Dokumentacja zewnętrzna
Modele LLM trenuje się na dużych zbiorach danych, ale nie zawierają one konkretnych ani aktualnych informacji wykraczających poza pierwotne dane treningowe. Dane zewnętrzne, które mogą mieć różne formaty, takie jak ustrukturyzowane bazy danych, pliki PDF czy zwykłe dokumenty tekstowe, trzeba włączyć do bazy wiedzy modelu. Żeby to zrobić, dane zewnętrzne przekształca się do formatu liczbowego i zapisuje w bazach wektorowych, dzięki czemu stają się dostępne i czytelne dla modelu LLM.
Wyszukiwanie
Kiedy zapiszemy już nasze dane zewnętrzne w bazie wektorowej, kolejnym krokiem jest proces wyszukiwania. Nasze dane zewnętrzne zawierają wiele różnych dokumentów, a celem wyszukiwania jest zwrócenie z nich wyłącznie tych fragmentów, które są związane z zapytaniem użytkownika. W tym procesie najbardziej odpowiednie dokumenty zwraca się na podstawie oceny trafności, opartej na tym, jak blisko zapytanie odpowiada treści dokumentów.
Na przykład jeśli użytkownik zada chatbotowi FAQ pytanie w rodzaju „chcę wprowadzić zmiany na swoim koncie”, system wyszukiwania przeszukuje dane, żeby znaleźć dokumenty dotyczące zarządzania kontem. Dodatkowo algorytm może nadać priorytet dokumentom, które wprost odnoszą się do typowych zmian na koncie albo procedur, dzięki czemu użytkownik dostaje najbardziej trafne i pomocne informacje.
Augmentacja
Kiedy odpowiednie dokumenty zostaną już wyszukane, model LLM wykorzystuje te dane razem z podanym promptem, żeby wygenerować odpowiedź. Na tym etapie prompt odgrywa kluczową rolę. Jak wspomniano wcześniej, dobrze ułożony prompt potrafi znacząco wpłynąć na to, że model LLM wygeneruje odpowiedź zgodną z Twoimi oczekiwaniami. Dzięki połączeniu trafnych danych zewnętrznych ze starannie zaprojektowanym promptem RAG sprawia, że model LLM może udzielić precyzyjnej i dopasowanej do kontekstu odpowiedzi.
Znaczenie dokumentacji wysokiej jakości
Skuteczność naszego chatbota pomocy i wsparcia opiera się na jakości i uporządkowaniu informacji, które przekazujemy systemowi RAG. Starannie dobierając i strukturyzując te dokumenty, dbamy o to, żeby chatbot mógł udzielać precyzyjnych i pomocnych odpowiedzi na zapytania użytkowników.
Żeby zmaksymalizować użyteczność chatbota, uporządkowaliśmy dane w wyraźnie oddzielone sekcje. Ponieważ jest to chatbot dostosowany do platformy Vesper, kluczowe jest zawarcie kompletnej dokumentacji dotyczącej różnych funkcji i możliwości platformy. Uwzględniliśmy następujące typy dokumentów:
Nawigacja i struktura platformy:
- Cel: pomoc użytkownikom w łatwym poruszaniu się po platformie Vesper.
- Treść: szczegółowe opisy struktury platformy, w tym tego, jak dotrzeć do poszczególnych sekcji i korzystać z różnych funkcji. Obejmuje to także przewodniki produktowe z instrukcjami krok po kroku dotyczącymi korzystania z konkretnych części narzędzia.
Dokumentacja funkcjonalności:
- Cel: udzielanie szybkich i trafnych odpowiedzi na temat konkretnych funkcjonalności platformy.
- Treść: informacje o zaawansowanych funkcjach, takich jak pobieranie danych i integracje z API.
Raporty rynkowe i spostrzeżenia regionalne:
- Cel: dostarczenie wglądu w to, jakie rodzaje analiz obejmujemy dla różnych surowców.
- Treść: objaśnienia raportów dotyczących różnych surowców wraz z ich znaczeniem i zastosowaniem w platformie.
Dostępność danych:
- Cel: informowanie użytkowników o dostępnych seriach danych na platformie Vesper.
- Treść: kompletna lista danych dostępnych na platformie.
Poniższe przykłady pokazują, jak dzięki tym danym chatbot potrafi teraz wesprzeć naszych użytkowników przy bardzo konkretnych pytaniach dotyczących platformy:

Znaczenie jakości danych zewnętrznych
Przez cały czas prac nad chatbotem napotykaliśmy wyzwania związane z jakością i strukturą dokumentów. Dokumenty wysokiej jakości i dobrze uporządkowane są kluczowe, bo bezpośrednio wpływają na zdolność chatbota do wyszukiwania i dostarczania trafnych informacji. Źle ustrukturyzowane albo nieaktualne dokumenty mogą prowadzić do nieadekwatnych lub błędnych odpowiedzi, co mogłoby osłabić zaufanie użytkowników do systemu, a w najgorszym scenariuszu przynieść więcej szkody niż pożytku.
Żeby się tym zająć, zadbaliśmy o to, by wszystkie dokumenty były dobrze uporządkowane i regularnie aktualizowane. To nie tylko usprawnia proces wyszukiwania, ale też sprawia, że użytkownicy otrzymują możliwie najbardziej aktualne i trafne informacje. W miarę jak dalej rozbudowujemy możliwości chatbota, utrzymanie jakości i aktualności tych dokumentów pozostaje priorytetem.
Przyszłe prace rozwojowe
Nasz obecny chatbot działa świetnie i pomoże naszym użytkownikom na wiele sposobów, ale celujemy w jeszcze lepsze wyniki. Staramy się nieustannie ulepszać tę usługę dla naszych użytkowników, analizując ich interakcje. Dzięki temu widzimy, jakiego rodzaju zapytania się pojawiają, i odpowiednio ukierunkowujemy dalsze prace. Jeśli na przykład pojawia się dużo pytań o bieżący stan rynku, możemy poszukać sposobów na lepsze dostarczanie użytkownikom informacji rynkowych.
Jednym z naszych największych wyzwań na przyszłość będzie zadbanie o to, żeby chatbot konsekwentnie dostarczał aktualne informacje. Wymaga to regularnego aktualizowania jego bazy wiedzy najnowszymi danymi, zwłaszcza w szybko zmieniających się obszarach. Naszym celem jest nie tylko sprawienie, żeby chatbot sprawiał wrażenie prawdziwego rozmówcy, ale też zadbanie o to, by zawsze dostarczał najbardziej aktualne i adekwatne informacje. Skupiając się na tych aspektach, chcemy oferować pomoc na czas w różnych tematach i dbać o to, żeby nasi użytkownicy otrzymywali trafne i pomocne odpowiedzi.
Z ekscytacją patrzymy, jak ten chatbot rozwija się w naprawdę kompleksowego asystenta, który nie tylko odpowiada na pytania, ale też dostarcza spostrzeżeń rynkowych, spersonalizowanych rekomendacji, a nawet pomaga w podejmowaniu złożonych decyzji.
Śledź publikacje Tuğçe Güneş, Machine Learning Engineer w Vesper, żeby być na bieżąco z naszą dalszą drogą rozwojową!