Jarenlang moesten kopers, verkopers, handelaren en analisten in grondstoffen het doen met versnipperde databronnen, waardoor het lastig was om marktveranderingen bij te houden en op tijd te beslissen. Zonder centrale plek met betrouwbare informatie waren professionals vaak uren bezig data bij elkaar te sprokkelen om op de hoogte te blijven en prognoses te maken.
Vandaag lossen platforms voor marktinformatie als Vesper dat probleem op met één plek waar alle essentiële prijsdata, marktrapporten en prognoses samenkomen, eenvoudig toegankelijk.
Toch zijn die platforms, hoe nuttig ook, boordevol krachtige tools en informatie, waarin je makkelijk de weg kwijtraakt. Gebruikers worstelen vaak met vragen als: welk product heb ik nu precies nodig (denk aan het doorzoeken van 33 verschillende soorten meel), of: hoe interpreteer ik de prognosetools om mijn budgetbeslissingen te onderbouwen?
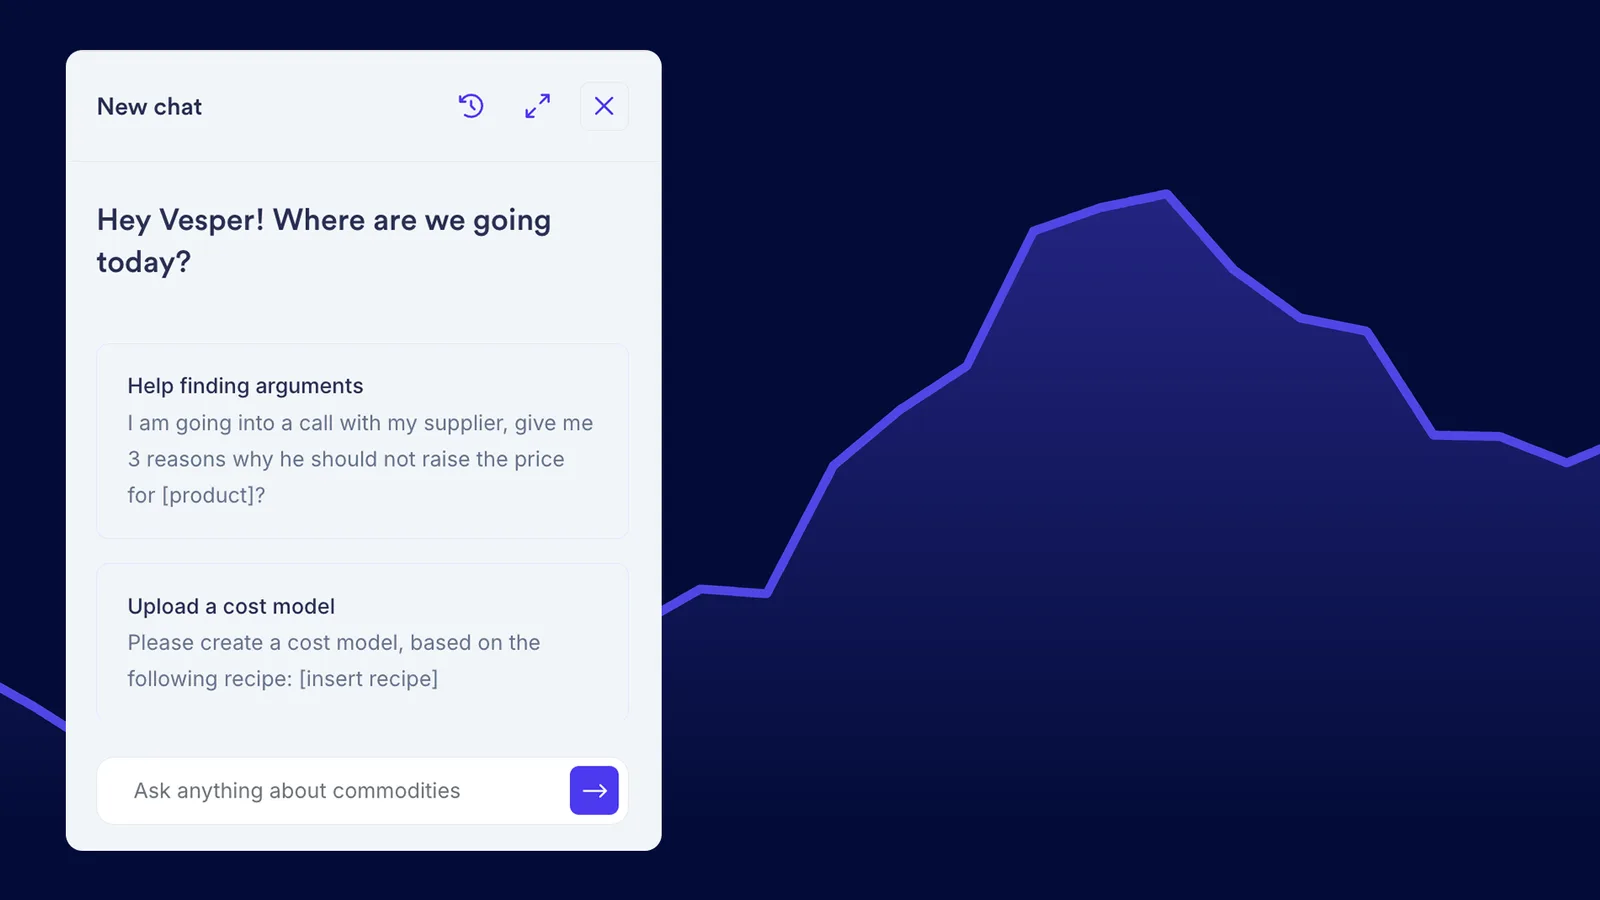
Het is de missie van Vesper om het gebruiksvriendelijkste platform voor marktinformatie te blijven en de toegankelijkheid en het gebruiksgemak steeds verder te verbeteren. Als onderdeel daarvan introduceren we Vesbot: een AI-chatbot die direct antwoord en begeleiding geeft, zonder je werk te onderbreken. Vesbot is gebouwd op ChatGPT-modellen die specifiek zijn afgestemd op de data en de toepassingen van Vesper. Hij verbindt gebruikers snel met relevante inzichten, leidt ze door de functies van het platform en biedt context bij complexe beslissingen. Vesbot stroomlijnt de gebruikerservaring doordat je minder tijd kwijt bent aan het zoeken naar antwoorden, en hij staat dag en nacht klaar, zodat gebruikers sneller en beter onderbouwd beslissen en alles uit Vesper halen.
Met Vesbot krijgen gebruikers moeiteloos toegang tot het volledige aanbod aan inzichten en data van Vesper, zonder de wrijving van navigeren door een groot platform of wachten op hulp van een medewerker. Zo komt marktinformatie op een nieuw niveau van toegankelijkheid en efficiëntie.
In dit artikel ontdek je het verhaal achter de bouw van Vesbot, inclusief de technische aanpak die we kozen, de uitdagingen die we tegenkwamen en wat we in de toekomst willen ontwikkelen. Aan het eind begrijp je beter hoe Vesbot werkt, welke AI-innovaties hem aandrijven en hoe hij is ontworpen om onze gebruikers sneller en slimmer inzicht te geven.
Hoe pakten we het bouwen van een eigen chatbot aan?
Waarom begonnen we dit project, en hoe hebben we het aangepakt? Vast en zeker ken je ChatGPT al. Die chatbot, in de kern een AI-model gekoppeld aan een gebruikersinterface, is ongelooflijk goed in antwoorden die heel menselijk aanvoelen. Vragen die specifiek over jouw situatie gaan, zijn echter lastiger, omdat het model de informatie mist om je vraag volledig te begrijpen. Daarvoor zou het vertrouwd moeten zijn met data die bij dat specifieke gebruik horen.
Er zijn verschillende manieren om een chatbot op specifieke toepassingen af te stemmen. We verkenden diverse opties, waaronder de chatbot trainen met een vooraf bepaalde set vragen en antwoorden, of regelgebaseerde systemen voor specifieke scenario’s inzetten. Uiteindelijk kozen we voor de aanpak van Retrieval-Augmented Generation (RAG).
RAG springt eruit omdat de chatbot er in realtime informatie uit een enorme database mee kan ophalen, zodat de antwoorden altijd actueel zijn. Zo haalt de chatbot precies die data binnen die nodig zijn om een vraag nauwkeurig te beantwoorden. Bovendien versterkt RAG het vermogen van de chatbot om contextueel passende antwoorden te geven, terwijl wij de vrijheid houden om hem af te stemmen op data en inzichten die bij jouw specifieke behoeften passen.
Grote taalmodellen en hun aanpassing
In dit hoofdstuk introduceer ik een aantal technische begrippen die de basis vormen voor een goed begrip van RAG-systemen. Ben je er al mee vertrouwd, sla dan gerust door naar het onderdeel “Hoe werkt RAG?”.
Grote taalmodellen (LLM’s)
LLM’s zijn vaak gebaseerd op transformerarchitecturen: ze nemen invoer op, coderen die en decoderen die vervolgens om uitvoer te genereren, net als andere modellen op basis van transformers. Het belangrijkste verschil tussen LLM’s en gewone transformers is hun training op buitengewoon grote datasets, met bronnen als websites, boeken, onderzoekspapers en meer. Door die uitgebreide training ontwikkelen LLM’s een diep begrip van taal.
Zie een LLM als een superleerling die miljarden zinnen leest om taal te begrijpen zoals mensen dat doen, inclusief context en culturele hints. Hij leert zelfstandig uit enorme hoeveelheden geschreven materiaal, zonder dat iemand het hem expliciet hoeft te leren. Dat zelflerende vermogen maakt LLM’s zo bruikbaar in allerlei situaties, bijvoorbeeld om chatbots aan te drijven.
LLM’s zijn enorm veelzijdig en bruikbaar in elk project waarin tekst voorkomt. Ze kunnen bijvoorbeeld de toon van een nieuwsartikel analyseren om te bepalen of die positief of negatief is. Wij gebruiken LLM’s om chatbots te bouwen die natuurlijk kunnen praten en zo intuïtievere, menselijkere antwoorden geven in gesprekken.
Prompting
Prompting kun je zien als een manier om met een LLM te communiceren. Door het model een set instructies te geven, stem je het af op jouw specifieke toepassing. De kwaliteit van de prompt is cruciaal: hoe doeltreffender de instructie, hoe beter het antwoord. Stel dat je ChatGPT een vraag stelt, maar het antwoord niet helemaal is wat je hoopte. Dan herformuleer je de vraag, voeg je context toe of geef je bepaalde details nauwkeuriger aan. Dat verfijnen van je invoer is in de kern prompt engineering.
Fine-tuning
Fine-tuning is het bijtrainen van een vooraf getraind model zodat het beter presteert op een specifieke taak. Voor LLM’s gebeurt dat met begeleid leren, waarbij het model wordt getraind met een gelabelde dataset. Stem je een LLM af op sentimentanalyse, dan gebruik je bijvoorbeeld een dataset waarin elke tekst is gemarkeerd als “positief” of “negatief”. Tijdens het fine-tunen past het model zijn interne instellingen aan om de labels beter te voorspellen. Zo wordt het LLM op maat gemaakt en nauwkeuriger voor jouw project. Fine-tuning zorgt ervoor dat het model beter presteert voor jouw specifieke toepassing dan in zijn oorspronkelijke vorm.
RAG
Nu je de begrippen LLM’s, prompting en fine-tuning kent, komen we bij de methode die we voor onze toepassing hebben gekozen: RAG.
Simpel gezegd is RAG een techniek waarmee je je eigen data aan een LLM toevoegt, zodat het nauwkeurigere en relevantere antwoorden kan genereren. Die methode pakt twee grote problemen van LLM’s aan: hallucinaties en verouderde informatie.
Hallucinaties ontstaan wanneer een LLM onjuiste informatie genereert, vaak omdat het het antwoord niet kent maar er toch een probeert te geven. Verouderde informatie is een probleem omdat LLM’s worden getraind op data tot aan de trainingsdatum, waardoor de meest actuele informatie ontbreekt.
Omdat we een chatbot bouwen, is actuele en correcte informatie essentieel. Verouderde of onjuiste antwoorden ondermijnen het vertrouwen en verkleinen de waarde van de toepassing.
Met RAG verkleinen we die problemen. Het model haalt relevante informatie uit een specifieke, actuele dataset en combineert die met zijn taalvaardigheid, zodat de antwoorden zowel accuraat als actueel zijn.
Hierna leg ik wat verder uit hoe RAG werkt en welke stappen nodig zijn om het goed toe te passen.
Hoe werkt RAG?

Om volledig te begrijpen hoe RAG LLM’s nauwkeurigere en contextueel relevantere antwoorden laat geven, moeten we drie essentiële onderdelen bekijken: externe documentatie, het ophaalproces en de augmentatiefase. De afbeelding hierboven laat die begrippen in detail zien.
Externe documentatie
LLM’s worden getraind op grote datasets, maar die bevatten geen specifieke of actuele informatie van na hun oorspronkelijke training. Externe data, die in allerlei vormen kunnen komen, zoals gestructureerde databases, pdf’s of platte tekstdocumenten, moeten worden opgenomen in de kennisbasis van het model. Daarvoor worden externe data omgezet in een numeriek formaat en opgeslagen in vectordatabases, waardoor het LLM ze kan benaderen en interpreteren.
Ophalen
Zodra onze externe data in een vectordatabase staan, volgt het ophaalproces. Onze externe data bestaan uit veel verschillende documenten, en het doel van het ophalen is om daaruit alleen de delen terug te geven die bij de vraag van de gebruiker horen. Daarbij worden de meest relevante documenten teruggegeven op basis van een relevantiescore, die berekent hoe goed de vraag aansluit op de inhoud van de documenten.
Stelt een gebruiker bijvoorbeeld de vraag ‘ik wil iets wijzigen aan mijn account’ aan de FAQ-chatbot, dan doorzoekt het ophaalsysteem de data op documenten over accountbeheer. Het algoritme kan bovendien voorrang geven aan documenten die specifiek over veelvoorkomende accountwijzigingen of procedures gaan, zodat de gebruiker de meest relevante en bruikbare informatie krijgt.
Augmentatie
Zodra de relevante documenten zijn opgehaald, gebruikt het LLM die data samen met de meegegeven prompt om een antwoord te genereren. In die stap speelt de prompt een cruciale rol. Zoals gezegd kan een goed geformuleerde prompt het LLM sterk sturen richting een antwoord dat aansluit bij je verwachtingen. Met de combinatie van accurate externe data en een zorgvuldig ontworpen prompt zorgt RAG ervoor dat het LLM een precies en contextueel relevant antwoord kan geven.
Het belang van goede documentatie
De effectiviteit van onze help- en supportchatbot staat of valt met de kwaliteit en de ordening van de informatie die we aan het RAG-systeem geven. Door die documenten zorgvuldig te selecteren en te structureren, zorgen we dat de chatbot precieze en bruikbare antwoorden geeft op vragen van gebruikers.
Om de chatbot zo nuttig mogelijk te maken, hebben we de data in afzonderlijke onderdelen geordend. Omdat het om een chatbot voor het Vesper-platform gaat, is het essentieel om uitgebreide documentatie op te nemen over de verschillende functies en mogelijkheden van het platform. We hebben de volgende soorten documenten meegenomen:
Navigatie en structuur van het platform:
- Doel: gebruikers helpen moeiteloos hun weg te vinden in het Vesper-platform.
- Inhoud: gedetailleerde beschrijvingen van de structuur van het platform, inclusief hoe je verschillende onderdelen bereikt en diverse functies gebruikt. Hiertoe behoren ook producthandleidingen met stapsgewijze instructies voor specifieke onderdelen van de tool.
Documentatie over functionaliteit:
- Doel: snelle en accurate antwoorden geven over de specifieke functionaliteiten van het platform.
- Inhoud: informatie over geavanceerde functies zoals het downloaden van data en API-integraties.
Marktrapporten en regionale inzichten:
- Doel: inzicht geven in welke soorten analyse we per grondstof bieden.
- Inhoud: toelichting op de rapporten over diverse grondstoffen, met hun relevantie en gebruik binnen het platform.
Beschikbaarheid van data:
- Doel: gebruikers informeren over de beschikbare datareeksen op het Vesper-platform.
- Inhoud: een volledig overzicht van de beschikbare data op het platform.
Met deze data laten de volgende voorbeelden zien hoe de chatbot onze gebruikers nu kan helpen bij zeer specifieke vragen over het platform:

Het belang van de kwaliteit van externe data
Tijdens de ontwikkeling van de chatbot stuitten we op uitdagingen rond de kwaliteit en de structuur van de documenten. Goed geordende documenten van hoge kwaliteit zijn cruciaal, omdat ze rechtstreeks bepalen hoe goed de chatbot accurate informatie kan ophalen en leveren. Slecht gestructureerde of verouderde documenten leiden tot irrelevante of onjuiste antwoorden, wat het vertrouwen van gebruikers schaadt en in het ergste geval meer kwaad dan goed doet.
Daarom hebben we ervoor gezorgd dat alle documenten goed geordend zijn en regelmatig worden bijgewerkt. Dat verbetert niet alleen het ophaalproces, maar zorgt er ook voor dat gebruikers de meest actuele en accurate informatie krijgen. Terwijl we de mogelijkheden van de chatbot blijven uitbreiden, blijft de kwaliteit en relevantie van die documenten een topprioriteit.
Toekomstige ontwikkelingen
Onze huidige chatbot werkt uitstekend en helpt onze gebruikers op allerlei manieren, maar we mikken op nog betere prestaties. We willen de dienst voortdurend verbeteren door de interacties van gebruikers te analyseren. Zo zien we welke soorten vragen er worden gesteld en kunnen we onze verdere ontwikkeling daarop afstemmen. Komen er bijvoorbeeld veel vragen over de actuele stand van de markt, dan kunnen we zoeken naar manieren om onze gebruikers beter van marktinformatie te voorzien.
Een van onze grootste uitdagingen wordt ervoor zorgen dat de chatbot consequent actuele informatie geeft. Dat vraagt om het regelmatig bijwerken van zijn kennisbasis met de nieuwste data, zeker in snel veranderende domeinen. Ons doel is niet alleen dat de chatbot als een echte gesprekspartner aanvoelt, maar ook dat hij altijd de meest actuele en relevante informatie levert. Door daarop te blijven focussen, willen we tijdige hulp bieden bij uiteenlopende onderwerpen, zodat onze gebruikers accurate en bruikbare antwoorden krijgen.
We kijken ernaar uit om deze chatbot te zien uitgroeien tot een werkelijk complete assistent, die niet alleen vragen beantwoordt maar ook marktinzichten levert, persoonlijke aanbevelingen doet en zelfs helpt bij complexe besluitvorming.
Volg de publicaties van Tuğçe Güneş, Machine Learning Engineer bij Vesper, om op de hoogte te blijven terwijl we deze ontwikkeling voortzetten!