Il reinforcement learning, un ambito del machine learning, è forse più noto in relazione ai veicoli autonomi: un’auto impara a guidare per tentativi ed errori e, dopo un milione di volte, sa come affrontare una curva e fermarsi al semaforo rosso. So che è una semplificazione eccessiva, ma il punto è chiaro.
Un’applicazione meno nota del reinforcement learning si trova nel mondo del trading. Molti di noi hanno familiarità con l’applicazione di modelli di machine learning ai dati di serie storiche. In Vesper lo facciamo per prevedere prezzi, produzione e livelli di scorte di varie materie prime agricole per alcuni mesi nel futuro. Questi modelli possono indicare dove sta andando il mercato, ma non possono dirvi quale azione intraprendere in base al loro risultato: gli agenti di reinforcement learning possono dirvi quando vendere, comprare o mantenere i vostri asset in base a come si comporta il mercato. Mentre applicazioni di questo tipo stanno diventando più diffuse nei mercati azionari e forex, non si trovano ancora casi applicati ai mercati delle materie prime.
Insieme a Slimmer AI, noi (il team di Data Science di Vesper) abbiamo passato tre mesi a studiare e sviluppare un agente RL che impara a fare trading sul mercato delle materie prime. Leggete di più su questi cicli di R&S qui!
Questo articolo offre una panoramica dei nostri risultati più importanti. Cominceremo spiegando brevemente il concetto di reinforcement learning, poi passeremo alla definizione di agente di trading e ai vantaggi di usarne uno. Infine discuteremo tre diversi metodi di reinforcement learning e i rispettivi pro e contro.
Un articolo più approfondito sulle specifiche dei nostri agenti e sui loro risultati, oltre a un’introduzione alla libreria usata, si trova qui. Il relativo repository git si trova qui. Ma se siete relativamente nuovi al concetto, continuate a leggere!
Che cos’è il reinforcement learning?
Detto in modo semplice, il reinforcement learning è la pratica di imparare per tentativi ed errori. Il modello impara ricevendo una ricompensa per le decisioni buone e una penalizzazione per quelle cattive. Questo avviene regolando la dimensione di una ricompensa, chiamata segnale di rinforzo, che è positiva o negativa ed è sempre la conseguenza di un’azione intrapresa dall’agente.
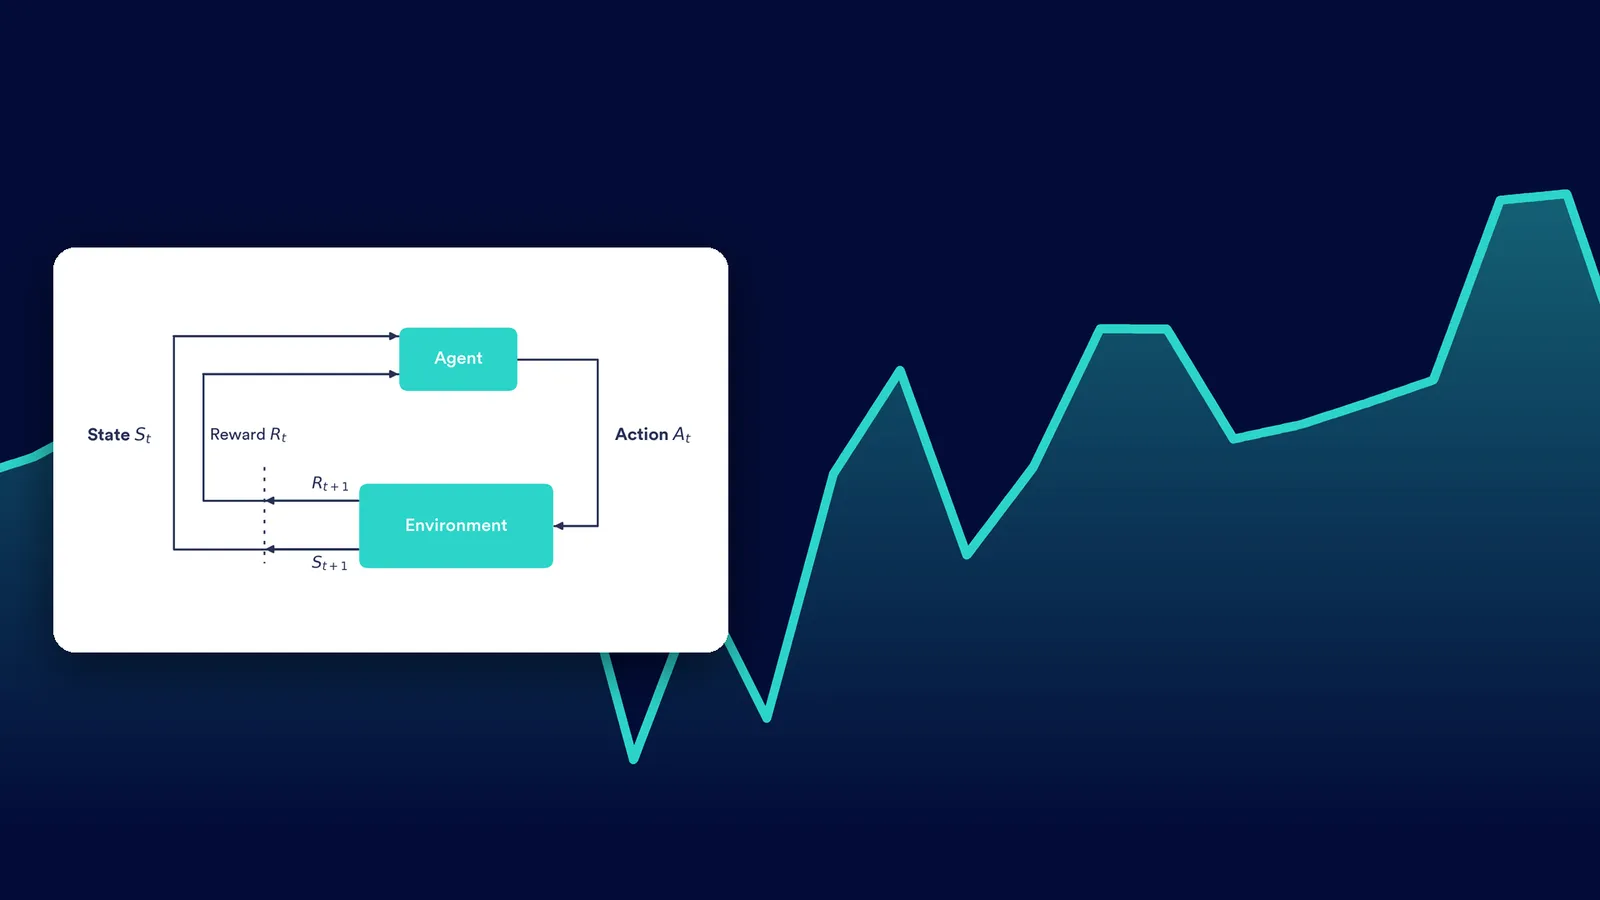
Un modello di reinforcement learning collega un agente a un ambiente attraverso un’azione. Una visualizzazione di questo è mostrata nella figura qui sotto. All’agente vengono date informazioni sullo stato attuale (St) dell’ambiente. In base a queste informazioni, l’agente decide un’azione (At), cambiando lo stato dell’ambiente in St+1. L’azione è scelta dallo spazio delle azioni.
Spazio delle azioni: l’insieme di tutte le azioni a disposizione dell’agente, che l’agente può usare per interagire con il proprio ambiente e modificarlo
La ricompensa o la punizione della transizione di stato è comunicata all’agente tramite il segnale di ricompensa (Rt). Il sistema punta a imparare una strategia d’azione capace di trovare il valore di ricompensa cumulativa più alto dell’ambiente.
Un esempio semplificato di un compito di reinforcement learning nella vita reale è un bambino che impara a camminare: il bambino è l’agente che cerca di muoversi nell’ambiente compiendo azioni sotto forma di camminata o gattonamento. Quando compie qualche passo, il bambino riceve una reazione favorevole dai genitori, che è analoga alla ricompensa. Al contrario, il bambino non riceve alcuna reazione quando gattona o non si muove, il che rappresenta una ricompensa negativa o una punizione.

Che cosa sono gli agenti di trading?
Nel contesto del trading, un agente di reinforcement learning è un trader il cui spazio di azioni consiste nel comprare, vendere o mantenere un asset. Il mercato di cui l’asset fa parte fungerà da ambiente. Lo stato può essere rappresentato sotto forma di statistiche sul mercato attuale, come le medie mobili giornaliere, i massimi e i minimi giornalieri o i volumi scambiati dell’asset. La ricompensa nel trading può essere espressa in termini di profitti, perdite o altre metriche di performance. In definitiva, l’obiettivo dell’agente di trading è agire in modo da massimizzare la ricompensa futura, dato il mercato in cui opera. Un buon agente dovrebbe essere in grado di battere il mercato comprando a livelli di prezzo bassi e vendendo a livelli più alti. Il comportamento dell’agente dipenderà in gran parte dal metodo RL scelto. Tre metodi di uso comune sono discussi nell’ultima sezione, ma prima passiamo rapidamente in rassegna i vantaggi dell’uso degli agenti di trading.
Perché usare gli agenti di trading?
Il trading automatizzato, noto anche come trading algoritmico, comporta l’uso di algoritmi per l’esecuzione degli ordini, ed è l’ambito in cui ricadono gli agenti di trading. Questa forma di trading ha molti vantaggi rispetto al trading umano (manuale). Per prima cosa, va fatta una distinzione fra due tipi di trading automatizzato:
1. Trading automatizzato basato su regole, in cui la strategia è predefinita e progettata da una persona. 2. Trading automatizzato basato sul reinforcement learning, in cui la strategia è appresa tramite il reinforcement learning.
Entrambi i metodi beneficiano dei vantaggi generali del trading automatizzato. I vantaggi sono molti, ma i più importanti sono i seguenti:
- I computer hanno tempi di esecuzione rapidi, il che riduce il rischio di perdere un’opportunità per una reazione lenta allo stato del mercato. - Con il trading automatizzato non siete esposti al rischio di prendere decisioni di trading sbagliate per effetti emotivi e psicologici, qualcosa di cui gli esseri umani soffrono moltissimo. I computer eseguiranno sempre la strategia per cui sono stati progettati. - Il trading automatizzato sfrutta il fatto che i computer sono molto più capaci del cervello umano nel digerire enormi quantità di dati in tempo reale, il che permette strategie ben più complesse.
Se guardiamo ai vantaggi specifici degli agenti di trading che usano il reinforcement learning, possiamo aggiungere questo vantaggio chiave:
- Un agente di trading non smette mai di imparare e di adattare la propria strategia. Una strategia un tempo redditizia può non funzionare quando le dinamiche di mercato cambiano. Un agente di trading con reinforcement learning ben progettato dovrebbe essere in grado di adattare di conseguenza la propria strategia.
Quale metodo scegliere per gli agenti di trading con reinforcement learning?
Come detto in precedenza, esistono metodi diversi per costruire un agente di reinforcement learning. Ci sono tre approcci da usare quando si ha a che fare con il trading finanziario: critic-only, actor-only e actor-critic. Il critic-only, il metodo più usato nell’ambito del trading automatizzato, funziona risolvendo uno spazio di azioni discreto sotto forma di funzione Q-value.
Funzione Q-value: misura della ricompensa totale attesa, assumendo che l’agente si trovi nello stato St e compia l’azione At
Così facendo impara la strategia che massimizza la ricompensa futura dato lo stato attuale. Gli esempi più noti sono il Q-learning e il Deep Q-learning. Il limite principale di questi metodi è che sono progettati per trattare solo problemi con spazio di azioni discreto e finito, il che significa che le azioni che un agente può compiere devono essere predefinite. Per questo servono tecniche speciali per convertirlo in uno spazio continuo, come nel caso dell’acquisto o della vendita di quantità diverse di un prodotto.
Il secondo approccio si chiama actor-only; qui il vantaggio maggiore è che lo spazio di azioni può essere continuo, perché si apprende direttamente una policy sotto forma di distribuzione di probabilità che fornisce una strategia per qualsiasi stato dato.
Policy: mappatura da uno stato St alle probabilità di selezionare ciascuna azione possibile At dato quello stato
Tuttavia, il tempo di addestramento più lungo necessario per ottenere le policy ottimali può essere visto come uno svantaggio di questo approccio.
Il terzo tipo, il framework actor-critic, combina i due e addestra simultaneamente due modelli: l’actor, che impara come far comportare l’agente in un determinato stato, e il critic, che valuta quanto l’azione selezionata sia stata effettivamente efficace. Due algoritmi actor-critic di uso comune sono PPO e A2C. Mentre entrambi i metodi sono molto diffusi nel trading azionario, ci sono alcune differenze fra il mercato azionario e quello delle materie prime da considerare quando si decide il nostro approccio.
La differenza maggiore fra i due mercati è la quantità di dati disponibili. Una difficoltà in cui i ricercatori si imbattono spesso applicando tecnologie di IA al mercato delle materie prime è la sua mancanza di trasparenza e la conseguente scarsità di dati di mercato disponibili. Per fortuna, come piattaforma di commodity intelligence, raccogliere questi dati è il nostro lavoro quotidiano. Il database di Vesper contiene migliaia di serie di dati che coprono, fra le altre cose, prezzi, futures e dati di domanda e offerta di varie materie prime agricole. Un’altra differenza da tenere in conto è la natura dei beni scambiati. Dato che le materie prime agricole sono fisiche per definizione, vanno considerati vincoli aggiuntivi. Pensate alle date di scadenza che obbligano i trader a vendere un prodotto entro una certa data.
In questo articolo abbiamo discusso le basi del reinforcement learning, che cosa sono gli agenti di trading e perché è rilevante applicarli al mercato delle materie prime. Abbiamo discusso anche i vantaggi che ne derivano e quali sono i metodi di reinforcement learning più adatti al nostro caso d’uso. Se vi interessa l’implementazione concreta di questo metodo, date un’occhiata qui, dove mostriamo che gli agenti di trading superano nettamente un modello di riferimento.
Se vi interessa il mercato delle materie prime e il modo in cui usiamo l’IA per rivoluzionarlo, iscrivetevi alla nostra pubblicazione!