O aprendizado por reforço, uma área do machine learning, talvez seja mais conhecido em relação aos veículos autônomos: um carro aprende a dirigir por tentativa e erro e, depois de um milhão de vezes, sabe fazer uma curva e parar no sinal vermelho. Sei que isso é uma simplificação exagerada, mas você entendeu a ideia.
Uma aplicação menos conhecida do aprendizado por reforço está no mundo do trading. A maioria de nós conhece a aplicação de modelos de machine learning a dados de séries temporais. Na Vesper, fazemos isso para prever preços, produção e níveis de estoque de várias commodities agrícolas para alguns meses à frente. Esses modelos indicam para onde o mercado está indo, mas não dizem que ação tomar com base no resultado: os agentes de aprendizado por reforço conseguem dizer quando vender, comprar ou manter seus ativos de acordo com o comportamento do mercado. Aplicações como essa estão ficando mais populares nos mercados de ações e de câmbio, mas ainda não há casos aplicados aos mercados de commodities.
Junto com a Slimmer AI, nós (a equipe de data science da Vesper) passamos três meses pesquisando e desenvolvendo um agente de RL que aprende a negociar no mercado de commodities. Leia mais sobre esses ciclos de P&D aqui!
Este artigo dá um panorama das nossas descobertas mais importantes. Vamos começar explicando brevemente o conceito de aprendizado por reforço, seguido da definição de agente de trading e dos benefícios de usar um. Por fim, vamos discutir três métodos diferentes de aprendizado por reforço e seus respectivos prós e contras.
Um artigo mais aprofundado sobre as especificações dos nossos agentes e seus resultados, além de uma introdução à biblioteca utilizada, pode ser encontrado aqui. O repositório git correspondente pode ser encontrado aqui. Mas, se você é relativamente novo no conceito, continue a leitura!
O que é aprendizado por reforço?
Dito de forma simples, o aprendizado por reforço é a prática de aprender por tentativa e erro. O modelo aprende sendo recompensado por boas decisões e penalizado por decisões ruins. Isso é feito ajustando o tamanho de uma recompensa, chamada sinal de reforço, que é positiva ou negativa e é sempre consequência de uma ação tomada pelo agente.
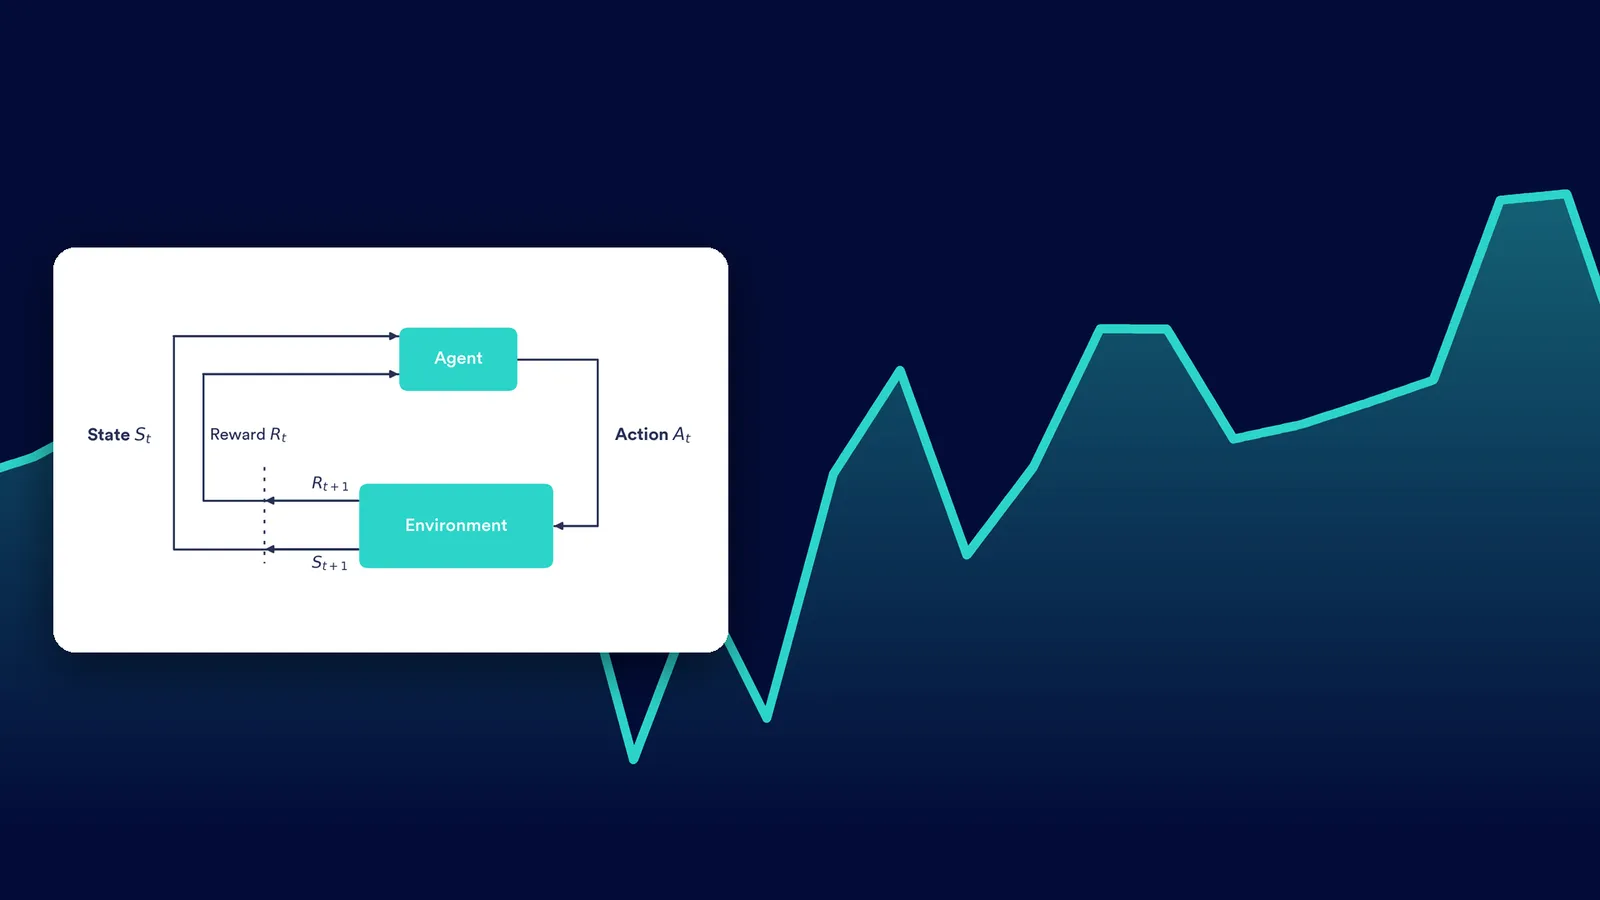
Um modelo de aprendizado por reforço conecta um agente a um ambiente por meio de uma ação. Uma visualização disso é mostrada na figura abaixo. O agente recebe informações sobre o estado atual (St) do ambiente. Com base nessas informações, o agente decide por uma ação (At), mudando o estado do ambiente para St+1. A ação é escolhida dentro do espaço de ações.
Espaço de ações: o conjunto de todas as ações disponíveis ao agente, as quais ele pode usar para interagir com o seu ambiente e modificá-lo
A recompensa ou punição da transição de estado é comunicada ao agente por meio do sinal de recompensa (Rt). O sistema busca aprender uma estratégia de ação que encontre o maior valor de recompensa acumulada do ambiente.
Um exemplo simplificado de uma tarefa de aprendizado por reforço na vida real é uma criança aprendendo a andar: a criança é o agente que tenta navegar pelo ambiente tomando ações na forma de andar ou engatinhar. Quando dá alguns passos, a criança recebe uma reação favorável dos pais, o que é análogo à recompensa. Em contrapartida, a criança não recebe reação alguma ao engatinhar ou ficar parada, o que representa uma recompensa negativa ou punição.

O que são agentes de trading?
No contexto do trading, um agente de aprendizado por reforço é um trader cujo espaço de ações consiste em comprar, vender ou manter um ativo. O mercado do qual o ativo faz parte funciona como o ambiente. O estado pode ser exibido na forma de estatísticas sobre o mercado atual, como médias móveis diárias, máximas e mínimas diárias ou volumes negociados do ativo. A recompensa no trading pode ser expressa em termos de lucro, perdas ou outras métricas de desempenho. No fim das contas, o objetivo do agente de trading é agir de modo a maximizar a recompensa futura, dado o mercado em que ele opera. Um bom agente deve ser capaz de superar o mercado comprando em níveis baixos de preço e vendendo em níveis mais altos. O comportamento do agente vai depender em grande medida do método de RL escolhido. Três métodos de uso comum são discutidos na última seção, mas primeiro vamos passar rapidamente pelos benefícios de usar agentes de trading.
Por que usar agentes de trading?
O trading automatizado, também conhecido como trading algorítmico, envolve o uso de algoritmos para a execução de ordens de negociação; o trading automatizado é o domínio ao qual os agentes de trading pertencem. Essa forma de operar tem muitas vantagens sobre o trading humano (manual). Primeiro, é preciso distinguir dois tipos de trading automatizado:
1. Trading automatizado baseado em regras, em que a estratégia é predefinida e desenhada por um humano. 2. Trading automatizado baseado em aprendizado por reforço, em que a estratégia é aprendida por aprendizado por reforço.
Os dois métodos se beneficiam das vantagens gerais do trading automatizado. São muitos os benefícios, mas os mais importantes são estes:
- Os computadores têm tempos de execução rápidos, o que reduz o risco de perder uma oportunidade por reagir devagar ao estado do mercado. - Com o trading automatizado, você não fica exposto ao risco de tomar decisões ruins por impactos emocionais e psicológicos, algo de que os humanos sofrem enormemente. Os computadores sempre executam a estratégia que foram desenhados para executar. - O trading automatizado se beneficia do fato de os computadores serem bem mais capazes que o cérebro humano de digerir volumes enormes de dados em tempo real, o que permite estratégias muito mais complexas.
Quando olhamos para os benefícios específicos dos agentes de trading que usam aprendizado por reforço, podemos acrescentar este benefício-chave:
- Um agente de trading nunca para de aprender e de adaptar sua estratégia. Uma estratégia que já foi lucrativa pode não funcionar quando a dinâmica do mercado muda. Um agente de trading por aprendizado por reforço bem desenhado deve ser capaz de ajustar a sua estratégia conforme necessário.
Que método escolher para agentes de trading com aprendizado por reforço?
Como mencionado antes, há diferentes métodos para construir um agente de aprendizado por reforço. Há três abordagens a usar quando se lida com trading financeiro: critic-only, actor-only e actor-critic. A critic-only, o método mais usado no domínio do trading automatizado, funciona resolvendo um espaço de ações discreto na forma de uma função de valor Q.
Função de valor Q: medida da recompensa total esperada, assumindo que o agente está no estado St e executa a ação At
Ao fazer isso, ela aprende a estratégia que maximiza a recompensa futura dado o estado atual. Os exemplos mais conhecidos são o Q-learning e o Deep Q-learning. A principal limitação desses métodos é que eles foram desenhados para lidar apenas com problemas de espaço de ações discreto e finito, ou seja, as ações que um agente pode tomar precisam ser predefinidas. Por isso, técnicas especiais precisam ser usadas para converter esse espaço em um espaço contínuo, como no caso de comprar ou vender quantidades diferentes de um produto.
A segunda abordagem se chama actor-only; aqui, o maior benefício é que o espaço de ações pode ser contínuo, já que uma política é aprendida diretamente na forma de uma distribuição de probabilidade que fornece uma estratégia para qualquer estado dado.
Política: mapeamento de um estado St para as probabilidades de selecionar cada ação At possível dado esse estado
No entanto, o tempo de treinamento mais longo necessário para obter as políticas ótimas pode ser visto como uma desvantagem dessa abordagem.
O terceiro tipo, o framework actor-critic, combina os dois e treina simultaneamente dois modelos: o actor, que aprende como fazer o agente se comportar em um determinado estado, e o critic, que avalia quão eficaz a ação selecionada realmente foi. Dois algoritmos actor-critic de uso comum são o PPO e o A2C. Os dois métodos são muito populares quando se olha para o trading de ações, mas há algumas diferenças entre o mercado de ações e o de commodities, e essas diferenças precisam ser consideradas na hora de decidir nossa abordagem.
A maior diferença entre os dois mercados é a quantidade de dados disponíveis. Uma dificuldade que os pesquisadores encontram com frequência ao aplicar tecnologias de IA ao mercado de commodities é a falta de transparência desse mercado e a consequência associada de haver poucos dados de mercado disponíveis. Felizmente, como plataforma de commodity intelligence, coletar esses dados é o nosso trabalho de todo dia. O banco de dados da Vesper contém milhares de séries de dados que cobrem, entre outros, preços, futuros e dados de oferta e demanda de várias commodities agrícolas. Outra diferença a levar em conta é a natureza dos bens negociados. Como as commodities agrícolas são físicas por definição, restrições adicionais precisam ser consideradas. Pense em datas de validade que obrigam os traders a vender um produto antes de uma determinada data.
Neste artigo, discutimos os fundamentos do aprendizado por reforço, o que são agentes de trading e por que é relevante aplicá-los ao mercado de commodities. Também discutimos os benefícios que vêm com eles e quais são os métodos de aprendizado por reforço mais adequados para o nosso caso de uso. Se você tem interesse na implementação concreta desse método, dê uma olhada aqui, onde mostramos que os agentes de trading superam com folga um modelo de referência.
Se você tem interesse no mercado de commodities e em como usamos IA para transformá-lo, assine nossa publicação!