Reinforcement learning, een deelgebied van machine learning, is waarschijnlijk het bekendst van zelfrijdende auto’s: een auto leert rijden met vallen en opstaan en weet na een miljoen pogingen hoe hij een bocht moet nemen en moet stoppen voor een rood stoplicht. Ik weet dat dit sterk vereenvoudigd is, maar je snapt het punt.
Een minder bekende toepassing van reinforcement learning vind je in de handelswereld. De meesten van ons kennen het toepassen van machine-learningmodellen op tijdreeksdata. Bij Vesper doen we dat om de prijzen, productie en voorraadniveaus van verschillende agrarische grondstoffen enkele maanden vooruit te voorspellen. Die modellen kunnen aangeven welke kant de markt op gaat, maar ze kunnen je niet vertellen welke actie je op basis daarvan moet ondernemen: reinforcement learning-agents kunnen je wel vertellen wanneer je je posities moet verkopen, kopen of aanhouden, op basis van hoe de markt zich gedraagt. Toepassingen als deze worden steeds populairder op de aandelen- en forexmarkten, maar voor grondstofmarkten zijn er nog geen voorbeelden te vinden.
Samen met Slimmer AI hebben wij (het Data Science-team van Vesper) drie maanden besteed aan het onderzoeken en ontwikkelen van een RL-agent die leert handelen op de grondstofmarkt. Lees hier! meer over deze R&D-cycli.
Dit artikel geeft een overzicht van onze belangrijkste bevindingen. We beginnen met een korte uitleg van het concept reinforcement learning, gevolgd door de definitie van een trading agent en de voordelen van het gebruik ervan. Tot slot bespreken we drie verschillende reinforcement learning-methoden en de bijbehorende voor- en nadelen.
Een uitgebreider artikel over de specificaties van onze agents en hun prestaties, plus een introductie van de gebruikte library, vind je hier. De bijbehorende git-repository vind je hier. Maar als het concept relatief nieuw voor je is, lees dan vooral verder!
Wat is reinforcement learning?
Simpel gezegd is reinforcement learning leren met vallen en opstaan. Het model leert doordat het wordt beloond voor goede beslissingen en gestraft voor slechte beslissingen. Dat gebeurt door de omvang aan te passen van een beloning, het reinforcement-signaal, dat positief of negatief is en altijd een gevolg van een actie van de agent.
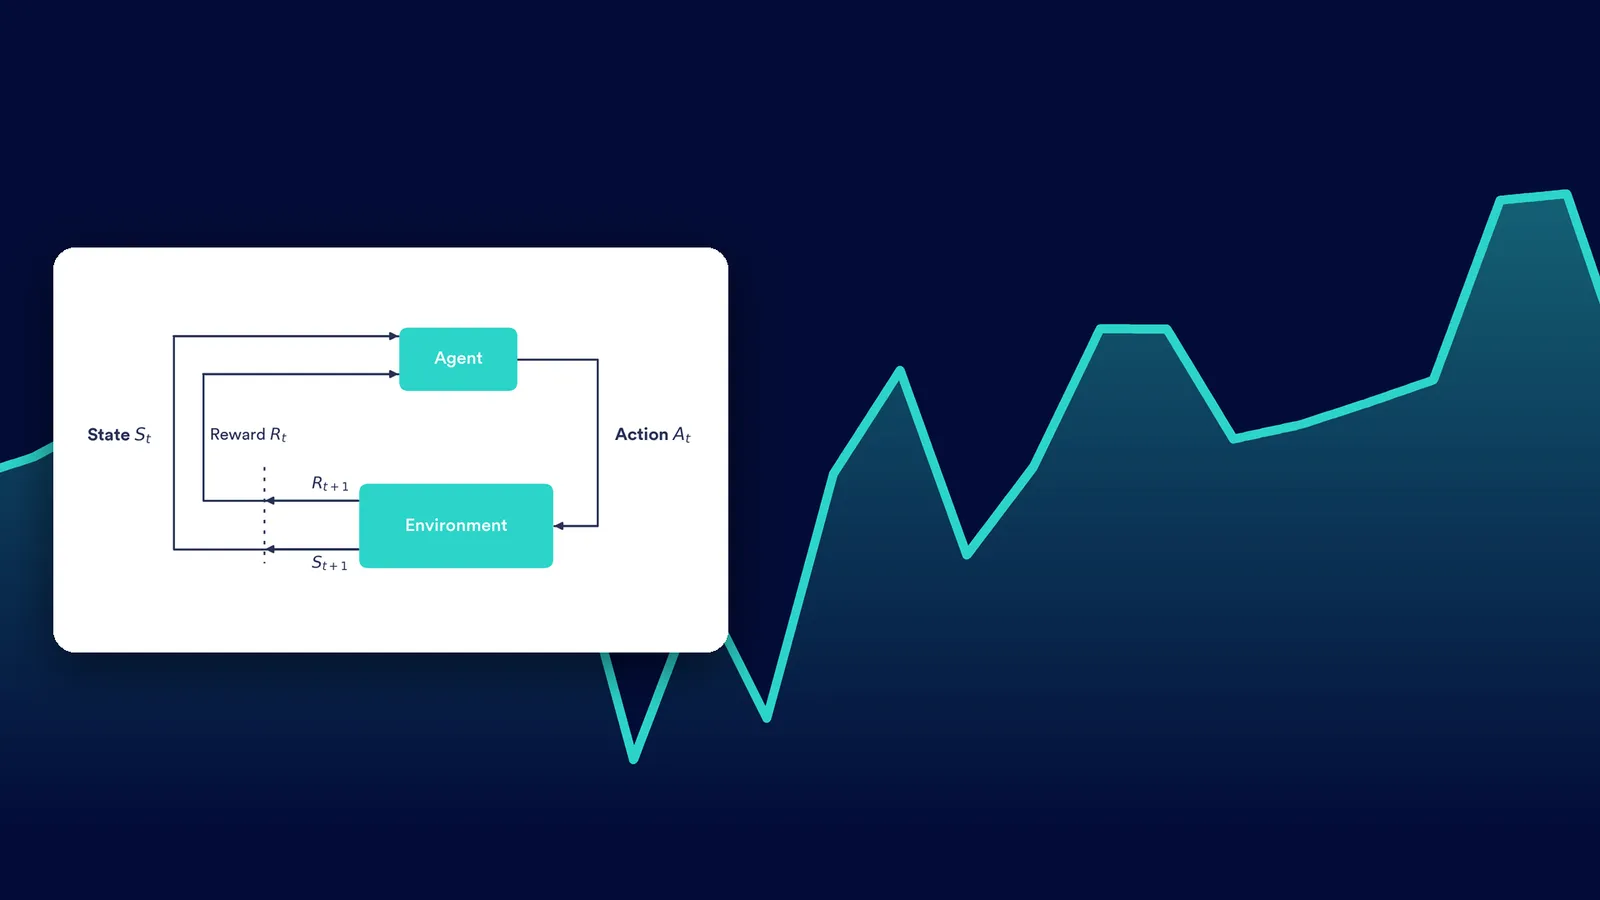
Een reinforcement learning-model verbindt een agent via een actie met een omgeving. Een visualisatie hiervan zie je in de afbeelding hieronder. De agent krijgt informatie over de huidige toestand (St) van de omgeving. Op basis daarvan kiest de agent een actie (At), waardoor de toestand van de omgeving verandert in St+1. De actie wordt gekozen uit de action space.
Action-space: Het geheel van alle voor de agent beschikbare acties, die hij kan gebruiken om met zijn omgeving te interageren en die te veranderen
De beloning of straf voor de toestandsovergang wordt via het reward-signaal (Rt) aan de agent doorgegeven. Het systeem probeert een actiestrategie te leren die de hoogste cumulatieve beloningswaarde in de omgeving vindt.
Een vereenvoudigd voorbeeld van een reinforcement learning-taak uit het echte leven is een kind dat leert lopen: het kind is de agent die door de omgeving probeert te navigeren door acties te ondernemen in de vorm van lopen of kruipen. Als het een paar stappen zet, krijgt het kind een positieve reactie van de ouders, en dat is het equivalent van de beloning. Kruipt het kind daarentegen of beweegt het niet, dan krijgt het geen enkele reactie, en dat staat voor een negatieve beloning of straf.

Wat zijn trading agents?
In de context van handel is een reinforcement learning-agent een handelaar van wie de action space bestaat uit het kopen, verkopen of aanhouden van een asset. De markt waar de asset deel van uitmaakt, fungeert als de omgeving. De toestand kan worden weergegeven als statistieken over de huidige markt, zoals dagelijkse voortschrijdende gemiddelden, dagelijkse hoogte- en dieptepunten of handelsvolumes van een asset. De beloning bij handelen kan worden uitgedrukt in winst, verlies of andere prestatiemaatstaven. Uiteindelijk is het doel van de trading agent om zo te handelen dat hij de toekomstige beloning maximaliseert, gegeven de markt waarin hij opereert. Een goede agent moet de markt kunnen verslaan door te kopen bij lage prijsniveaus en te verkopen bij hogere prijsniveaus. Het gedrag van de agent hangt grotendeels af van de gekozen RL-methode. Drie veelgebruikte methoden bespreken we in het laatste deel, maar eerst lopen we snel de voordelen van trading agents door.
Waarom trading agents gebruiken?
Geautomatiseerd handelen, ook wel algoritmisch handelen genoemd, draait om het gebruik van algoritmen voor het uitvoeren van handelsorders, en dat is het domein waar trading agents onder vallen. Deze vorm van handelen heeft veel voordelen ten opzichte van menselijk (handmatig) handelen. Eerst moet er onderscheid worden gemaakt tussen twee typen geautomatiseerd handelen:
1. Op regels gebaseerd geautomatiseerd handelen, waarbij de strategie vooraf is vastgelegd en door een mens is ontworpen. 2. Geautomatiseerd handelen op basis van reinforcement learning, waarbij de strategie met reinforcement learning wordt geleerd.
Beide methoden profiteren van de algemene voordelen van geautomatiseerd handelen. Er zijn veel voordelen, maar de belangrijkste zijn de volgende:
- Computers hebben snelle uitvoeringstijden, en dat verkleint het risico dat je een kans misloopt door traag te reageren op de toestand van de markt. - Bij geautomatiseerd handelen loop je niet het risico slechte handelsbeslissingen te nemen door emotionele en psychologische invloeden, iets waar mensen enorm veel last van hebben. Computers voeren altijd de strategie uit waarvoor ze zijn ontworpen. - Geautomatiseerd handelen profiteert ervan dat computers veel beter zijn dan het menselijk brein in het verwerken van enorme hoeveelheden data in realtime, wat veel complexere strategieën mogelijk maakt.
Kijken we specifiek naar de voordelen van trading agents die reinforcement learning gebruiken, dan komt daar het volgende belangrijke voordeel bij:
- Een trading agent stopt nooit met leren en met het aanpassen van zijn strategie. Een strategie die ooit winstgevend was, werkt misschien niet meer als de marktdynamiek verandert. Een goed ontworpen reinforcement learning-trading agent moet zijn strategie daarop kunnen aanpassen.
Welke methode kies je voor reinforcement learning-trading agents?
Zoals eerder genoemd zijn er verschillende methoden om een reinforcement learning-agent te bouwen. Bij financiële handel zijn er drie benaderingen: critic-only, actor-only en actor-critic. Critic-only, de meestgebruikte methode in het domein van geautomatiseerd handelen, werkt door een discrete action space op te lossen in de vorm van een Q-value-functie.
Q-value-functie: maat voor de totale verwachte beloning, ervan uitgaande dat de agent zich in toestand St bevindt en actie At uitvoert
Zo leert de methode de strategie die de toekomstige beloning maximaliseert gegeven de huidige toestand. De bekendste voorbeelden zijn Q-learning en Deep Q-learning. Het belangrijkste nadeel van deze methoden is dat ze alleen zijn ontworpen voor problemen met een discrete en eindige action space, wat betekent dat de acties die een agent kan nemen vooraf moeten zijn vastgelegd. Daarom zijn er speciale technieken nodig om de action space om te zetten naar een continue ruimte, zoals bij het kopen of verkopen van verschillende hoeveelheden van een product.
De tweede benadering heet actor-only; het grootste voordeel daarvan is dat de action space continu mag zijn, omdat er direct een policy wordt geleerd in de vorm van een kansverdeling die voor elke toestand een strategie geeft.
Policy: afbeelding van een toestand St naar de kansen om elke mogelijke actie At te kiezen, gegeven die toestand
De langere trainingstijd die nodig is om de optimale policies te verkrijgen, kan echter als nadeel van deze benadering worden gezien.
Het derde type, het actor-critic-raamwerk, combineert beide en traint tegelijk twee modellen: de actor, die leert hoe de agent zich in een bepaalde toestand moet gedragen, en de critic, die beoordeelt hoe effectief de gekozen actie werkelijk was. Twee veelgebruikte actor-critic-algoritmen zijn PPO en A2C. Beide methoden zijn erg populair bij aandelenhandel, maar er zijn enkele verschillen tussen de aandelen- en de grondstofmarkt, en met die verschillen moet je rekening houden bij het bepalen van onze aanpak.
Het grootste verschil tussen de twee markten is de hoeveelheid beschikbare data. Een moeilijkheid waar onderzoekers vaak tegenaan lopen bij het toepassen van AI-technologie op de grondstofmarkt, is het gebrek aan transparantie en het daarmee samenhangende gevolg dat er weinig marktdata beschikbaar zijn. Gelukkig is het verzamelen van die data voor ons als platform voor grondstofinformatie dagelijks werk. De database van Vesper bevat duizenden datareeksen over onder meer prijzen, futures en data over vraag en aanbod van verschillende agrarische grondstoffen. Een ander verschil om rekening mee te houden is de aard van de verhandelde goederen. Omdat agrarische grondstoffen per definitie fysiek zijn, gelden er extra beperkingen. Denk aan houdbaarheidsdata die handelaren dwingen een product vóór een bepaalde datum te verkopen.
In dit artikel bespraken we de basis van reinforcement learning, wat trading agents zijn en waarom ze relevant zijn voor toepassing op de grondstofmarkt. We bespraken ook de voordelen die ermee samenhangen en welke reinforcement learning-methoden het best bij onze toepassing passen. Ben je geïnteresseerd in de feitelijke implementatie van deze methode, kijk dan hier, waar we laten zien dat trading agents een benchmarkmodel ruimschoots verslaan.
Ben je geïnteresseerd in de grondstofmarkt en in hoe we AI inzetten om die markt te ontwrichten, abonneer je dan op onze publicatie!