I team acquisti vogliono previsioni che possano difendere davanti a un direttore finanziario. È un’asticella più alta di un grafico con una linea sopra. Significa sapere che cosa c’è dietro quella linea: quali input usa il modello, da dove arrivano e perché la curva si è mossa stamattina quando ieri non si era mossa.
Questo articolo ripercorre come Vesper costruisce le sue previsioni di prezzo basate sull’intelligenza artificiale, l’architettura, i quattro livelli di input e le fonti di dati che confluiscono in una previsione specifica: il WPC80 istantaneo statunitense, il concentrato di proteine del siero di latte di riferimento usato nella nutrizione sportiva, nelle bevande RTD e negli alimenti arricchiti.
Se la metodologia dietro le previsioni sulle materie prime basate sull’intelligenza artificiale vi è sempre sembrata una scatola nera, questo è l’articolo che la apre.
Leggere una previsione Vesper: che cosa avete davanti

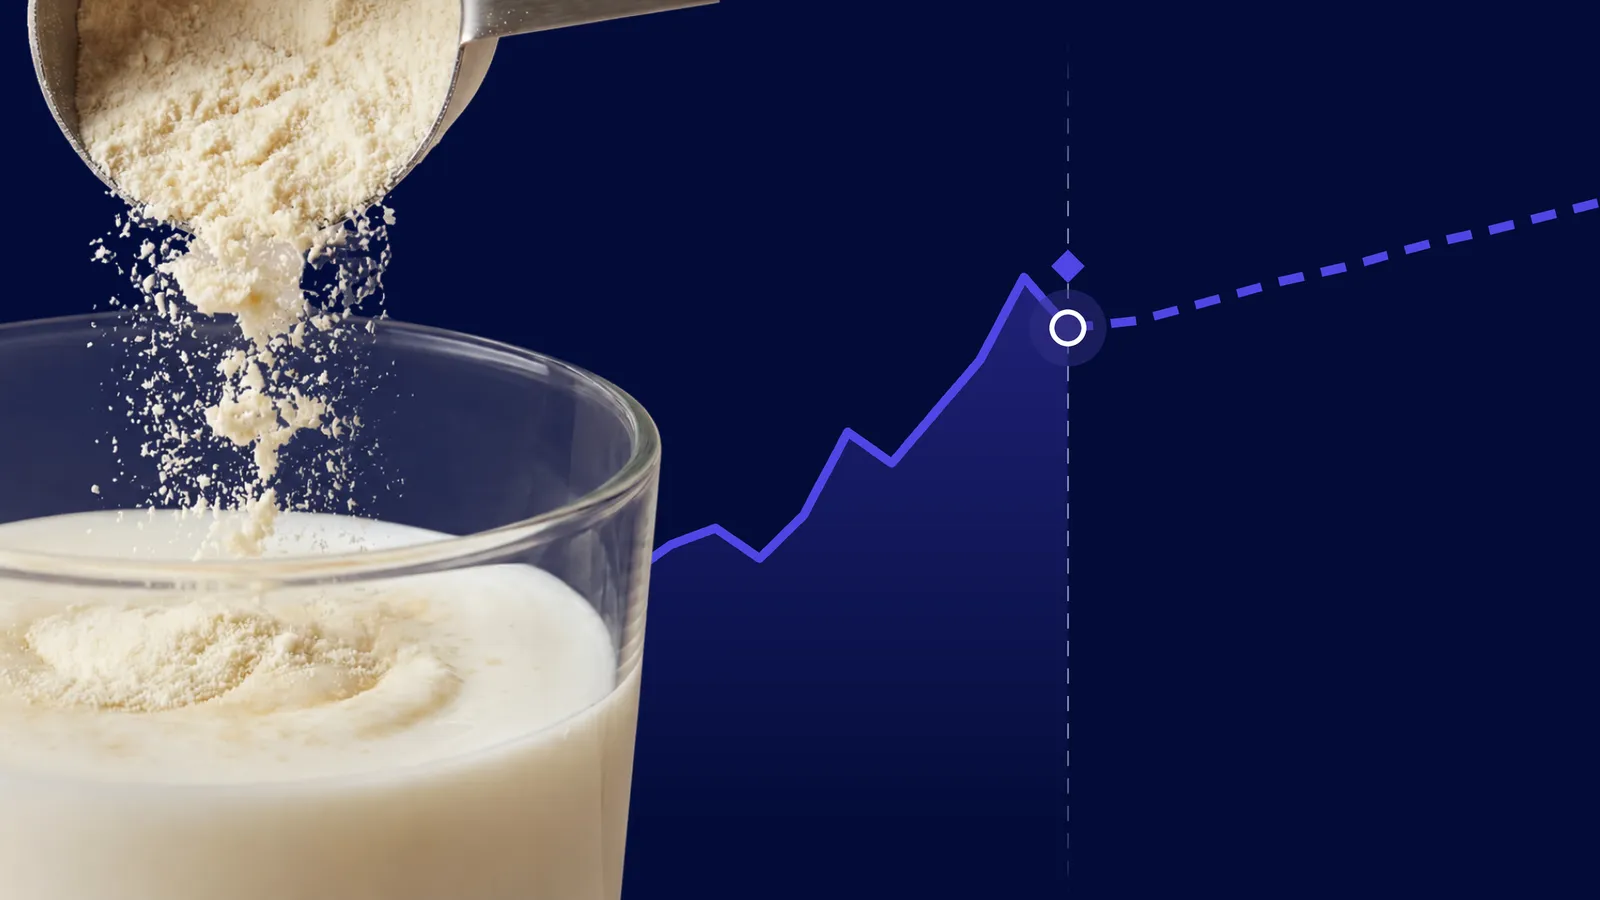
Il grafico qui sopra è il widget di previsione registrato il 29 aprile 2026, per il WPC80 istantaneo statunitense, quotato in USD per libbra, ancorato al benchmark proprietario VPI di Vesper su base EXW. Ci sono quattro elementi da leggere.
La linea blu continua è la serie storica dei prezzi, cioè a quanto il WPC80 istantaneo statunitense ha effettivamente trattato negli ultimi dodici mesi. La linea tratteggiata che riprende dove finisce la serie storica è la curva di previsione dell’intelligenza artificiale, che proietta il prezzo sei mesi in avanti. La banda ombreggiata attorno alla linea tratteggiata è l’intervallo di confidenza, l’area che il modello considera plausibile in ciascun punto della previsione. Più stretta è la banda, più sicuro è il modello.
Passate il cursore su un punto qualsiasi della linea storica e un tooltip mostra due numeri affiancati: il prezzo effettivo a quella data e quello che il modello aveva previsto un mese prima. Il 12 novembre 2025, per esempio, la previsione a un mese del modello era di 6,07 USD/lb contro un dato reale di 6,35 USD/lb, uno scostamento del 4,4%. Il 15 aprile 2026 la previsione era di 10,38 USD/lb contro un reale di 10,80 USD/lb, uno scostamento del 3,9%. Entrambe hanno azzeccato la direzione ed entrambe sono cadute dentro la banda di errore media del modello. È la verifica di accuratezza dentro il prodotto: qualsiasi acquirente può mettere alla prova il modello contro la realtà senza uscire dalla schermata.
Il dato del 96% di accuratezza storica sulla destra riassume quello schema sugli ultimi due anni di previsioni a un mese su questa serie. La metrica è il MAPE (errore percentuale assoluto medio), il che significa che il modello è arrivato in media a circa il quattro percento dal prezzo realizzato. Il selettore vi permette di controllare lo stesso dato di accuratezza sugli orizzonti a tre, sei e dodici mesi; l’accuratezza cala man mano che l’orizzonte si allunga, che è quello che ci si aspetta da qualsiasi modello previsionale onesto.
Su tutte le oltre 4.000 serie di materie prime coperte da Vesper, le medie di piattaforma sono del 97% a un mese, del 94% a tre mesi, del 91% a sei mesi, dell’88% a nove mesi e dell’85% a dodici mesi: il degrado pulito che un modello onesto dovrebbe produrre. Per il WPC80 istantaneo statunitense in particolare, i valori sono del 96% a un mese, dell’88% a tre mesi e dell’80% a sei mesi. Lo scarto fra il WPC80 e la media di piattaforma si allarga man mano che l’orizzonte si allunga, il che è a sua volta informativo: il WPC80 è più volatile della materia prima media coperta da Vesper, quindi qui il modello viene messo alla prova più duramente sugli orizzonti lunghi di quanto accadrebbe, per esempio, su un benchmark più stabile di formaggio o burro.
Veniamo ora alla parte a cui la maggior parte dei potenziali clienti vuole una risposta: come viene tracciata la linea tratteggiata?
L’architettura: i foundation model per le serie storiche
Le previsioni di Vesper sono costruite su foundation model per le serie storiche, un’architettura che rispecchia il funzionamento dei grandi modelli linguistici per il testo, applicata però a dati numerici nel tempo.
I foundation model sono pre-addestrati su insiemi di dati enormi in molti domini prima ancora di vedere la vostra specifica materia prima. Per i modelli linguistici si tratta di miliardi di pagine di testo. Per le serie storiche si tratta di miliardi di punti dato che spaziano fra mercati finanziari, prezzi dell’energia, schemi meteorologici, rese agricole e una lunga lista di altri insiemi di dati temporali. Quando il modello viene messo a punto specificamente sul WPC80 statunitense, ha già imparato che aspetto hanno di solito, dentro i dati di prezzo, gli shock di offerta, la stagionalità, i cicli di domanda e i cambi di regime, anche se prima non aveva mai visto una singola osservazione di WPC80.
È una scelta architetturale significativa. Gli approcci previsionali più vecchi, ARIMA, lo smorzamento esponenziale, i primi modelli di apprendimento automatico, trattano ogni materia prima come un sistema chiuso. Imparano dalla storia di quell’unica serie e la estrapolano in avanti. I foundation model, al contrario, trasferiscono la conoscenza degli schemi fra le serie. È per questo che una previsione su un prodotto relativamente di nicchia come il WPC80 istantaneo, che tratta volumi più bassi rispetto, per esempio, al burro o al latte di Classe III, può comunque attingere a schemi che il modello ha interiorizzato da migliaia di serie collegate e non collegate.
Il modello viene poi arricchito con i dati di addestramento proprietari di Vesper e messo a punto sulle dinamiche specifiche delle materie prime agricole. Il risultato è un livello previsionale trasparente per costruzione: gli utenti possono vedere gli input e le ipotesi che alimentano la curva invece di ricevere un output da scatola nera.
Dove si colloca la previsione Vesper basata sull’intelligenza artificiale nello spettro delle metodologie

Prevedere i prezzi delle materie prime non è una disciplina nuova. I metodi che i team acquisti conoscono si collocano su uno spettro su cui l’approccio a foundation model costruisce, invece di sostituirlo.
Il livello più basilare è quello dei soli fondamentali: bilanci di offerta e domanda, tassi di inflazione, prezzi dell’energia, tassi di cambio, meteo. È lo standard del desk di analisi, e azzecca parecchio. Un livello più avanzato sovrappone gli indicatori tecnici: RSI, bande di Bollinger, MACD, medie mobili, oscillatori stocastici e strumenti simili presi in prestito dai mercati finanziari e applicati alle serie delle materie prime. Entrambi questi livelli possono essere gestiti da persone con fogli di calcolo e attenzione.
La previsione basata sull’intelligenza artificiale parte dove finisce l’approccio umano. Comprende tutto ciò che danno fondamentali e indicatori tecnici, poi aggiunge tre cose che un processo manuale non può raggiungere: correlazioni fra materie prime su migliaia di serie collegate e non collegate, schemi ricavati dalla macchina dentro quelle correlazioni, e indicatori «appresi» che il modello individua da solo, relazioni fra variabili che nessun manuale avrebbe segnalato. È a questo livello che operano le previsioni di Vesper, su più di 4.000 serie di prezzo di materie prime.
Il punto non è che i metodi più vecchi siano sbagliati: sono fondativi. L’intelligenza artificiale li somma, e il guadagno di accuratezza è quello che ci si aspetta quando ogni livello aggiunge informazione nuova.
I quattro livelli di input dietro una previsione
Una volta addestrato, il modello usa quattro categorie di input per produrre la curva a termine. Per il WPC80 istantaneo statunitense, questi livelli hanno questo aspetto.
Schemi di prezzo. Il punto di partenza è la serie stessa, la registrazione storica del WPC80 istantaneo statunitense scambiato sul VPI di Vesper. Attorno a essa il modello legge anche le serie vicine e collegate: WPC 34, WPI, MPC, caseina, lattosio, i prezzi dei blocchi di formaggio statunitensi e il latte di Classe III del CME. Il WPC80 non si scambia isolato. Il siero di latte è un coprodotto della caseificazione, quindi l’economia del formaggio confluisce direttamente nella disponibilità di siero. WPI e WPC 34 sono sostituti su diversi livelli di contenuto proteico; quando gli acquirenti si spostano su o giù lungo la scala proteica, quelle serie si muovono insieme e il modello coglie la relazione.
Fondamentali di mercato. È il livello di offerta e domanda, ed è dove risiede la maggior parte del potere esplicativo. Per le proteine del siero statunitensi il modello assorbe i dati del rapporto USDA NASS Milk Production (mensile), del rapporto USDA Dairy Products (produzione mensile di formaggio, burro, NFDM e siero), del rapporto USDA Cold Storage (scorte di prodotti lattiero-caseari) e i dati export di USDA FAS (dove va il siero statunitense: Cina, Messico e Sud-est asiatico sono i motori dei volumi). Confluiscono anche i dati di produzione dell’UE dell’Osservatorio del mercato del latte europeo e i numeri lattiero-caseari di DCANZ in Nuova Zelanda, poiché l’offerta mondiale influenza il prezzo export statunitense. I costi dei mangimi dalle serie CBOT di granturco, farina di estrazione di soia e DDGS entrano nel modello perché plasmano il margine della produzione di latte, che plasma l’offerta di latte, che plasma a valle l’offerta di siero.
Indicatori tecnici. Il modello legge i segnali tecnici classici applicati alla serie del WPC80: il MACD per il momentum, le medie mobili per la direzione del trend, l’RSI per le condizioni di ipercomprato e ipervenduto, insieme a bande di Bollinger e oscillatori stocastici. Ciascuno di questi è anche esposto direttamente agli utenti dentro la vista di analisi tecnica di Vesper, ma ai fini previsionali alimentano il modello. Non sono decisivi da soli, ma affinano le previsioni a breve orizzonte quando i dati fondamentali sono radi fra un rapporto USDA e l’altro.
Indicatori macro ed economici. Segnali più ampi che influenzano il prezzo delle materie prime fra categorie: l’indice del dollaro statunitense (che plasma la competitività export del siero statunitense), i prezzi dell’energia (un input di produzione rilevante per l’essiccazione a spruzzo del siero) e gli indicatori macro di domanda legati alle categorie degli alimenti funzionali. Dove Vesper ha dati di partner, per esempio i noli di Upply o i dati di costo industriale di IBISWorld, confluiscono anch’essi qui.
Il modello pesa insieme tutti e quattro i livelli. Nessun singolo input detta la curva.
Che cosa sta mostrando il livello tecnico sul WPC80 statunitense in questo momento

Poiché Vesper espone il livello tecnico direttamente nella piattaforma, un acquirente può leggere gli stessi segnali che legge il modello. Per il WPC80 istantaneo statunitense a fine aprile 2026, il quadro è questo.
Il prezzo tratta a 10,90 USD/lb, ben sopra sia la media mobile a 100 giorni (8,81 USD/lb) sia quella a 150 giorni (7,98 USD/lb). Su base annua è in rialzo del 126%. Il segnale MACD è rialzista a +1,2 con il momentum positivo ancora in costruzione. L’RSI segna 100, fortemente ipercomprato, ben oltre la soglia di 70 che di norma segnala un mercato che sta correndo più di se stesso.
Letti insieme, quei segnali descrivono un mercato che ha corso forte, si è disaccoppiato dal proprio trend di medio periodo e ora mostra l’esaurimento tipico di fine ciclo. Che il movimento successivo sia un consolidamento laterale o un ritracciamento più netto, il livello tecnico sta dicendo agli acquirenti che il rialzo residuo si è assottigliato.
È lo stesso quadro che la curva di previsione dell’intelligenza artificiale traccia nel widget: una discesa graduale nei sei mesi successivi, mentre il prezzo rientra verso il trend. Il livello dei fondamentali e il livello tecnico concordano sulla direzione, ed è questo a costruire convinzione nella curva. Se fossero in disaccordo, la previsione rifletterebbe la tensione e la banda di confidenza si allargherebbe.
È qui che gli indicatori tecnici ripagano davvero nel lavoro di acquisto. Non come segnali di trading a sé stanti, ma come verifica di realtà sulla visione dei fondamentali. I fondamentali lattiero-caseari possono sostenere un prezzo più alto; gli indicatori tecnici vi dicono se il mercato lo ha già prezzato.
Da dove arrivano i dati
L’architettura dei dati di Vesper è stratificata di proposito, così che ogni input possa essere ricondotto alla sua fonte. La previsione sul WPC80 statunitense poggia su una pila che va dai dati pubblici di riferimento, passando per i dati in licenza e dei partner, fino ai benchmark proprietari.
Il livello pubblico copre i rapporti USDA, AHDB, ZuivelNL, Kempten e le agenzie equivalenti nelle regioni in cui Vesper opera, le stesse fonti primarie di cui i team acquisti statunitensi già si fidano. Il livello dei futures aggiunge CME (lattiero-caseario, cereali, bestiame), EEX (burro e latte scremato in polvere europei) e NZX (lattiero-caseario neozelandese). Il livello dei partner porta dati in licenza da Oilworld, Fastmarkets, IBISWorld, Barchart, Upply ed Euronext. Il livello proprietario è il Vesper Price Index, benchmark indipendenti per prodotti di nicchia dove non esiste alcuna formazione pubblica del prezzo, compresa la serie del WPC80 istantaneo che ancora questo articolo.
Per una previsione sul WPC80 statunitense in particolare, il VPI è la serie di prezzo principale, il rapporto USDA Dairy Products è il principale segnale di offerta, il latte di Classe III del CME è il principale segnale sull’economia del latte, e il granturco e la farina di estrazione di soia del CBOT ancorano il livello dei costi del mangime. La stessa logica vale per gli oltre 4.000 prodotti coperti da Vesper: materia prima diversa, mix diverso di rapporti pubblici, contratti futures, fonti dei partner e indici proprietari, ma lo stesso principio architetturale.
Perché le visioni dell’intelligenza artificiale e degli analisti restano separate
Una scelta di progettazione merita di essere segnalata: Vesper separa deliberatamente la previsione dell’intelligenza artificiale dal commento degli analisti.
La curva di previsione dell’intelligenza artificiale è, per costruzione, libera da opinioni di analisti. Riflette i dati e solo i dati. Il team di analisti di Vesper produce report di mercato in lingua semplice, il perché dietro il movimento, accanto alla previsione, ma la visione dell’analista non si fonde mai nella curva.
La ragione è la fiducia dei team acquisti. Quando un acquirente chiede che cosa pensa Vesper succederà al WPC80 nei sei mesi successivi, ci sono due risposte, e l’acquirente può vederle entrambe. L’intelligenza artificiale dice una cosa, l’analista ne dice un’altra, e dove concordano la convinzione è alta. Dove divergono, è un segnale per approfondire. I concorrenti che fondono la visione dell’intelligenza artificiale e quella dell’analista in un unico output rimuovono quel segnale, e i team acquisti ci hanno detto ripetutamente che è proprio la separazione a costruire fiducia nella previsione.
Come leggere il grafico per le decisioni di acquisto
Due parti del grafico contano più delle altre quando un acquirente sta dimensionando un impegno a termine: la banda di confidenza sulla curva a termine e i tooltip delle previsioni storiche sulla linea passata.
La banda di confidenza è dove vivono davvero le decisioni di acquisto. Una banda stretta all’inizio dell’orizzonte previsionale che si allarga più avanti è la forma normale: il modello è più sicuro sul mese prossimo che sul terzo trimestre dell’anno prossimo, ed è giusto che sia così. Quando la banda si allarga in modo insolitamente rapido, il modello sta segnalando che gli input stanno mandando messaggi contrastanti e che dovete aspettarvi più revisioni nelle previsioni successive. Quando la banda resta insolitamente stretta, gli input sono allineati e la convinzione è alta. Un acquirente che prende un impegno fisico a termine per il terzo trimestre non sta scommettendo che il prezzo atterrerà esattamente sulla linea tratteggiata centrale: sta dimensionando la copertura rispetto all’intervallo descritto dalla banda.
I tooltip delle previsioni storiche sono il modo in cui la credibilità della banda viene guadagnata sul campo. Che il dato di titolo del 96% significhi davvero qualcosa per il vostro team è molto più facile da giudicare dopo aver verificato a campione cinque o dieci previsioni passate su una serie che comprate davvero. Scegliete qualche mese negli ultimi due anni, passate il cursore sulla linea e leggete la coppia previsto e realizzato. Se il modello ha seguito bene la vostra materia prima, la convinzione necessaria ad agire sulla curva a termine arriva da sé.
Che cosa ne esce
Una previsione sulle materie prime di cui ci si può fidare ha tre cose che lavorano insieme: un’architettura di modello capace di generalizzare fra le serie, una pila di input trasparente che risale a fonti di dati note, e la disciplina di tenere separate la curva dell’intelligenza artificiale e la visione umana dell’analista, così che ciascuna possa essere valutata per quello che vale.